관측을 본 뒤 숨은 값의 분포, 봉우리가 여럿인 데이터 분포처럼 식은 있어도 평균 하나 내기 어려운 분포를 만날 때마다 되풀이하는 일이 있다. 그런 복잡한 분포 p를 다루기 쉬운 분포들의 모임 M 안의 한 점으로 바꿔 놓고 계산하는 것이다. 모임 안의 어느 점을 고를까? 자연스러운 답은 "M 안에서 p에 가장 가까운 점"이다. 그런데 가깝다는 것을 발산으로 재면, 발산에는 방향이 있다. 어느 방향으로 잰 가장 가까운 점일까?
두 방향의 가장 가까운 점
작은 예로 시작하자. p=N(2,1)이고, 모임 M은 평균이 0으로 고정된 정규분포 N(0,σ2)들이다. 이 모임을 고른 까닭은 둘이다. 다이얼이 σ2 하나뿐이라 후보를 한 줄로 늘어놓고 가장 가까운 점을 찾을 수 있고, p의 평균이 2라서 p가 모임 밖에 있으니 두 방향이 갈린다. M 안의 후보 두 개를 두 방향으로 재 보면 다음과 같다.
후보 q
D(p∣q)
D(q∣p)
N(0,1)
2.00
2.00
N(0,5)
0.80
3.20
p = N(2, 1)(초록)과 평균 0인 두 후보 N(0, 1)(점선), N(0, 5)(실선). N(0, 1)은 p와 폭이 같지만 p가 있는 곳에서 비켜나 있고, N(0, 5)는 넓게 퍼져 p가 있는 곳까지 덮는다
σ2를 모든 양수 값으로 바꿔 가며 재 보면, D(p∥q)는 σ2=5에서 가장 작고(0.80) D(q∥p)는 σ2=1에서 가장 작다(2.00). 같은 p, 같은 M인데 가장 가까운 점이 둘이다. D(p∥q) 쪽은 p가 있는 곳(평균 2 근처)까지 덮으려고 넓게 퍼진다. 실제로 N(0,5)는 x2의 평균이 5로 p와 같다(1+22=5). D(q∥p) 쪽은 p가 거의 없는 곳에 확률을 흘리기 싫어서 좁게 머문다.
이렇게 발산을 가장 작게 하는 M 위의 점을 찾는 일을 사영 (가장 가까운 점 찾기 / Projection, Π, 대문자 파이)이라 한다. q∗=argminq∈MD(p∥q)처럼 p를 앞에 두고 재는 쪽을 m-사영, argminq∈MD(q∥p)처럼 p를 뒤에 두고 재는 쪽을 e-사영이라 부른다. 위 예에서 N(0,5)가 m-사영, N(0,1)이 e-사영이다.
두 이름의 m과 e는 두 종류의 “직선”, 곧 측지선(그 공간에서 가장 곧은 길)에서 왔다. m-측지선은 두 분포를 섞은 (1−t)p+tq들이 이루는 길이고, e-측지선은 로그를 섞은 logrt=(1−t)logp+tlogq+상수가 이루는 길이다. m-사영에서는 p와 사영점을 잇는 m-측지선이 M에 직교하고, e-사영에서는 e-측지선이 직교한다.
사영점이 하나뿐인지는 M의 모양에 달려 있다. 위의 M에서 두 점 N(0,1)과 N(0,5)를 반씩 섞어 보자. 봉우리는 하나지만 꼬리가 두꺼워서, 정규분포라면 늘 3인 첨도(x4의 평균을 x2의 평균의 제곱으로 나눈 값)가 39/9≈4.33이 된다. 섞는 길(m-측지선)은 M 밖으로 나간다. 이번에는 로그를 섞어 보자. 두 분포의 로그는 −x2/2와 −x2/10에 상수를 더한 것이라, 반씩 섞으면 −0.3x2+상수, 곧 다시 평균 0인 정규분포 N(0,5/3)이 된다. 로그를 섞는 길(e-측지선)은 M 안에 머문다. 이렇게 두 점을 잇는 e-측지선이 늘 M 안에 머물면 M이 e-평탄하다고 하고, m-측지선이 그러면 m-평탄하다고 한다. 위의 M은 e-평탄하지만 m-평탄하지는 않다. exp(θ⋅x−ψ) 꼴로 쓰이는 분포들의 모임(지수족)은 늘 e-평탄하다. M이 e-평탄하면 m-사영은 하나뿐이고, 평균 같은 기댓값을 p와 맞추는 점이 된다. 위 표의 N(0,5)가 x2의 평균을 p와 맞춘 것이 그 예다. M이 m-평탄하면 거꾸로 e-사영이 하나로 정해진다.
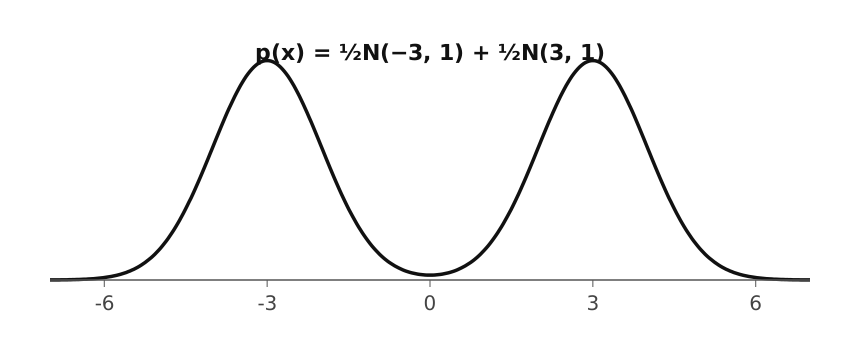
출발 문제의 물음으로 돌아가 보자. 봉우리가 둘인 p를 정규분포 하나로 근사하면, 두 방향의 가장 가까운 점은 각각 어디에 놓일까? 아래 문제 6에서 직접 계산한다.
ML에서: 변분추론은 e-사영
변분추론(variational inference)은 이 틀로 이해된다. 참 사후분포 p(관측을 본 뒤 숨은 값의 분포)는 계산하기 어려워서, 다루기 쉬운 분포족 Q 위에서 p에 가장 가까운 점을 D(q∥p)로 재어 찾는다. 근사 분포 q를 앞에 둔 방향(영어로 reverse KL)으로 재므로 e-사영이다. 실제로는 D(q∥p)를 바로 계산할 수 없어서 증거 하한(ELBO, evidence lower bound: 관측의 로그확률보다 늘 작거나 같은 값)을 최대화한다. 둘은 logp(x)=ELBO(q)+D(q∥p) 한 줄로 이어진다. 왼쪽의 관측 로그확률은 q와 상관없으므로 ELBO를 키우는 것이 곧 D(q∥p)를 줄이는 e-사영이다. 여기서 움직이는 것은 근사 분포 q의 매개변수다.
D(p∥q)를 줄이는 쪽은 평균 같은 기댓값을 p와 맞춘다고 했죠. 평균은 좌우대칭이라 0이고, 분산은 봉우리 둘 다 1이니까 1. q=N(0,1)이요.
이서연
난 다르게 나왔어. D(p∥q)=−H(p)−Ep[logq]이고 앞 항은 q와 상관없으니까, Ep[logq]만 키우면 돼. 정규분포면 이건 평균과 분산을 p와 맞추는 건데, p의 분산은 봉우리 안의 퍼짐 1에 봉우리 중심이 0에서 3씩 떨어진 몫 9가 더해져. μ=0, σ2=1+9=10.
선생님
민준 학생, 서연 학생의 q=N(0,10)과 민준 학생의 q=N(0,1) 중에 어느 쪽이 D(p∥q)가 작을지, 한 번 돌려 볼래요?
김민준
수치적분 해 보니까… N(0,10)은 0.46인데, N(0,1)은 3.8이 나와요. 봉우리가 있는 ±3 근처에서 q가 거의 0이라 logqp가 폭발하네요.
선생님
그게 D(p∥q)의 성격이에요. p가 있는 곳에서 q가 0에 가까우면 벌점이 무한히 커지니까, q는 p가 있는 곳을 전부 덮으려고 넓게 퍼져요. 분산을 맞춘다는 건 봉우리 하나의 폭이 아니라 봉우리 사이의 거리까지 맞춘다는 뜻이에요.
김민준
그러니까 이건 평균이랑 분산을 맞추는 사영이고… 앞에서 본 m-사영이네요. 정규분포족이 지수족이라 답이 하나로 정해지고요.
이서연
(나)는 쉬워 보여. 문제가 좌우대칭이니까 답도 좌우대칭이어야지. μ=0으로 두고 σ만 최적화하면 σ≈2.74, 발산은 0.84.
선생님
대칭인 문제의 답은 반드시 대칭이어야 할까요? 서연 학생 식으로 μ를 조금 옮겨서 μ=3, σ=1을 넣어 보면요?
이서연
D(q∥p)가… 0.69? 내 답 0.84보다 작아. 대칭인 점보다 한쪽으로 치우친 점이 더 좋다니, 이상한데.
이서연
아, 대칭인 건 답 하나가 아니라 답들의 모임이구나. μ≈2.98이 최소라면, 거울에 비친 μ≈−2.98도 최소야. 최소점 두 개가 서로를 비추고 있으니까 모임은 대칭이지만, 점 하나하나는 대칭일 필요가 없어.
선생님
그래서 D(q∥p)는 q가 p가 없는 곳에 확률을 두는 걸 싫어해요. 골짜기에 확률을 쏟느니 봉우리 하나를 확실히 잡는 거죠. 이게 e-사영이고, 변분추론이 사후분포의 봉우리 하나만 잡는 경향이 있는 이유예요. 정규분포족은 m-평탄하지 않아서 e-사영이 하나로 안 정해지는 것도 여기서 보이고요.
김민준
그럼 (가)는 봉우리를 다 덮는 넓은 분포, (나)는 봉우리 하나에 붙는 좁은 분포. 출발 문제에서 물은 게 이거였네요.
이서연
미적분 시간에 f(x)=x4−2x2의 최솟값을 구할 때도 그랬어요. 좌우대칭인 함수인데 최솟값은 x=±1 두 곳이고, 대칭인 자리 x=0은 오히려 극대였죠. 알면서도 똑같은 함정에 빠졌네요.
선생님
대칭은 답을 하나로 정해 주는 게 아니라 답들을 짝지어 줄 뿐이에요. 둘 다 잘 찾아냈어요.
문제 6의 두 답. 초록은 p, 실선은 (가)의 N(0, 10)으로 두 봉우리와 골짜기를 함께 덮는다. 점선은 (나)의 최소점(평균 약 2.98, 표준편차 약 1.02)으로 오른쪽 봉우리에 붙고, 흐린 점선은 같은 값을 갖는 거울 쪽 최소점이다