로짓 렌즈: 층마다 무슨 토큰을 떠올리고 있나
기여는 평균이어서 한 문장 안에서 무슨 일이 일어나는지는 보여 주지 않는다. 한 문장의 한 위치에서, 층 3 을 지난 h 는 무슨 토큰을 떠올리고 있을까? 마지막 h 는 층 정규화를 하고 언임베딩 행렬을 곱하면 로짓이 되는데, 같은 계산을 중간 층의 h 에 걸면 어떻게 될까?
역사: 필명의 블로그 글 하나
2020년 8월 31일, nostalgebraist 라는 필명을 쓰는 글쓴이가 LessWrong 에 「GPT 해석하기: 로짓 렌즈(interpreting GPT: the logit lens)」를 올렸다. 블로그 글에 담긴 생각은 중간 층의 상태에 마지막 출력 행렬을 그대로 곱해 보자는 것이었다. 층들은 그렇게 읽히도록 학습되지 않았으니 의미 없는 토큰만 나올 수도 있었는데, GPT-2 의 가장 큰 판(48층)에서 층마다 그럴듯한 다음 토큰 분포가 나왔고 깊어질수록 마지막 출력에 가까워졌다. 글쓴이는 흔한 흐름을 「알아볼 수 없는 것, 품사와 말투만 맞는 얕은 추측, 더 나은 추측」으로 적었고, 앞 글을 베껴 쓰는 드문 토큰은 마지막 몇 층에서야 위로 올라온다고 적었다. 그는 로짓으로 읽는 것이 상태가 담은 것의 일부일 뿐이라는 단서도 스스로 달았다.
이 방법이 늘 통하지는 않는다. 2023년 튠드 렌즈(tuned lens) 논문은 GPT-Neo, BLOOM, OPT 125M 같은 모델에서 로짓 렌즈가 잘 되지 않고, BLOOM 과 OPT 125M 에서는 절반이 넘는 층에서 렌즈의 1위가 입력 토큰인 일이 잦았다고 보고했다. 그러니 우리 루나에서 렌즈가 읽히는지는 먼저 측정해 봐야 안다.
작은 로짓 렌즈
중간 층의 h 에 층 정규화와 언임베딩 행렬을 그대로 걸어 토큰 확률로 읽는 것을 로짓 렌즈 (중간 층의 벡터를 마지막 출력 계산에 바로 넣어 보기 / logit lens)라 한다. 학습할 것이 없어서 코드는 한 줄이다.
# sources/layers/common_layers.py 에서 발췌
def lens(m, h):
    return m.lm_head(m.ln_f(h))
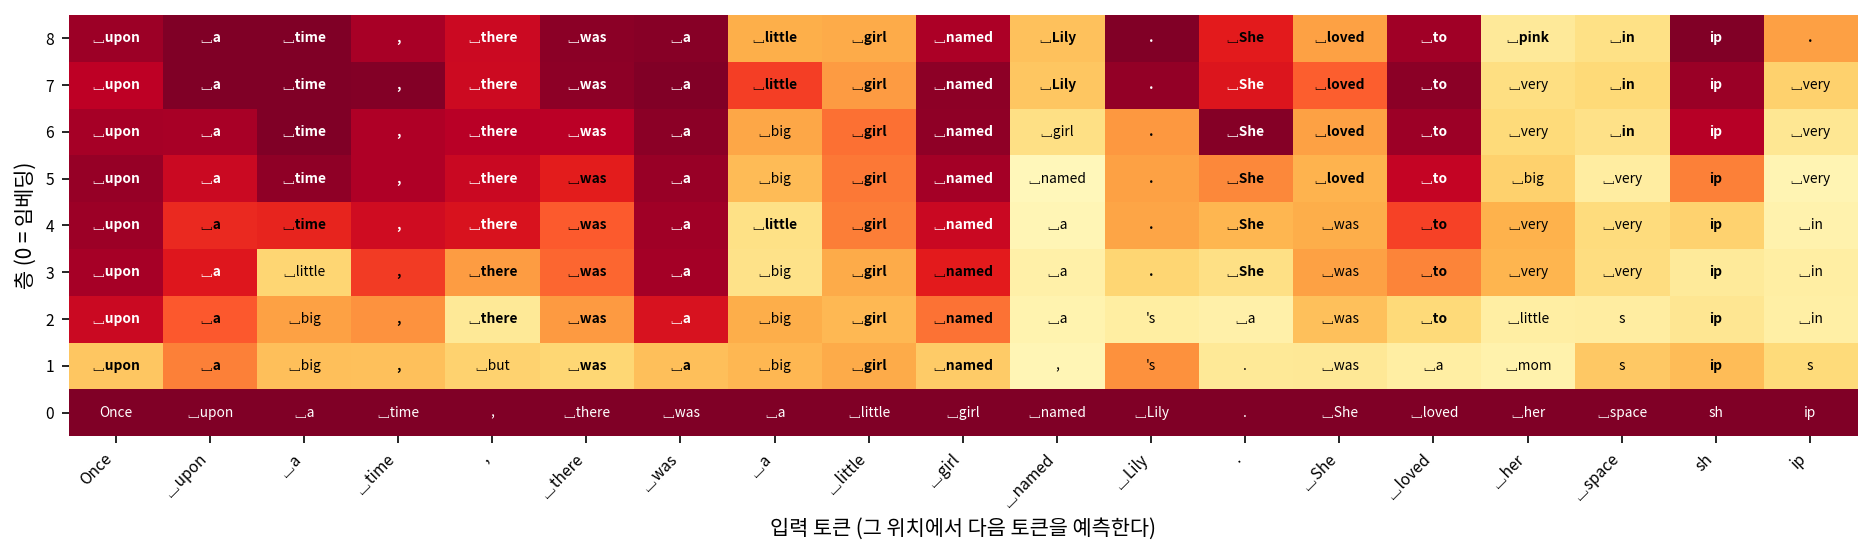
동화 GPT 에게 시작 문장 넷을 주고 문장 끝 위치를 층마다 읽었다(sources/layers/lens_table.out). 층 0 은 임베딩이고, 층 8 은 모델의 실제 출력이다.
### 'Tom and Lily went to the park. Tom gave the ball to'
  층 0: ␣to 1.000, ␣for 0.000, ␣and 0.000
  층 1: ␣the 0.247, ␣a 0.140, ␣have 0.038
  층 2: ␣a 0.231, ␣the 0.224, ␣his 0.038
  층 3: ␣a 0.291, ␣the 0.152, ␣his 0.115
  층 4: ␣a 0.342, ␣the 0.112, ␣his 0.092
  층 5: ␣a 0.403, ␣the 0.160, ␣his 0.059
  층 6: ␣a 0.324, ␣the 0.274, ␣his 0.125
  층 7: ␣Lily 0.709, ␣the 0.144, ␣a 0.091
  층 8: ␣Lily 0.745, ␣the 0.209, ␣a 0.018

### 'The sky was blue and the grass was'
  층 1: ␣a 0.169, ␣not 0.162, ␣still 0.078
  층 3: ␣very 0.510, ␣so 0.088, ␣not 0.067
  층 5: ␣very 0.587, ␣so 0.065, ␣a 0.020
  층 6: ␣green 0.312, ␣very 0.262, ␣soft 0.103
  층 8: ␣green 0.512, ␣soft 0.126, ␣dry 0.043

### 'One, two, three, four,'
  층 1: ␣but 0.239, ␣Tim 0.077, ␣and 0.064
  층 5: ␣and 0.285, ␣then 0.045, ␣went 0.037
  층 6: ␣and 0.512, ␣five 0.090, ␣the 0.029
  층 7: ␣five 0.185, ␣and 0.182, ␣the 0.062
  층 8: ␣five 0.444, ␣and 0.233, ␣four 0.061

### 'Mom said, "Do not touch the hot'
  층 1: , 0.217, ␣and 0.083, ␣sun 0.065
  층 5: , 0.150, ␣sun 0.095, ␣dog 0.074
  층 7: ␣thing 0.136, ␣sun 0.100, ␣water 0.057
  층 8: ␣stove 0.172, ␣oven 0.133, ␣pot 0.072
층 0 은 네 문장 모두 입력 토큰 자신이다. 언임베딩 행렬이 임베딩 행렬과 같아서, 자기 임베딩과의 내적이 대개 가장 크기 때문이다. 층 1 부터는 입력 토큰을 떠나 다음에 올 만한 토큰을 말하는데, 층 1~5 는 「␣the」, 「␣a」, 「␣very」처럼 문법만 맞는 낱말이고 답은 뒤쪽에서 나타난다. 「Lily」는 층 6 까지 상위 3 에 없다가 층 7 에서 0.709 로 올라오고, 「green」은 층 6 에서, 「five」는 층 6 에서 2위로 나타나 층 7 에서 앞선다. 「stove」는 마지막 층에서야 처음 나온다. 이 층 번호는 우리 체크포인트의 값이고 체크포인트마다 다를 수 있다.

층 5 의 루나는 공 받을 사람을 「a」라고 생각했네. 받을 사람도 없이 그냥 관사.
층 7 에서 갑자기 Lily 야. 8층 GPT 에서 베끼는 헤드라고 약하게 찾은 게 층 5 헤드 7 이랑 층 6 헤드 8 이었잖아. 그 뒤 층에서 이름이 나타나네.

그 헤드가 올려 줬다는 뜻이야?

그건 모르지. 무작위 반복 글에서는 층 6 헤드 8 을 지우면 베끼기가 크게 나빠지는 걸 봤지만, 이 문장에서 Lily 를 올린 게 그 헤드인지는 이 문장으로 지워 봐야 알아.
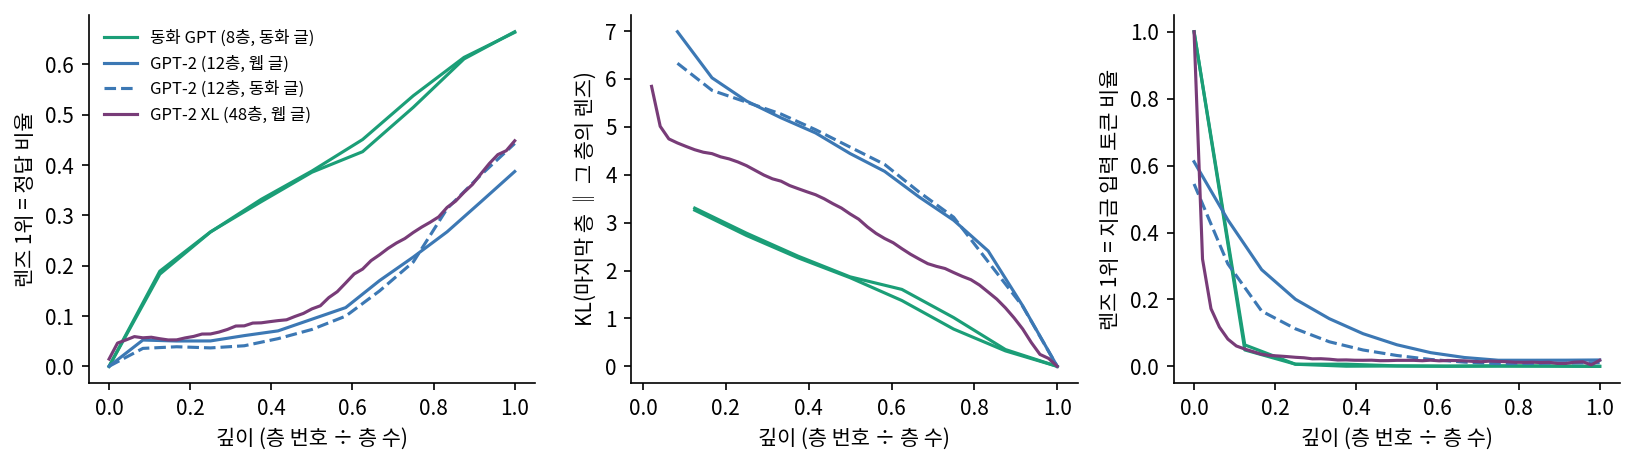
검증 글 전체로 측정하면 렌즈가 어느 정도 믿을 만한지 나온다. 층 1 의 렌즈 1위가 실제 정답인 비율은 0.183 이고, 층마다 0.267, 0.332, 0.388, 0.451, 0.538, 0.614 로 오르다 마지막 층에서 0.664 가 된다. 마지막 층과의 KL 발산은 3.260 에서 0 으로 고르게 줄어든다. 동화 GPT 에서는 로짓 렌즈가 읽힌다고 말할 수 있고, 입력 토큰을 그대로 말하는 비율은 층 1 에서 벌써 0.064, 층 2 부터는 0.006 이하로 떨어진다.
GPT-2 를 같은 렌즈로
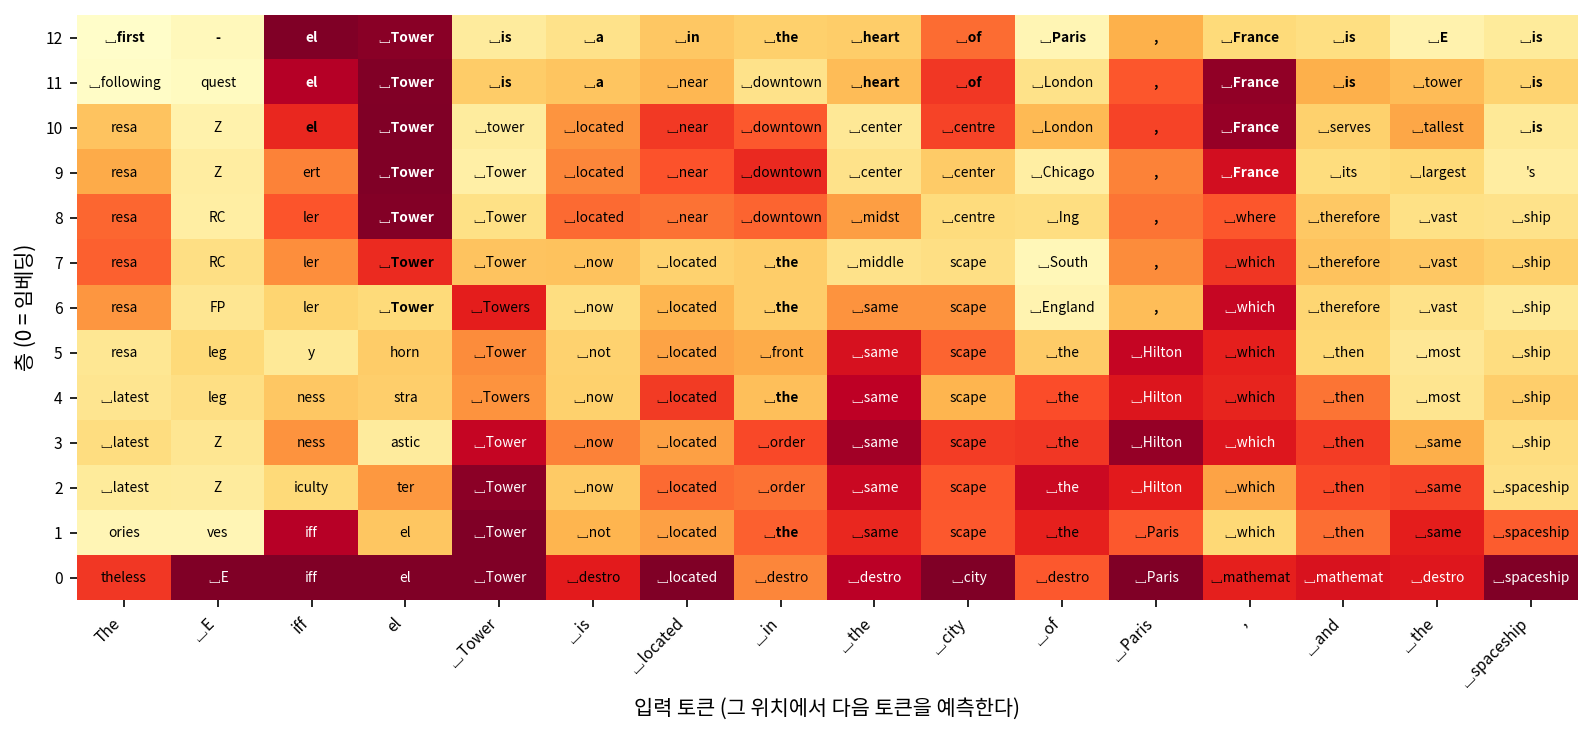
12층의 GPT-2 에서는 도시 이름이 좁혀지는 과정이 보인다.
### 'The Eiffel Tower is located in the city of'
  층 0: ␣destro 0.603, ␣mathemat 0.259, ␣challeng 0.117
  층 1: ␣the 0.733, ␣course 0.054, ␣a 0.029
  층 5: ␣the 0.295, ␣La 0.075, ␣course 0.041
  층 6: ␣England 0.079, ␣La 0.048, ␣the 0.039
  층 7: ␣South 0.055, ␣Georgia 0.054, ␣East 0.052
  층 8: ␣Ing 0.215, ␣San 0.059, ␣Chicago 0.043
  층 9: ␣Chicago 0.114, ␣Rome 0.094, ␣London 0.081
  층10: ␣London 0.351, ␣Amsterdam 0.161, ␣Paris 0.155
  층11: ␣London 0.195, ␣Paris 0.137, ␣Amsterdam 0.125
  층12: ␣Paris 0.069, ␣London 0.069, ␣Amsterdam 0.040
층 1~5 는 「␣the」라고 하다가 층 6 부터 지명을 말하기 시작하는데 처음에는 잉글랜드이고 시카고, 런던을 거쳐 마지막 층에서 파리가 된다. 지명이라는 종류가 먼저 정해지고 어느 도시인지는 뒤에서 좁혀지는 것처럼 보인다. 다만 층 8 의 1위 「␣Ing」처럼 뜻을 알 수 없는 조각도 끼어 있고, 마지막 층에서도 「␣Paris」와 「␣London」이 0.069 로 나란하니 렌즈의 확률을 모델의 믿음으로 읽으면 안 된다. 층 0 의 「␣destro」, 「␣mathemat」도 입력과 상관없는 조각인데, GPT-2 의 층 0 은 렌즈가 잘 맞지 않는 자리라서 이 줄은 읽지 않는다.
검증 글에서 GPT-2 렌즈의 정답 비율은 층 1~4 까지 웹 글 기준 0.05 안팎에 머물다 층 8 이 0.170, 층 12 가 0.387 이다. 렌즈가 앞쪽 층에서 잘 읽히지 않고, 입력 토큰을 그대로 말하는 비율도 층 1 에서 0.438, 층 3 에서 0.201 로 오래 남는다. 같은 렌즈인데 동화 GPT 보다 앞쪽 층이 입력에 오래 붙어 있다.
문제 3. 추리 소설을 읽다 덮고 범인 말하기
추리 소설을 다섯 장 읽을 때마다 책을 덮고 범인을 적어 내는 놀이를 했다. 어떤 친구의 답은 「모름, 모름, 집사, 집사, 조카」였고, 마지막 장에서 밝혀진 범인은 조카다. (가) 셋째 장에서 「집사」라고 쓴 친구의 머릿속에 조카에 대한 단서가 없었다고 말할 수 있는가? (나) 이 놀이와 로짓 렌즈는 어떤 점이 같고 어떤 점이 다른가?
(가)는 말 못 하지. 조카가 수상하다고 생각하면서도 지금 하나만 꼽으라면 집사일 수 있잖아. 답 하나로는 머릿속을 다 못 봐.
(나)에서 같은 점은, 읽다 말고 지금까지의 생각으로 답을 내게 하는 거. 다른 점은… 사람은 「지금 답을 써」라고 하면 답을 쓰려고 생각을 정리하잖아. 렌즈는 층한테 묻는 일 없이 그 층의 벡터에 마지막 계산을 그냥 건 거고.

맞아요. 층은 렌즈에 읽히려고 학습된 적이 없어요. 뒤 층이 읽을 메모를 적었는데 우리가 그 메모를 답안지 채점기에 넣은 것이죠.

그럼 렌즈로 읽히면 있다는 증거가 되는데, 안 읽힌다고 없다는 증거는 안 되겠네요.