대가는 어디에서 오나: 스텝, 데이터 믹스, 모델 크기
문제 2. 대가는 어디에서 오는가
변형 이야기 3,000 편을 섞은 루나는 cannot 을 83% 맞히지만 yes·no 에서 10%p 를 잃었다. 원인의 후보는 셋이다. (가) 데이터 믹스: 넣는 양이 15% 로 정해져 있어서 이야기가 다른 문항의 자리를 가져간다. (나) 모델 크기: 26M 파라미터로는 두 가지를 함께 익히기에 모자란다. (다) 학습 스텝: 14,000 스텝으로는 새로 넣은 이야기를 다 익히지 못했다.
한 번에 한 조건만 바꾼다. 같은 데이터로 스텝만 두 배, 프로그램 문항의 양만 기준 판과 같게, 모델만 3.3 배(87M). 셋 가운데 무엇이 yes·no 를 되찾고, 무엇이 변별력을 올릴까?

(다) 에 걸게. 이야기 3,000 편을 여덟 번씩 넣었는데 스텝은 그대로잖아. 두 배로 하면 둘 다 익히겠지.

스텝은 이미 연 칸을 익히는 데만 쓰일 것 같아. 기준 판에 스텝만 주면 깊은 칸은 안 오를 거고.
변별력이 그대로였잖아요. 변별력을 올리는 조건이 진짜 원인이고, 판단 기준만 바꾸는 조건은 얻는 것과 잃는 것을 맞바꿀 뿐일 거예요.
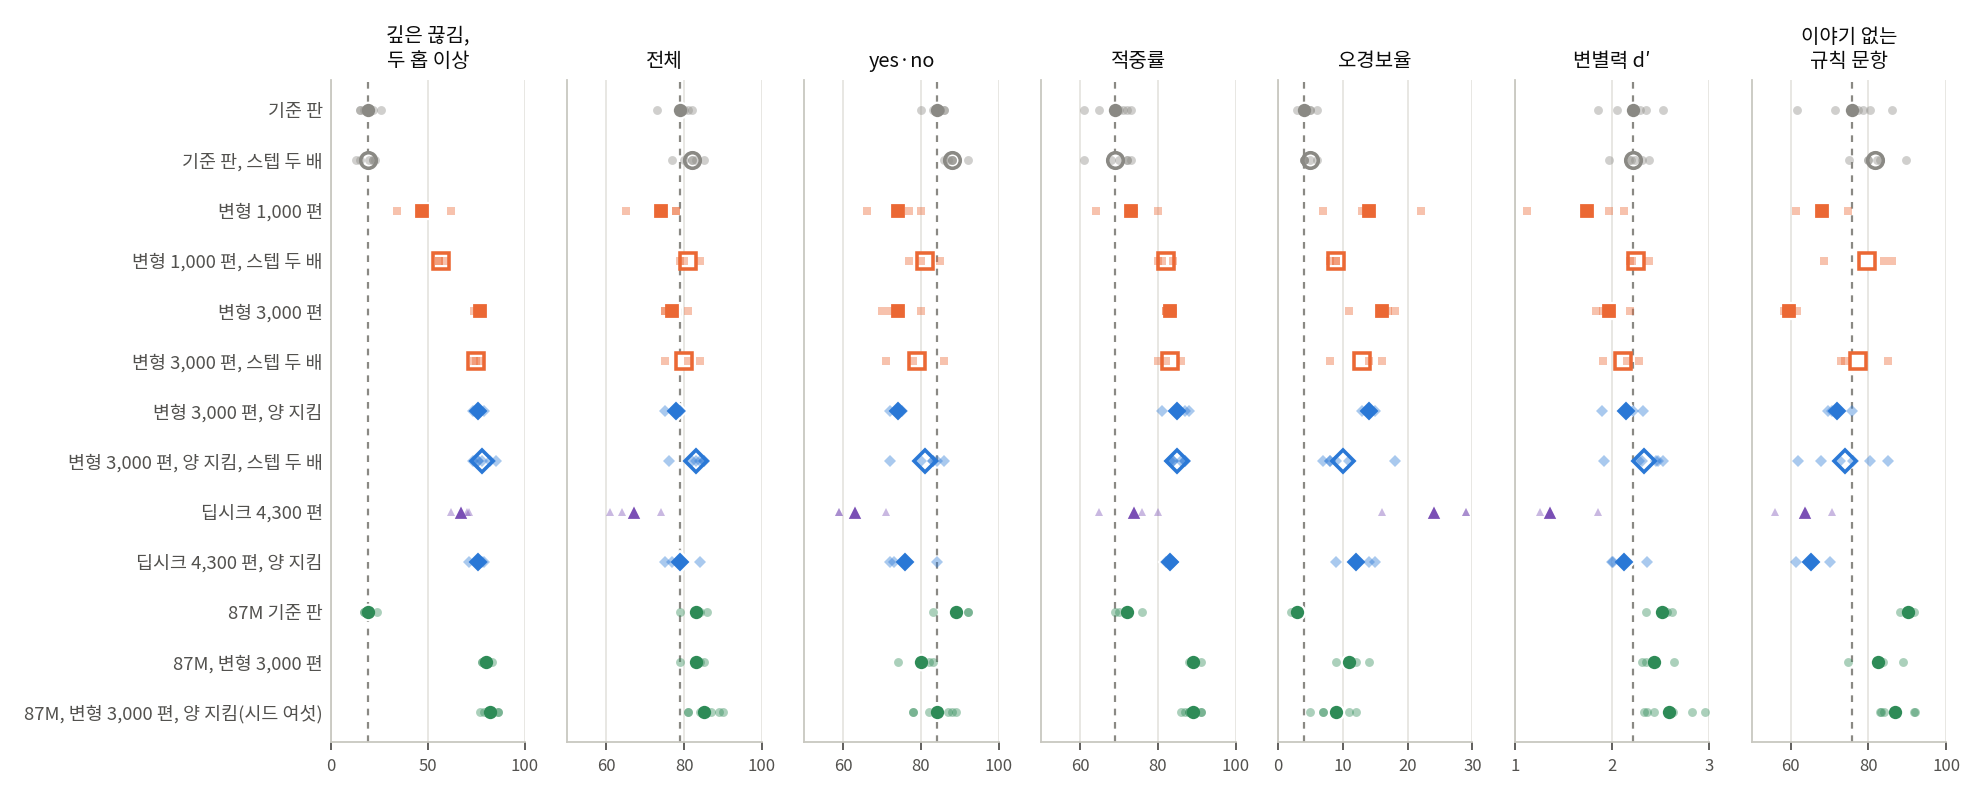
| 판 | 깊은 끊김, 두 홉 이상 | 전체 | yes·no | 적중률 | 오경보율 | 변별력 d′ | 이야기 없는 규칙 문항 |
|---|---|---|---|---|---|---|---|
| 기준 판 | 19 | 79 | 84 | 69 | 4 | 2.21 | 76 |
| 기준 판, 스텝 두 배 | 19 | 82 | 88 | 69 | 5 | 2.21 | 82 |
| 변형 이야기 1,000 편 | 47 | 74 | 74 | 73 | 14 | 1.74 | 68 |
| 변형 이야기 1,000 편, 스텝 두 배 | 57 | 81 | 81 | 82 | 9 | 2.25 | 80 |
| 변형 이야기 3,000 편 | 77 | 77 | 74 | 83 | 16 | 1.97 | 60 |
| 변형 이야기 3,000 편, 스텝 두 배 | 75 | 80 | 79 | 83 | 13 | 2.11 | 77 |
| 변형 이야기 3,000 편, 프로그램 문항 양 지킴 | 76 | 78 | 74 | 85 | 14 | 2.14 | 72 |
| 변형 이야기 3,000 편, 프로그램 문항 양 지킴, 스텝 두 배 | 78 | 83 | 81 | 85 | 10 | 2.33 | 74 |
| 딥시크 깊은 끊김 4,300 편 | 67 | 67 | 63 | 74 | 24 | 1.36 | 64 |
| 딥시크 깊은 끊김 4,300 편, 프로그램 문항 양 지킴 | 76 | 79 | 76 | 83 | 12 | 2.12 | 65 |
| 87M 기준 판 | 19 | 83 | 89 | 72 | 3 | 2.51 | 90 |
| 87M, 변형 이야기 3,000 편 | 80 | 83 | 80 | 89 | 11 | 2.43 | 82 |
| 87M, 변형 이야기 3,000 편, 프로그램 문항 양 지킴(시드 여섯) | 82 | 85 | 84 | 89 | 9 | 2.59 | 87 |
위 표는 스텝, 데이터 믹스, 모델 크기를 바꾼 판들이다(logic_stop.out, 이야기 없는 규칙 문항은 lab_table.out 의 처음 보는 성질 홉 4, 시드 셋의 평균, 기준 판·기준 판 스텝 두 배·「프로그램 문항 양 지킴, 스텝 두 배」는 시드 여섯, 변별력 말고는 %). 깊은 끊김은 깊은 끊김 시험지 223 문항, 나머지 이야기 칸은 떼어 둔 이야기 1,511 문항이다.
스텝. 스텝은 혼자서는 칸을 열지 못해서, 기준 판에 스텝만 두 배로 주면 깊은 칸은 19% 에 머문다. 데이터가 연 칸 위에서는 달랐다. 변형 1,000 편 판에 스텝을 두 배로 주자 yes·no 가 74% 에서 81% 로 돌아왔고 오경보율은 14% 에서 9% 로 내려갔다. 전체 81% 는 적중률을 69% 에서 82% 로 올리고도 기준 판보다 낮지 않은 첫 결과다. 변별력은 1.74 에서 2.25 가 되었는데, 14,000 스텝 쪽의 1.74 는 시드 하나(1.12)가 끌어내린 평균이다. 변형 3,000 편 판도 스텝 두 배에서 깊은 칸 75% 를 지킨 채 전체 80% 가 되었다.
데이터 믹스. 프로그램 문항을 기준 판과 같은 양으로 지키자 변형 3,000 편 판의 이야기 없는 규칙 문항이 60% 에서 72% 로 돌아왔고 딥시크 4,300 편 판의 붕괴도 사라졌다(전체 67% 에서 79%). 변형 3,000 편 판의 yes·no 는 74% 에서 달라지지 않았으므로, 믹스는 프로그램 문항 쪽 손실을 설명하고 이야기 쪽 손실은 설명하지 못한다.
모델 크기. 87M 기준 판은 깊은 칸이 26M 과 같은 19% 이고, 평균으로는 전체 83%, yes·no 89%, 변별력 2.51 로 26M 기준 판보다 높다. 다만 시드 셋의 변별력 범위(2.35~2.62)가 26M 기준 판의 범위(1.85~2.52)와 겹쳐서, 크기가 변별력을 올렸다고 판정하지는 못한다. 여기에 변형 이야기 3,000 편을 넣으면 깊은 칸이 80% 로 열리는 대신 yes·no 가 89% 에서 80% 로, 오경보율이 3% 에서 11% 로 바뀌고 전체는 83% 에 머문다.
둘을 함께. 26M 에서 프로그램 문항 양을 지키고 스텝을 두 배로 준 판은 전체 83%, 변별력 2.33 이었지만 같은 스텝의 기준 판(2.21, 시드 여섯 1.97~2.38)과 범위가 겹쳤다. 87M 에서 프로그램 문항 양을 지킨 판은 시드 여섯으로 측정해 깊은 칸 82%, 전체 85% 로 이 장의 판 가운데 가장 높았고, yes·no 는 87M 기준 판보다 5%p 만 잃었다(양을 지키지 않은 87M 판은 9%p). 변별력 평균 2.59 도 가장 높았지만 시드 여섯 가운데 셋(2.36, 2.33, 2.43)이 87M 기준 판의 범위 안이거나 그 아래여서 판정은 「겹침」이다.
그래서 전체가 26M 에서는 80% 안팎, 87M 에서는 83% 에 묶여 있던 거예요. 변별력이 같으면 기준을 cannot 쪽으로 옮긴 만큼 깊은 칸을 얻고 yes·no 를 잃어요. 맞바꿈 자체를 줄이는 것은 변별력인데, 이 장에서 판정 규칙을 넘겨 변별력을 올린 조건은 없었어요. 87M 이 평균으로는 가장 높았으니 시드를 늘려 다시 판정해야 해요.
문제 2 의 세 후보는 일부씩 맞았다. (다) 스텝은 덜 익어 생긴 손실을 갚고, (가) 믹스는 프로그램 문항 쪽 손실과 4,300 편 판의 붕괴를 설명하고, (나) 크기는 평균 수위를 올렸지만 범위가 겹쳤다. 26M 판의 변별력은 2.11~2.33 까지 돌아왔어도 기준 판의 시드 범위 1.85~2.52 를 넘지 못했다. 이야기 쪽 yes·no 를 cannot 과 맞바꾸는 일은 세 조건 어느 것으로도 사라지지 않았고, 87M 에서 믹스를 함께 지킨 판이 그 손실을 9%p 에서 5%p 로 줄였다.
스텝에 걸었는데 절반만 맞았네. 잃은 걸 되찾아 주기는 해도 더 잘 가려내게 해 주지는 않았어.
그래도 전체를 잃지 않고 깊은 칸을 여는 판은 생겼어. 변형 3,000 편에 스텝 두 배면 깊은 칸 75% 에 전체 80% 야.
하나는 그냥 넘어가기 싫어. 같은 딥시크 4,300 편인데 넣는 양을 고정하면 무너지고 프로그램 문항 양을 지키면 살았잖아. 데이터 말고 루나 안에서는 뭐가 달랐을까?

좋은 물음이에요. 두 판의 체크포인트가 시드마다 남아 있으니 새로 학습하지 않고도 층마다 무엇이 읽히는지 볼 때 쓴 탐침으로 들여다볼 수 있어요.