동화 속의 우리: 루나에게 우리 이야기를 가르치려면 몇 편을 써야 할까
바꿔 쓰기: 같은 사실을 여러 문장과 형식으로
세 편을 육천 번 넘게 읽히면 문장을 외우고 한 번 읽히면 아무것도 남지 않았다. 단어장을 외운 학생에게 예문이 여러 개 필요하듯 루나도 같은 사실을 여러 문장에서 만나야 할 텐데, 두 사람이 그런 글을 수백 편 손으로 쓰기는 어렵다. 서연은 다른 방법을 꺼냈다.

루나가 읽은 동화도 큰 모델이 쓴 거라며. 우리도 큰 모델한테 쓰게 하면 되잖아.

대화 만들 때 쓴 연구실 서버의 딥시크 있잖아. 이번엔 그걸로 동화를 쓰게 하자.
글은 연구실 서버에서 돌리는 DeepSeek-V4.1-Flash 가 쓴다. 남은 물음은 무엇을 다양하게 하느냐인데, 사실을 둘러싼 이야기를 다양하게 할 수도 있고 사실을 말하는 문장을 다양하게 할 수도 있다.
이야기만 다양하게 하는 길은 통하지 않았다. 타이니스토리즈가 이야기마다 낱말과 특징을 바꿔 끼워 다양성을 만든 것처럼 글감 30 가지를 바꿔 가며 300 편을 쓰게 하고 사실은 한 문형 그대로 넣었더니, 이야기는 세 편보다 훨씬 다양해졌는데도 새 문형 정답률은 세 편을 되풀이한 루나와 같은 30.0% 였다(sources/synthetic-data/run_synth.out). 그리디 선택으로 이어 쓰게 하면 이 루나는 「Minjun had a pet」 다음에는 turtle 을, 「Minjun’s pet was a」 다음에는 dog 를 썼으니, 거북이를 Minjun 이라는 이름에 붙여 두지 않고 「Minjun had a pet」이라는 토큰 묶음의 다음 낱말로 외운 것이다.

이야기를 삼백 가지로 늘렸는데 30.0% 그대로야. 거북이는 늘 같은 문장 다음에만 나왔잖아.

이야기가 아니라 사실을 말하는 문장이 늘 같은 열 개였다는 거네. 그 문장을 바꿔 써야지.
같은 사실이 매번 다른 문장, 다른 순서로 나온다면 토큰 묶음 하나를 외워서는 손실을 줄일 수 없을 것이다. 그러면 루나는 사실을 어디에 붙여 둘까?
역사: 지어낸 사람 10 만 명의 전기
타이니스토리즈를 만든 위안즈 리는 같은 해 메타의 제위안 알렌주와 함께 「언어 모델의 물리학(Physics of Language Models)」 연작을 내고 있었다. 웹 글로 학습한 큰 모델을 두고 「이 모델은 이 사실을 아는가」를 물으면, 그 사실이 학습 글에 몇 번, 어떤 문장으로 나왔는지 알 수 없어서 답을 해석하기 어렵다. 두 사람은 물리학자가 실험실에서 조건을 하나씩 바꾸듯, 학습 글을 직접 만들어 조건을 통제하기로 했다. 2023년 9월에 나온 3.1부 「지식 저장과 꺼내기」는 그 방법으로 사실을 아는 일을 다뤘다.
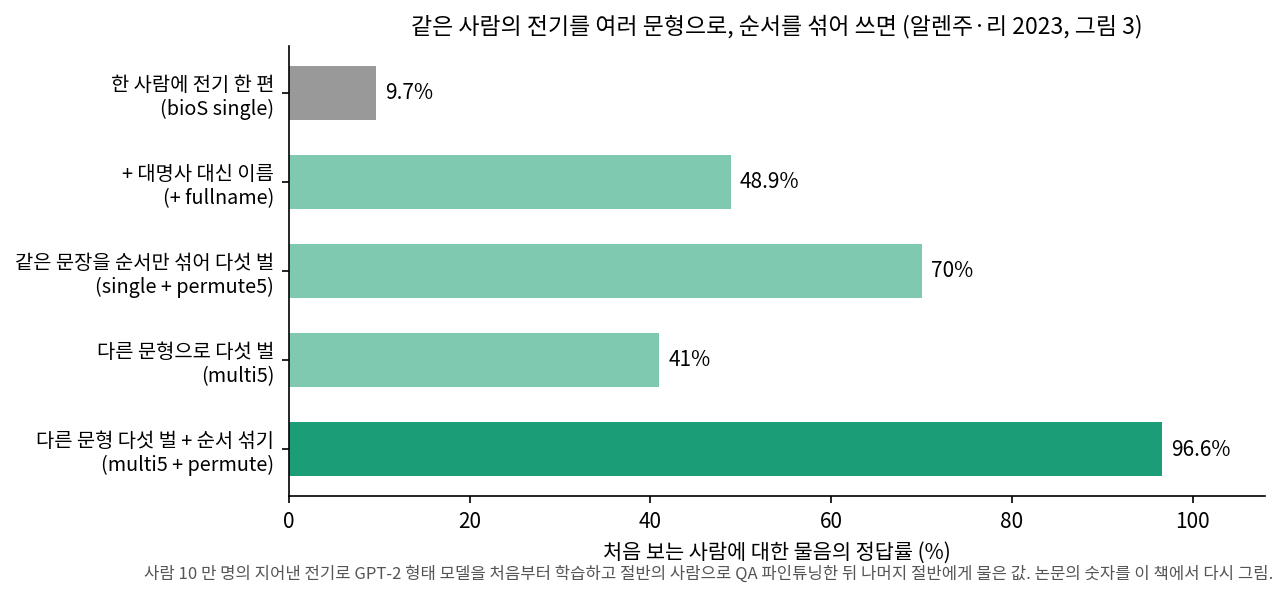
그들은 지어낸 사람 10 만 명에게 생일, 태어난 도시, 대학, 전공, 회사, 회사가 있는 도시 여섯 가지를 붙이고, 사람마다 여섯 문장짜리 전기를 썼다. 문장마다 50 개 정도의 문형 가운데 하나를 무작위로 골랐다. 이 전기로 GPT-2 형태의 모델을 처음부터 프리트레인하고, 절반의 사람에 대한 물음(「○○ 는 어느 도시에서 태어났나?」)으로 파인튜닝한 뒤, 나머지 절반의 사람에게 같은 물음을 던졌다. 모델은 전기를 토큰 하나하나까지 외웠는데도, 한 사람에 전기 한 편만 읽힌 경우 처음 보는 절반에 대한 정답률은 9.7% 였다.
전기를 늘리는 방법 셋이 이 숫자를 바꿨다. 같은 사람의 전기를 다른 문형으로 여러 벌 쓰는 것(multiplicity), 전기 안 여섯 문장의 순서를 섞는 것(permutation), 「he」「she」 대신 그 사람의 이름을 다시 쓰는 것(fullname)이다. 다른 문형 다섯 벌에 순서 섞기를 더하자 정답률은 96.6% 로 올랐는데, 학습 글의 사실 수는 그대로였고 같은 사실을 담은 문장의 모양만 바뀌었다.
두 사람은 모델 안도 들여다보았다. 전기를 늘려 학습한 모델에서는 한 사람의 여섯 가지 사실이 그 사람 이름 토큰 자리에서 모델이 계산한 벡터에서 거의 선형으로 읽혔고, 늘리지 않은 모델에서는 사실이 전기의 여러 토큰에 흩어져 있었다.
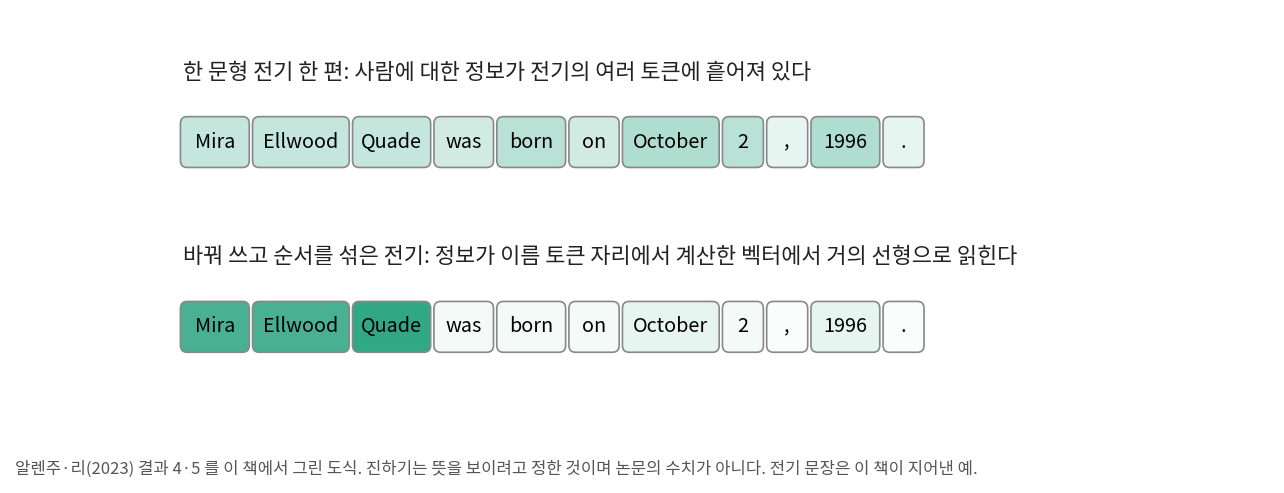 한 문형으로만 읽은 모델은 「이 문장 다음에 이 낱말」을 외웠을 뿐, 이름에 사실을 붙여 두지 않은 것이다. 그들은 일부 사람(「유명인」)의 전기만 늘려도 나머지 사람에 대한 정답률이 4.4% 에서 86.8% 로 오른다는 결과도 냈고, 바꿔 쓰기에는 Llama-7B 나 그보다 작은 보조 모델로도 충분하다고 적었다.
같은 사실을 다른 문형으로 다시 쓰는 일을 패러프레이징 (같은 뜻을 다른 문장으로 바꿔 쓰기 / paraphrasing)이라 하고, 이렇게 학습 글을 늘려 모델이 지식을 꺼내 쓰게 하는 것을 알렌주와 리는 지식 늘리기(knowledge augmentation)라 불렀다.
조건 2. 바꿔 쓰기, 형식 열 가지, 순서 섞기
딥시크에게 이야기마다 글감(비 오는 날, 잃어버린 공, 소풍 같은 30 가지 가운데 하나)과 사실 열 가지 가운데 넷을 무작위로 골라 주고, 그 사실 넷을 자기 말로 바꿔 쓰게 했다. 글의 형식도 열 가지(동화, 선생님의 일기, 할머니의 편지, 두 사람의 대화, 짧은 시, 어린이 신문 기사, 재미있는 사실 목록, 인터뷰, 그림책 한 쪽, 수수께끼) 가운데 하나를 고르게 하고, 사실의 순서를 섞어 주었다. 알렌주와 리의 세 방법 가운데 대명사 대신 이름을 쓰는 것도 지시에 넣었다(sources/synthetic-data/gen_deepseek.py).
Write {format} (120 to 200 words) for 3-year-old children, using only very simple words. It is about two children, Minjun (a boy) and Seoyeon (a girl). Idea: {topic}.
Include the following facts, in this order. Say each fact in your own words with a different sentence pattern; do not copy these sentences. Whenever you state one of these facts, use the child's name (Minjun or Seoyeon), not "he" or "she".
{facts}
...
동시 요청 여덟 개로 450 편을 부탁해 받았다. 딥시크의 응답에는 답하기 전에 스스로 생각한 글(reasoning)이 따로 붙어 오는데, 우리는 답 본문만 쓰고 그 글은 버렸다. 답 본문이 빈 글 24 편과, 시험 문장이 글자 그대로 든 글 57 편은 뺐다. 시험 문장이 든 글은 「Seoyeon’s pet was a rabbit.」처럼 바꿔 쓴 문장이 우연히 시험 문형과 같아진 경우로, 이 글을 남기면 새 문형으로 묻는 물음이 새 문형이 아니게 된다. 딥시크는 같은 문장을 굽은 따옴표(Seoyeon’s)로도 써서, 따옴표 형태를 맞춘 뒤에 비교해야 57 편이 다 잡힌다. 남은 369 편은 95,838 토큰이고, 한 문형 문장이 글자 그대로 나온 것은 23 번뿐이었다(run_synth.out 1절). 대화 형식의 한 편은 이렇다(samples_varied.txt 에 몇 편을 더 실었다).
Minjun: Let's make bread, Seoyeon.
Seoyeon: Yes, Minjun. Bread is fun.
…
Minjun: Looking up at stars is fun for Minjun.
Seoyeon: Mix, mix, Minjun.
Minjun: The color gray makes Minjun happy.
Seoyeon: A rabbit is Seoyeon's pet.
「Looking up at stars is fun for Minjun」을 민준이 자기 입으로 말해. 대명사 쓰지 말라고 했더니 자기 얘기도 3인칭으로 해.
시킨 대로 한 거지. 너도 루나 얘기할 땐 그래.
대조는 같은 딥시크가 같은 글감 목록으로 쓰되 사실은 한 문형 그대로 넣은 300 편(fixed, 67,195 토큰)이다. 학습 스텝과 배치에서 우리 글이 차지한 줄 수가 모두 같으니, 두 조건의 루나는 우리 글의 토큰을 같은 수만큼 읽었다.
## 요약 (시드 평균)
  조건           | 새 문형 정답률 | 바뀜   | 학습 문형 정답률
  fixed        |        30.0% | 16.7% |       100.0%   (시드별 새 문형 ['32.5%', '27.5%', '30.0%'])
  varied       |        51.7% | 26.7% |       100.0%   (시드별 새 문형 ['47.5%', '50.0%', '57.5%'])
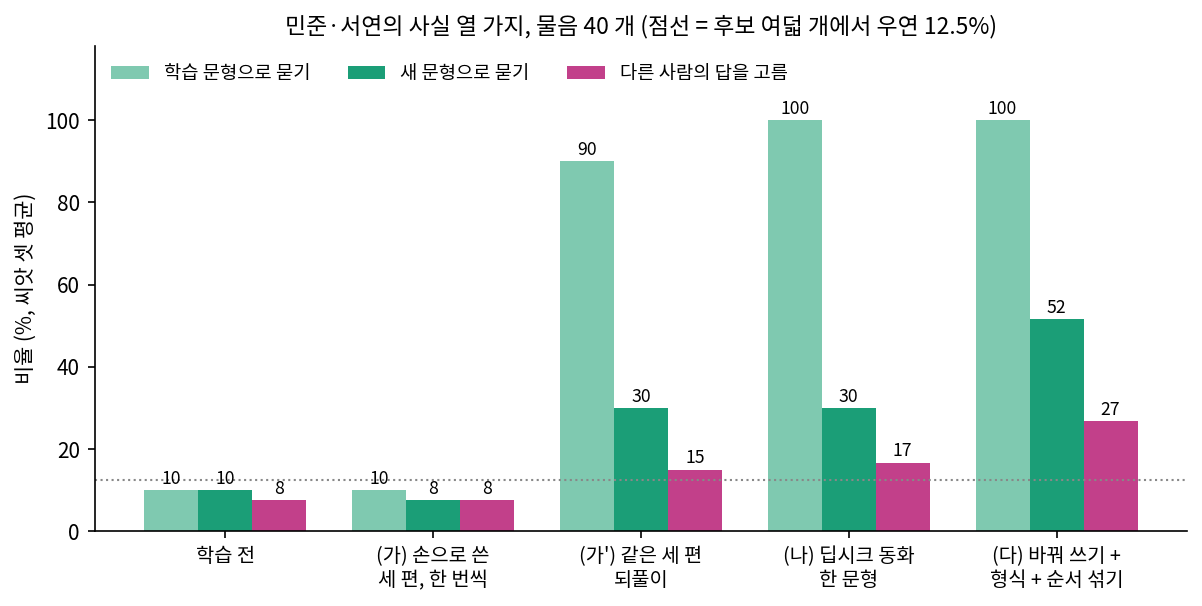
새 문형 정답률은 30.0% 에서 51.7% 로 올랐다. 바꿔 쓴 쪽은 시드 셋 모두 47.5% 이상이어서, 한 문형 쪽 시드 셋의 범위(27.5~32.5%)와 겹치지 않는다. 속성마다 보면 동물과 음식이 잘 붙었다(동물은 시드마다 50%, 62%, 75% 로 한 문형 쪽의 0~12% 에서 올랐고, 음식은 셋 모두 62% 로 25~38% 에서 올랐다). 첫 시드의 루나는 「Minjun’s pet was a」 다음에 「little turtle」을, 「Seoyeon took good care of her pet. It was a」 다음에 「small, soft rabbit」을 썼다. 반면 색은 25~38% 로, 사실을 한 문형으로 넣은 루나(12~25%)보다 조금 높은 데 그쳤다.
이름 철자는 눈에 띄게 고쳐졌다. 학습 전에는 「Seoyeon」을 78 번 쓰는 동안 한 번도 바르게 쓰지 못했는데, 바꿔 쓴 글을 읽은 첫 시드의 루나는 88 번 가운데 86 번을 바르게 썼다(run_synth.out).
다른 사람의 답을 고른 비율(바뀜)은 16.7% 에서 26.7% 로 함께 올랐다. 루나는 「거북이, 토끼, 국수, 딸기는 이 두 사람의 이야기에 나오는 말」이라는 것은 배웠지만, 어느 것이 누구의 것인지는 그만큼 배우지 못했다. 369 편 모두 두 사람이 함께 나왔으니, 두 이름 모두 모든 사실과 가까이 놓였다.
동화 실력은 거의 그대로였다. 바꿔 쓴 글을 읽은 루나의 타이니스토리즈 검증 글 바이트당 비트는 0.4311 로, 학습 전 0.4259 보다 0.005 정도 올랐다. 샘플에서는 시키지 않아도 별이 나온다.
샘플(온도 0.8, 시드 0) 「Once upon a time, Minjun and Seoyeon」 → ' went for a walk. They saw a lake. "Let's play on the lake!" said Minjun. "Yes!" said Seoyeon. … Then Minjun looked up at the stars. "Stars!" Minjun said. Seoyeon looked at the stars. They said, "Party!" They played and played. Then Minjun and Seoyeon went home.'
이름을 토큰 하나로 넣어 보면
바꿔 쓴 글의 결과를 본 뒤에도 민준은 토크나이저 표에서 「␣M in j un」이 적힌 줄을 손가락으로 두드렸다.
글을 이렇게 많이 쓰게 할 필요가 있어? Seoye 는 「␣S e oy e on」 다섯 조각에서 끝을 못 붙인 거잖아. 이름을 그냥 토큰 하나로 박으면 되잖아.
층을 열어 볼 때도 「 Minjun」의 마지막 조각 자리 벡터는 아직 낱말을 다 읽지 못한 상태였다(동화 GPT 는 그 뒤에 이름이 이어진다고 보고 「e」를 꼽았다). 이름이 토큰 하나면 이름 토큰을 읽는 위치에서 낱말이 끝나니, 민준의 생각은 그럴듯하다.
민준의 생각대로 「␣Minjun」 「Minjun」 「␣Seoyeon」 「Seoyeon」 네 형태를 어휘에 직접 넣고 임베딩 행렬을 네 행 넓힌 뒤, 바꿔 쓴 글을 같은 1,000 스텝 읽혔다. 이번에는 시드를 다섯으로 늘렸다(위의 51.7% 는 시드 셋 평균이다). 새 문형 정답률은 토크나이저를 그대로 둔 루나가 51.0%, 토큰 넷을 넣은 루나가 47.0% 였고, 다른 사람의 답을 고른 비율은 22.5% 에서 30.5% 로 늘었다(sources/synthetic-data/tok_edit_summary.out). 토큰을 넣어도 사실을 더 잘 배우지는 않았다.
좋아진 것은 철자다. 바꿔 쓴 글을 읽은 루나는 토큰 없이도 이름을 98% 와 99% 바르게 썼는데, 토큰 넷을 넣자 남은 1~2% 의 틀린 철자가 사라졌다. 글 없이 토큰만 넣은 루나는 달랐다. 두 이름이 든 시작 문장으로 스무 번 이어 쓰게 하니, Min…, Seo…, Ser… 로 시작한 낱말이 Ming 두 번뿐이었다. 넣기 전에는 망가진 철자로라도 쓰던 이름을 아예 쓰지 않게 된 것이다.
틀린 철자가 0 개이긴 하네. 축하해.

원인을 따로 측정한 것은 아니니 추정으로 들어요. 어휘에 낱말을 넣는 일은 칸을 하나 만들 뿐이고, 그 낱말을 어디에 쓰는지는 글을 읽어야 배워요. 글을 함께 읽혀도 사실이 붙는 곳은 여전히 문장이고요. 그래서 우리는 글을 바꿔 쓰는 쪽으로 가요.
민준은 토크나이저 표를 닫고, 바꿔 쓴 글을 읽은 첫 시드의 루나를 다시 불러왔다. 이어서 학습하기 전의 루나가 개와 사과로 답했던 두 물음을 그리디 선택으로 넣었다.
이어서 학습하기 전 (sources/synthetic-data/run_hand.out)
  「Minjun's pet was a」         → small, brown dog. He was very happy and loved to
  「Seoyeon's favorite food was」 → a big, red apple. He loved to eat it every
바꿔 쓴 글을 읽은 루나, 시드 0 (sources/synthetic-data/run_synth.out)
  「Minjun's pet was a」         → little turtle.\nToday Minjun and S
  「Seoyeon's favorite food was」 → strawberries. Yellow was a color Se
turtle 이야. 이름을 토큰으로 안 박고도 루나가 처음으로 나를 알아.

네 거북이를 아는 거지, 너를 아는 건 아니야. 누구 건지 바꿔 고르는 것도 넷에 하나가 넘고. …그래도 내 이름은 이제 거의 안 틀리네.
| 측정한 것 | 이어서 학습하기 전 | 바꿔 쓴 글을 읽은 루나 |
|---|---|---|
| 새 문형 정답률(후보 여덟) | 10.0% | 51.7% (시드 47.5 / 50.0 / 57.5) |
| 다른 사람의 답을 고른 비율 | 7.5% | 26.7% |
| 「Seoyeon」을 바르게 쓴 횟수(시드 0) | 0 / 78 | 86 / 88 |
같은 세 편을 육천 번 넘게 읽힌 루나도, 이야기만 300 편으로 늘린 루나도 처음 보는 문형에서는 30.0% 에 머물렀다. 숫자를 움직인 것은 같은 사실을 말하는 문장의 가짓수였다. 어느 사실이 누구의 것인지는 아직 그만큼 붙지 않았다.
ML에서: 모델이 쓴 글만 거듭 읽히면
합성 데이터를 쓸 때 함께 나오는 걱정이 있다. 2024년 『네이처』에 실린 일리아 슈마일로프(Ilia Shumailov) 팀의 논문은 모델이 만든 글을 가리지 않고 다음 모델의 학습에 쓰기를 세대마다 되풀이하면, 원래 데이터 분포의 꼬리가 사라지는 되돌릴 수 없는 결함이 생긴다고 보고했다. 이 현상을 모델 붕괴 (모델이 쓴 글로 거듭 학습해 분포가 좁아지는 일 / model collapse)라 한다. 같은 논문에서 세대마다 원래 학습 데이터의 10% 를 남겨 둔 경우는 성능이 조금만 나빠졌고, 2024년 마티아스 게르스트그라서(Matthias Gerstgrasser) 팀은 원래 데이터를 버리지 않고 세대마다의 합성 데이터를 그 위에 쌓아 가면 붕괴를 피한다고 보고했다. 우리 실험은 세대를 거듭하지 않았고, 배치의 32 줄 가운데 28 줄은 늘 원래 동화를 읽혔다. 원래 동화도 GPT-4 가 쓴 글이라는 점은 기억해 둘 만하다.
문제 2. 바꿔 쓰니 정답률과 함께 「바뀜」도 늘었다
바꿔 쓴 글을 읽은 루나는 새 문형 정답률이 30.0% 에서 51.7% 로 올랐지만, 다른 사람의 답을 고른 비율도 16.7% 에서 26.7% 로 올랐다. (가) 학습 전 루나의 「바뀜」 7.5% 와 비교하면, 바뀜이 늘었다는 것은 루나가 무엇을 배웠다는 뜻인가? (나) 바뀜을 줄이려면 학습 글을 어떻게 바꿔 볼 수 있을까?
바뀜이 늘었다는 건, 토끼를 민준 거라고 답했다는 거잖아. 그건 나빠진 거 아니야?

학습 전에는 토끼를 고를 일 자체가 드물었어요. 후보 여덟 개 가운데 토끼가 1등이 된다는 것은요?
아… 토끼가 이 이야기와 상관있는 말이라는 걸 배운 거네요. 다만 누구의 토끼인지를 헷갈리고요. 정답과 바뀜을 더하면 51.7 + 26.7 = 78.4% 가 두 사람의 사실 가운데 하나를 고른 거예요. 학습 전에는 10.0 + 7.5 = 17.5% 였고요.

(나)는 글 하나에 두 사람을 다 넣지 말아 보자. 지금은 369 편 모두 「Minjun and Seoyeon」으로 시작하니까 거북이 옆에 늘 서연이도 있었어. 민준만 나오는 글, 서연만 나오는 글을 섞으면 이름과 사실이 더 또렷하게 붙지 않을까?
알렌주와 리의 전기가 그런 구성이에요. 한 편에 한 사람만 나와요. 이 실습은 두 사람이 함께 나오는 369 편으로 가니까, 바뀜은 남은 숙제로 설정서에 적어 둡시다.
문제 3. 공정한 비교였나
한 문형 300 편은 67,195 토큰, 바꿔 쓴 369 편은 95,838 토큰이었다. 민준은 「바꿔 쓴 쪽이 글이 더 많았으니 이긴 것도 당연하다」고 한다. (가) 두 조건의 루나가 학습 중 읽은 우리 글의 토큰 수는 같은가? (나) 그렇다면 두 데이터의 크기 차이는 무엇을 바꾸는가?
글이 1.6 배 많으면 1.6 배 많이 읽은 거잖아.
스크립트를 보면 스텝마다 우리 글에서 4 줄 × 512 토큰을 자르고, 1,000 스텝이야. 두 조건 다 204만 8천 토큰을 읽었어. 글의 크기와 상관없이.

아, 그럼 크기가 바꾸는 건 같은 글을 몇 번 되풀이해 읽었느냐네. 한 문형은 67,195 토큰을 서른 번쯤, 바꿔 쓴 건 95,838 토큰을 스무 번 정도.
그래요. 바꿔 쓴 쪽은 같은 글을 덜 되풀이하고 더 다양한 문장을 읽었어요. 그런데 손으로 쓴 세 편은 333 토큰을 육천 번 넘게 읽고도 30.0% 였고, 300 편은 그보다 덜 되풀이하고도 같은 30.0% 였어요. 되풀이 횟수보다 문장의 다양성이 숫자를 바꿨다는 쪽에 증거가 더 있어요.