다음 루나를 위하여: 원하는 모델을 빚는 순서와 AI 의 앞날
일찍 섞으면 왜 덜 잊을까
선생님이 가져온 논문은 카네기 멜런 대학교의 로런스 펑(Lawrence Feng)과 동료 연구자들이 쓴 「Early Data Exposure Improves Robustness to Subsequent Fine-Tuning」(arXiv 2605.12705, COLM 2026)이다. 파라미터 1억 3,500만 개와 10억 개 모델을 세 단계로 학습했다. 웹 글로 프리트레이닝하고, 음악이나 화학이나 지시 따르기 같은 목표 능력으로 포스트트레이닝한 뒤, 다른 태스크로 한 번 더 파인튜닝해서 목표 능력이 얼마나 남는지 측정했다. 목표 능력의 데이터 일부를 프리트레이닝에 미리 섞는 것을 「조기 노출」이라고 불렀다.
결과는 셋이다. 첫째, 포스트트레이닝 직후의 성능은 남는 정도를 알려 주지 않았다. 논문의 말로는 「immediate post-training performance does not reliably predict retention after subsequent fine-tuning」이다. 둘째, 조기 노출은 남는 능력과 새 태스크 성능을 함께 좋게 했다(「early exposure - mixing post-training data into pretraining - consistently improves the frontier between retained upstream performance and downstream performance」). 셋째, 같은 양의 데이터를 두 단계에 나눌 때 가장 좋은 비율은 양 끝이 아니었다.

방으로 생각하면 돼. 처음부터 섞으면 그 능력이 자기 방을 받아. 나중에 가르치면 남이 쓰던 방을 빌려 쓰고, 다음 태스크가 와서 그 방을 다시 가져가.

그 말을 수학으로 옮겨 볼게. 부록의 모델이 두 층 선형 모델이라 작게 직접 돌려 볼 수 있어.
두 층 선형 모델로 옮기기
부록의 모델은 행렬 둘을 곱한 θ = W₁W₂ 이고, 태스크마다 입력의 방향별 목표 세기가 정해져 있다. 서연은 방향 여섯을 세 가지로 나눴다. 세 단계가 모두 같은 세기를 쓰는 불변 방향 둘, 프리트레이닝과 다음 태스크는 약하게 쓰고 포스트트레이닝은 세게 쓰는 공유 방향 둘, 포스트트레이닝 데이터에만 있는 전문 방향 둘이다. 작은 값에서 출발하면 방향 하나의 세기는 다음처럼 움직인다(부록이 인용한 식에서 정칙화 항을 뺀 것).
바뀌는 양에 지금의 세기 σ_i(k) 가 곱해져 있다. 그래서 세기가 큰 방향부터 빨리 자라고, 세기가 0 인 방향은 영영 자라지 않는다.
곱셈이라서 그래. 0 에 무엇을 곱해도 0 이야.
서연의 실험 첫째(sources/early-exposure/toy.py → toy.out, CPU 1 분)에서 목표 세기 3.00, 2.50, 2.20, 2.10, 1.60, 1.50 인 방향이 목표의 절반을 넘은 스텝은 60, 75, 83, 95, 126, 126 이었다. 큰 것부터 차례로 켜졌다.
문제 2. 0 에서 출발한 방향
(가) 통장의 돈이 매일 그날 잔고의 1% 씩 불어난다. 처음에 1 원이 있을 때와 0 원이 있을 때, 1 년 뒤 잔고는 각각 어떻게 될까?
(나) 세기의 식에서 σ_i(0) = 0 이면 σ_i(1) 은 얼마인가? 서연의 실험 둘째에서 출발 세기가 0.1, 0.001, 0.000001, 0.000000000001 일 때 목표의 절반에 닿은 스텝은 50, 148, 296, 590 이었다. 출발 세기가 열 배 작아질 때마다 스텝이 얼마씩 늘었나? 출발 세기가 정확히 0 이면 어떻게 되었을까?
(다) (나)의 결과로 보면, 프리트레이닝 글에 한 번도 나오지 않은 능력을 마지막 단계에서 가르칠 때 무엇이 어려운가?

(가)는 1 원이면 조금씩 불어나고, 0 원이면 1 년 내내 0 원. 1% 를 곱해 봐야 0 이니까.
(나)는 σ_i(1) = 0 − 2η · 0 · (…) = 0. 스텝은 백 배 줄 때 98, 천 배 줄 때 148, 백만 배 줄 때 294 가 늘었어. 열 배마다 49 스텝쯤으로 거의 같아. 출발 세기가 줄어드는 비율이 아니라 자릿수만큼 느는 거야. 정확히 0 이면 20,000 스텝 뒤에도 0.000 이었어.
천 배 작아도 결국은 자라는데, 0 만은 안 자라는 거네요. 아주 조금이라도 있는 것과 아예 없는 것은 다르다는 거죠.

(다)가 그 이야기예요. 프리트레이닝에서 조금이라도 쓰인 방향은 나중에 키울 수 있지만, 한 번도 쓰이지 않은 방향은 마지막 단계의 학습이 새로 열기 어려워요. 그래서 마지막 단계는 남이 쓰던 방향, 공유 방향을 고쳐 쓰게 돼요. 민준 학생이 말한 「남의 방」이에요.
섞은 판과 안 섞은 판
서연은 가운데 폭을 4 로 줄였다. 방향 여섯 가운데 넷만 담을 수 있게 해서 모델이 무엇을 담을지 골라야 하게 만든 것이다. 그리고 프리트레이닝에 포스트트레이닝 데이터를 섞지 않은 판과 30% 섞은 판을 세 단계 내내 따라갔다.
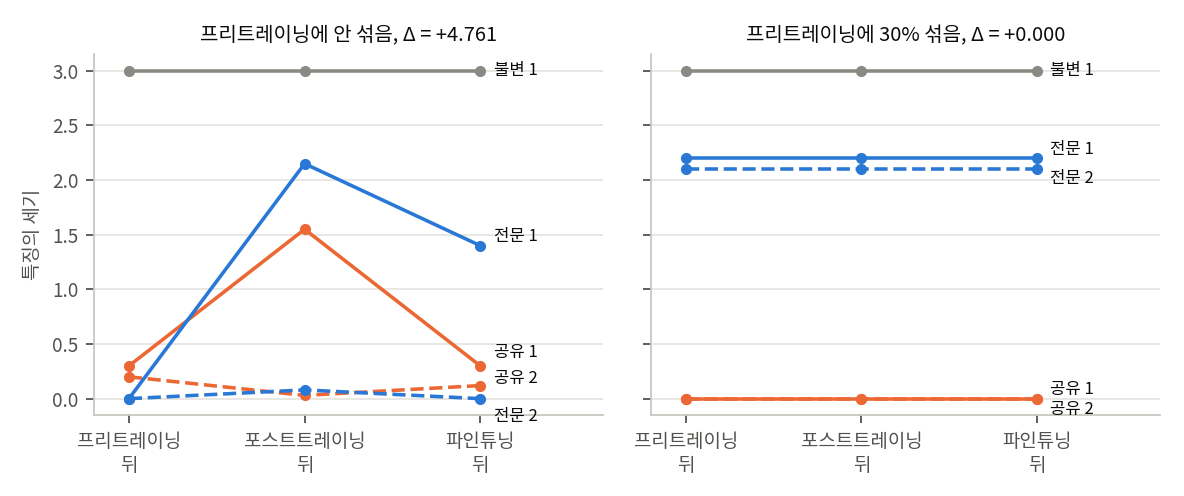
| 단계 | 안 섞음: 공유 둘 | 안 섞음: 전문 둘 | 30% 섞음: 공유 둘 | 30% 섞음: 전문 둘 |
|---|---|---|---|---|
| 프리트레이닝 뒤 | 0.30 · 0.20 | 0.00 · 0.00 | 0.00 · 0.00 | 2.20 · 2.10 |
| 포스트트레이닝 뒤 | 1.55 · 0.03 | 2.15 · 0.08 | 0.00 · 0.00 | 2.20 · 2.10 |
| 파인튜닝 뒤 | 0.30 · 0.12 | 1.40 · 0.00 | 0.00 · 0.00 | 2.20 · 2.10 |
| 파인튜닝 뒤 목표 태스크 손실의 증가 Δ | +4.761 | +0.000 |
위 표는 서연의 실험 셋째다(toy.out 3절, 불변 방향 둘은 두 판 모두 3.00 · 2.50 으로 그대로). 안 섞은 판에서 포스트트레이닝은 전문 방향 하나와 함께 공유 방향 하나를 고쳐 써서 능력을 담았고, 다음 파인튜닝이 그 방향을 제 값으로 되돌리며 목표 태스크 손실이 4.761 늘었다. 섞은 판은 프리트레이닝 때 전문 방향 둘이 자리를 차지했고, 뒤의 두 단계는 그 방향을 건드리지 못했다.
가정이 서로 맞지 않는다
서연은 논문이 정리를 세우려고 둔 가정도 숫자로 확인해 보다가 손을 멈췄다. 저희가 읽은 판(v2)의 가정 C.6 은 「섞는 비율 × 전문 방향 세기」가 공유 방향의 섞인 세기보다 커야 한다는 조건인데, 같은 부록의 다른 가정(전문 방향 세기는 공유 방향의 세기 차이의 절반보다 작다)을 함께 두면 어떤 섞는 비율에서도 참이 될 수 없었다. 전문 방향 세기 0.6 으로 계산하면 섞는 비율 0.1·0.3·0.5·0.7·0.9·1.0 이 모두 거짓이었다(toy.out 5절).
가정이 서로 부딪히면 정리를 버려야 해요? 아니면 하려던 말을 살려서 읽어요?
하려던 말은 「섞으면 전문 방향이 배워지는 문턱을 넘는다」야. 그 말이 맞는지는 조건을 바꿔 가며 직접 보면 돼.
실험 넷째와 다섯째가 그 확인이다(toy.out 4·5절, 4절은 시드 다섯의 평균).
- 가운데 폭을 6 으로 넉넉히 주면 섞든 안 섞든 Δ 가 +3.380 으로 같았다. 담을 자리가 충분하면 두 태스크가 공유 방향을 함께 쓰고 함께 잃었다.
- 폭 4 에 포스트트레이닝을 3,000 스텝으로 길게 하면 안 섞은 판도 결국 전문 방향으로 옮겨 가 Δ 가 +0.000 이 되었다.
- 폭 4 에서는 섞는 비율 0.1 만으로 전문 방향이 자리를 차지했다(포스트트레이닝 300 스텝, 파인튜닝 뒤 전문 방향 2.20 · 2.10, Δ +0.001). 가정 C.6 이 거짓인 비율에서다. 끝까지 학습한 좁은 모델이 무엇을 담는지는 그 방향이 줄여 주는 손실(섞는 비율 × 세기의 제곱, 0.48)과 공유 방향의 섞인 세기의 제곱(0.18)을 비교해서 정해졌다.

조건은 둘이야. 모델의 자리나 학습 시간이 모자라서 무엇을 담을지 골라야 할 것. 그리고 섞은 글이 그 방향을 골라 담을 만큼 셀 것.
장난감은 실제 모델이 아니에요. 비선형도, 여러 특징이 한 방향에 겹치는 것도 없어요. 그래도 논문은 1억 3,500만 개와 10억 개 모델에서 같은 쪽의 결과를 냈고, 루나의 기록도 같은 쪽이었어요. 이름의 쓰임 글을 가족 이야기 단계에서 늦게 읽힌 판은 이름을 부를 줄은 알았지만, 이름 벡터는 한 번도 안 쓰인 토큰들 곁(코사인 0.87~0.88)에 그대로 있었죠. 프리트레이닝에 넣은 판만 0.35~0.39 로 떨어져 나왔어요(sources/retokenize/timing_probe.out). 프리트레이닝에서 쓰이지 않은 방향이 뒤에서 잘 열리지 않는 거예요.
「필요한 데이터는 프리트레이닝부터 섞는다」는 이제 근거가 셋이다. 루나의 기록, 큰 모델의 논문, 손으로 돌린 장난감 모델이 같은 쪽을 가리켰고, 장난감은 그 원칙이 힘을 쓰는 조건(자리나 시간이 모자랄 때)까지 보여 주었다.