다음 루나를 위하여: 원하는 모델을 빚는 순서와 AI 의 앞날
데이터를 보강하는 네 가지
모자란 칸을 찾으면 그 칸을 채울 데이터를 만든다. 방법은 넷이다. 사람이 직접 쓰기, 코드로 조합하기, 웹에서 모으기, 다른 모델에게 쓰게 하기. 서연이 마지막 루나의 학습 파일을 출처별로 세어 봤다.
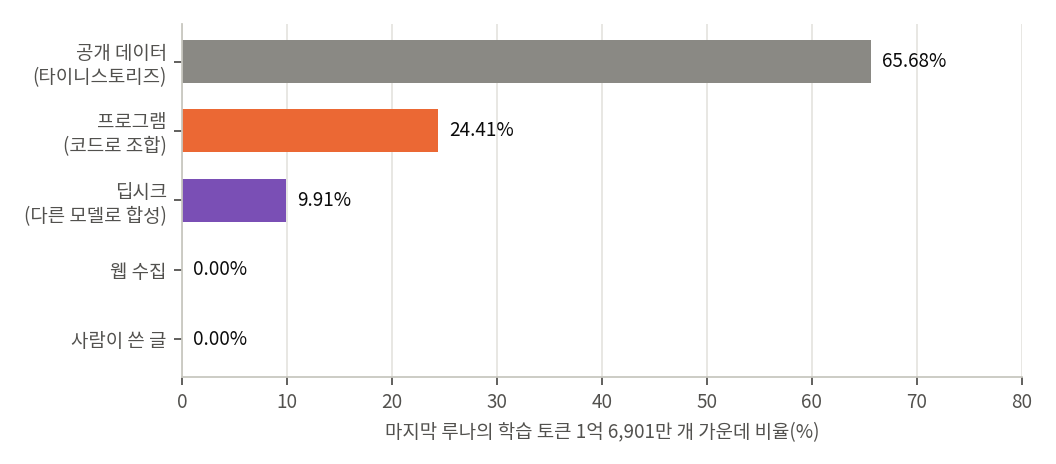
| 출처 | 마지막 루나의 학습 토큰 | 비율 | 루나에서 |
|---|---|---|---|
| 공개 데이터(타이니스토리즈, 낱말 목록으로 거름) | 111,006,105 | 65.68% | 동화 |
| 프로그램(코드로 조합) | 41,259,033 | 24.41% | 규칙 체인 문항, 동네·마음·반응·놀이·도구 글틀, 추론 단계 글 |
| 딥시크(다른 모델로 합성) | 16,742,608 | 9.91% | 지식 글, 규칙 체인 이야기, 동네 대화, 감정 대화 |
| 웹 수집 | 0 | 0.00% | ClimbMix 는 유도 헤드 대조에서만 읽혔다 |
| 사람이 쓴 글 | 0 | 0.00% | 사람이 쓴 문장은 글틀·규칙표·시험지로 들어갔다 |
위 표는 마지막 루나의 학습 파일 169,007,746 토큰을 글 묶음마다 센 것이다(sources/cycle/data_sources.out). 동네 글은 직접 토큰화해 딥시크 대화와 글자까지 같은 글을 딥시크로, 나머지를 프로그램으로 갈랐고, 그 합이 학습 파일을 만든 기록과 같은지 확인했다.

사람이 쓴 글이 0 이야? 우리가 그렇게 많이 썼는데.

우리가 쓴 건 문장이 아니라 규칙이었어. 하은이가 정한 감정 규칙표 17 경우, 다섯 살 낱말 3,050 개, 시험지의 루나 사실 칸. 그 규칙이 프로그램을 거쳐 동네·마음·놀이 글틀 464,583 편이 됐어.
그리고 타이니스토리즈도 GPT 가 쓴 글이니까, 루나가 읽은 글의 네 분의 삼은 다른 모델이 쓴 거네요.
타이니스토리즈와 딥시크를 합친 다른 모델이 쓴 글은 127,748,713 토큰, 75.59% 다(data_sources.out 2절). 네 방법은 얻는 것과 치르는 것이 다르다.
| 방법 | 얻는 것 | 치르는 것 | 루나에서 본 일 |
|---|---|---|---|
| 사람이 직접 | 의도가 가장 정확하다 | 느리고 양이 적다 | 시험지의 루나 사실 칸은 손으로 썼다. 학습 글에는 규칙표와 글틀로 들어갔다 |
| 코드로 조합 | 정답이 확실하고 양에 끝이 없으며, 시험과 학습을 해시로 가를 수 있다 | 말씨가 단조롭고, 글틀 하나의 실수가 모든 글에 퍼진다 | 반응 글틀의 「I asks」가 10,947 편에 들어갔다 |
| 웹에서 수집 | 주제와 말씨가 가장 넓다 | 내용을 고를 수 없고, 라이선스를 지켜야 한다 | ClimbMix(CC BY-NC 4.0)는 다섯 살 낱말로 거른 본줄기에는 넣지 않았다. 대조 실험에서는 웹 글을 읽힌 모델에만 유도 헤드가 생겼다 |
| 다른 모델로 합성 | 말씨가 다양하고 빠르다 | 문체가 쏠리고, 사실을 지어낼 수 있다 | 동네 대화 2,755 편은 내용을 프로그램이 정하고 말씨만 딥시크가 썼다 |
문제 1. 어느 방법으로 보강할까
루나에게 다음 세 칸을 새로 가르치려 한다. 네 가지 방법 가운데 무엇을 먼저 쓰고, 그 방법의 어떤 약점을 어떻게 막을지 말해 보자.
(가) 동네에 없는 물건을 물으면 「우리 동네에는 없어」라고 답하기
(나) 엄마가 돌아온 장면에서 아이다운 말로 기뻐하기
(다) 루나의 할머니 이름 묻기

(가)는 코드. 동네 그래프에 없는 물건 목록은 프로그램이 정확히 알아. 정답이 틀릴 일이 없지.
대신 말씨가 하나로 굳으니까 물음 형식을 여러 개 섞어야 해. 시험 문항은 해시로 빼 두고.
(나)는 딥시크요. 기뻐하는 말은 여러 가지여야 하니까요. 그런데 장면의 상태는 프로그램이 정해 주고, 받은 글은 감정 낱말이 규칙표와 맞는지 거르고요.

(다)는 사람이 먼저예요. 할머니 이름은 세상 어디에도 없는 사실이라서, 누군가 정해서 적어야 해요. 그다음에 그 한 줄을 코드와 딥시크로 여러 형식의 글로 늘리는 거죠. 네 방법은 하나를 고르는 게 아니라, 사람이 정한 것을 코드가 정확하게 늘리고 다른 모델이 다양하게 만드는 차례로 쓰면 돼요.