얼마나 담을 수 있나: 파라미터 하나에 2비트
무엇을 가르칠지 고르기 전에, 일단 웹 글을 다 읽히면 낫지 않아? 별 이야기도 하고, 우리가 시키는 것도 알아듣고.
동화 크기에 남을지, 웹 글로 넓힐지는 결국 「이 크기에 무엇을 얼마나 넣을 수 있나」에 달려 있다.

웹 글이 나은지 답하려면 파라미터 2,760만 개짜리 루나에 지식이 얼마나 들어가는지부터 알아야 해요. 그걸 직접 측정한 연구가 있어요.
역사: 지식을 비트로 세다
MLP 를 지워 보던 날 선생님이 「1,000번 본 지식은 MLP 를 빼도 담기는 양이 그대로」라며 잠깐 꺼낸 연구가 있다. 여러 단계 찾기 시험을 만든 「언어 모델의 물리학」 연작의 3.3부(알렌주·리, 2024, ICLR 2025)로, 모델에 담기는 지식의 양을 직접 측정했다. 지어낸 사람들의 전기처럼 정답이 정해진 지식을 만들어 모델에 읽히고, 모델이 그 지식을 얼마나 정확히 담았는지를 정보량(비트)으로 셌다. 결론은 지식 하나를 학습 중에 1,000번 본 경우, 파라미터 하나에 약 2비트가 담긴다는 것이었다. 크기가 백만 개부터 5억 개까지인 GPT-2 들에서 가장 잘 담은 값이 2를 넘었고, 모든 모델이 2.3 이하였다. 같은 지식을 100번만 보면 약 1비트로 줄었다. 그리고 학습 글의 8분의 7이 쓸모없는 글이고 쓸 만한 지식을 100번 볼 때는, 담기는 양이 20분의 1로 떨어졌다.
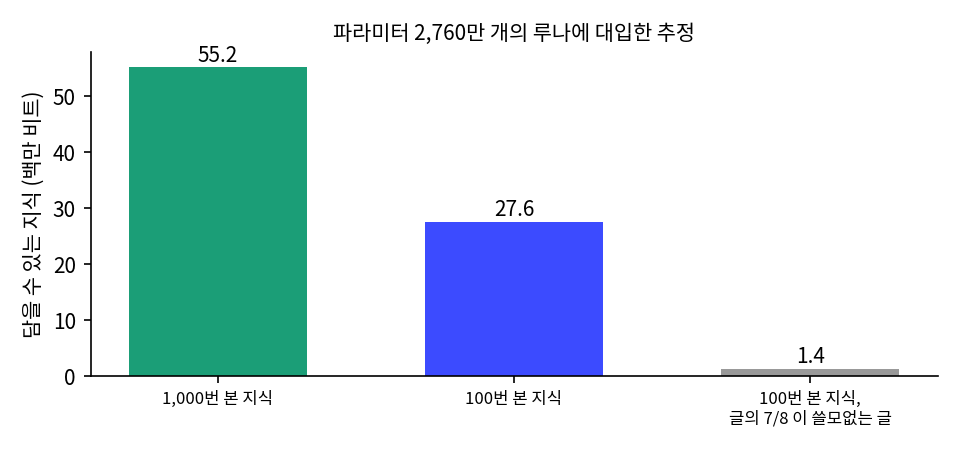
파라미터당 2비트라는 값은 지어낸 지식으로 정보이론의 하한을 측정한 것이다. 그래서 「웹 글을 읽은 7B 모델에는 140억 비트가 들어 있다」처럼 다른 모델에 그대로 옮기면 추정이 된다. 우리도 아래에서 그 추정을 한다는 것을 밝혀 둔다.
루나에 대입하면

사실 하나를 비트로 세려면, 보기가 몇 개인지부터 정해야겠네. 「서연의 반려동물은?」에 보기가 256 개면 log₂ 256 = 8비트.

그럼 루나는 2,760만 × 2 = 5,520만 비트니까, 8 로 나누면… 690만 개. 사실 690만 개면 동화가 아니라 백과사전인데?
1,000번씩 봤을 때의 계산이에요. 100번이면 그 절반인 340만 개쯤이고요. 그런데 웹 글에서 어떤 사실이 1,000번 나오는 일이 흔할까요?
민준이 대답을 고르는 동안 서연이 공책에 표를 적었다. 계산의 출처는 sources/five/five.out 이고, 모두 논문의 비율을 옮겨 적용한 추정이라 표 제목 옆에 「추정」이라고 써 두었다.
| 경우 | 파라미터당 | 루나 전체 | 8비트짜리 사실로 치면 |
|---|---|---|---|
| 1,000번 본 지식 | 약 2비트 | 5,520만 비트 | 약 690만 개 |
| 100번 본 지식 | 약 1비트 | 2,760만 비트 | 약 340만 개 |
| 100번 본 지식, 학습 글의 7/8 이 쓸모없는 글 | 약 0.05비트 | 140만 비트 | 약 17만 개 |
비트 수보다 「몇 번 봤나」가 더 중요한 거네. 웹 글은 넓은 대신 한 사실이 몇 번 안 나오고, 루나한테 필요 없는 글이 대부분이니까 셋째 줄 쪽이고.
그래요. 반대로 동화는 좁은 대신 같은 세상이 수없이 되풀이돼요. 동화 데이터를 처음 볼 때 세어 봤던 것 기억하죠? 같은 바이트의 웹 글보다 서로 다른 낱말이 8배 적었어요. 작은 세상을 여러 번 보여 주면, 루나가 그 세상을 담을 자리는 넉넉해요.
문제 3. 담을 수 있는 것과 배운 것
루나에 대입한 표의 첫 줄은 「1,000번 본 지식이라면 약 690만 개의 8비트 사실」이었다. (가) 동화 GPT 를 학습할 때 루나는 학습 글을 0.83 바퀴 읽었다. 학습 글에 딱 한 번 나오는 사실은 몇 번 본 셈인가? (나) 그 사실은 표의 어느 줄에도 해당하지 않는데, 그렇다면 그 사실을 루나가 꺼내 말할 수 있으려면 학습 글을 어떻게 고쳐야 할까? (다) 「파라미터가 비트를 담을 자리가 있다」와 「루나가 그 사실을 꺼내 말한다」는 같은 말인가?
(가)는 0.83 바퀴니까 한 번도 못 본 경우도 있겠다. 기껏해야 한 번이고.
(나)는… 그 사실이 여러 번 나오게 학습 글에 넣어야지. 같은 문장을 백 번? …아니다, 그건 기출 문제집을 다섯 번 돌린 거랑 같지.

맞아, 아까 시드 이야기를 하며 꺼낸 그 실험이 그거였어. 동화 속 우리 사실 열 가지를 한 문형만 되풀이하면 그 문장은 외우는데, 다르게 물으면 30.0% 밖에 못 맞혔어. 바꿔 쓴 글을 섞어 읽혀서야 51.7% 가 됐고.
그래요. 같은 연작의 3.1부도 같은 것을 보고했어요. 한 사람에 전기 하나만 읽혔을 때는 묻는 말에 9.7% 만 답했는데, 전기 다섯 개를 문장 순서까지 섞어 바꿔 쓰자 96.6% 가 됐어요. (다)는요?
아니네. 비트 수는 담을 자리가 얼마나 되는지고, 꺼내 쓰는 건 어떻게 읽혔느냐에 달렸어. 자리가 남아도 한 문형으로만 읽히면 못 꺼내.
그래요. 자리가 있다는 것과 꺼내 쓴다는 것은 따로라서, 무엇을 몇 번, 어떤 문장으로 읽힐지가 그 루나의 범위를 정해요.