비교하려면 시드 사이의 차이부터: 시드 셋
같은 설정으로 두 번 학습해도 결과는 조금씩 다르다. 처음 파라미터를 뽑는 난수, 배치를 고르는 난수, GPU 의 계산 순서가 매번 달라질 수 있기 때문이다. 이 차이보다 작은 차이는 「바꾼 것 때문에 나아졌다」고 말할 수 없다. 그래서 루나를 바꾸는 비교를 시작하기 전에, 아무것도 바꾸지 않은 루나끼리 결과가 얼마나 다른지부터 확인했다. 앞으로 이 책의 모든 비교는 이 측정에서 출발한다.

그거야 금방이지. 동화 GPT 스크립트에 시드만 받게 해서 두 번 더 돌리면 돼.
책 본문의 동화 GPT(시드 1337)와 같은 설정, 같은 14,000 스텝으로 시드 2 와 3 을 학습했다. 이번에 바꾼 것은 처음 파라미터를 뽑는 시드뿐이고, 배치를 뽑는 순서는 셋이 같다.
  시드 1337 (본문): 스텝 500 0.7803, 스텝 5000 0.4964, 스텝 10000 0.4442 | 검증 글 전체 바이트당 비트 0.4253
  시드 2: 스텝 500 0.7775, 스텝 5000 0.4965, 스텝 10000 0.4447 | 검증 글 전체 바이트당 비트 0.4256
  시드 3: 스텝 500 0.7815, 스텝 5000 0.4973, 스텝 10000 0.4448 | 검증 글 전체 바이트당 비트 0.4256
  셋의 끝 값 범위 0.4253~0.4256, 폭 0.0003
(sources/five/five.out, 학습 기록은 sources/tinystories/train_tinystories.out, sources/baseline/p0_s2.out, p0_s3.out.)
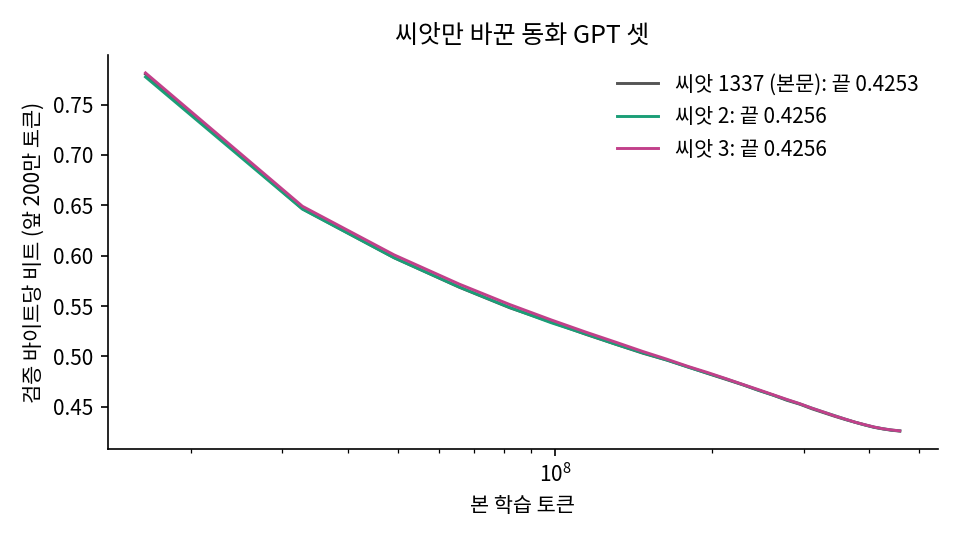
학습 초반에는 세 루나가 0.004 쯤 벌어져 있다가, 끝에서는 검증 글 전체의 바이트당 비트가 0.4253~0.4256 으로 0.0003 안에 모인다. 시드 2·3 은 RTX 4090 한 장에서 학습에 각각 937초(15.6분)가 걸렸고, 샘플을 뽑는 시간까지 넣으면 949초 안팎이다. 본문의 시드 1337 은 940초(15.7분)였다.
0.0003 이면 거의 같은 루나네. 그럼 다음에 뭘 바꿨을 때 0.001 만 좋아져도 진짜라고 할 수 있어?

바이트당 비트로는 그렇게 볼 수 있어요. 다만 오늘은 처음 파라미터만 바꿨고 읽는 순서는 같았어요. 그리고 우리가 뒤에서 볼 점수는 바이트당 비트가 아니라 문항 몇십 개, 몇백 개의 정답률이에요. 그런 점수가 시드만 바꿔도 얼마나 움직이는지는 이미 한 번 본 적이 있어요.

아, 동화 속 우리 사실 열 가지. 그때는 같은 동화 GPT 에서 출발하고 시드로 배치를 뽑는 순서를 바꿨는데, 사실을 한 문형으로 넣은 300 편을 읽은 루나가 시드마다 32.5%, 27.5%, 30.0% 였어. 물음 40 개짜리 정답률이 시드만 바꿔도 5%p 움직였네.

그런데 바꿔 쓴 글을 읽은 루나는 47.5~57.5% 였잖아. 두 쪽 범위가 안 겹쳐. 평균으로는 30.0% 대 51.7%, 21.7%p 차이니까 시드 사이의 차이 5%p 보다 훨씬 컸던 거네(sources/synthetic-data/run_synth.out).
그래요. 그 비교를 믿을 수 있었던 것은 바꿔 쓰기가 만든 차이가 시드만 바꿔서 생기는 차이보다 컸기 때문이에요. 앞으로의 비교는 모두 이 순서로 해요. 같은 실험을 시드만 바꿔 돌렸을 때 결과가 움직이는 폭을 먼저 알고, 그 폭보다 큰 차이만 믿어요. 바이트당 비트에서는 그 폭이 오늘 측정한 0.0003 이고, 시험지 점수의 폭은 시험지를 만든 뒤에 다시 측정해요.
문제 2. 0.0002 좋아진 루나
민준이 무언가를 바꾼 루나를 시드 하나로 학습했더니 검증 글 전체의 바이트당 비트가 0.4251 이 나왔다. 바꾸지 않은 루나 셋은 0.4253, 0.4256, 0.4256 이다. (가) 바꾼 루나가 나아졌다고 말할 수 있나? (나) 바꾼 루나도 시드 셋으로 돌려 0.4251, 0.4250, 0.4252 가 나왔다면? (다) (나)에서도 조심할 것이 있다면 무엇인가?
(가)는 0.4251 이 셋보다 다 낮으니까 나아진 거 아냐?
하나만 돌렸잖아. 바꾼 루나도 시드를 바꾸면 0.4254 가 나올 수도 있어. 바꾸지 않은 셋끼리도 0.0003 벌어졌는데, 차이가 0.0002 면 그 안에 들어가.
그래요. 한 번 측정한 값을 시드마다 다른 셋과 비교하면, 운 좋은 한 번인지 알 수 없어요. (나)는요?
셋 다 0.4250~0.4252 고, 안 바꾼 쪽은 0.4253~0.4256. 범위가 안 겹치네. 이번엔 나아졌다고 해도 되겠는데요.

그래도 (다)는 있어. 우리가 바꾼 건 처음 파라미터 시드뿐이었잖아. 데이터 순서까지 바꿔도 범위가 안 겹칠지는 확인 안 해 봤고, 0.0002 차이가 쓸 만한 차이인지도 따로야.
둘 다 맞아요. 이 책에서는 시드 셋 모두에서 같은 쪽으로 갈리고 범위가 겹치지 않을 때만 「나아졌다」고 써요. 그리고 바이트당 비트가 진짜로 내려갔어도, 루나가 무엇을 더 잘하게 됐는지는 시험으로 따로 봐야 해요.