헤드와 합성곱 채널: 같은 점과 다른 점
헤드를 하나씩 지운 표를 보던 민준이 합성곱을 배울 때 쓴 노트를 꺼냈다.
헤드 넷이 각자 다른 걸 본다는 말, 어디서 들은 것 같아. 합성곱에서 탐지기를 여러 개 나란히 걸었잖아. 헤드가 결국 채널 아니야?

같은 데도 있어. 나란히 걸어 놓고 각자 다른 것에 반응하게 하고, 나중에 합치는 거. 어느 탐지기가 무엇을 볼지 학습이 정하는 것도 같고. 그런데 파라미터가 달라. 채널은 늘릴수록 커널이 늘잖아. gpt.py 의 헤드는 쿼리·키·값 행렬 d × 3d 를 나눠 쓰니까 헤드를 늘려도 파라미터는 그대로고, 헤드 하나의 폭만 줄어.

그래서 아까 헤드마다 폭 256 을 그대로 준 모델을 따로 측정했던 거구나. 채널처럼 늘린 쪽이 그거고.
응. 그런데 그 실험도 「나누면 낫다」까지만 말해 줘. 헤드 하나가 채널 하나처럼 「무엇을 찾을까」를 맡는 건지는 아직 몰라.
역사: 헤드로 합성곱을 흉내 내기
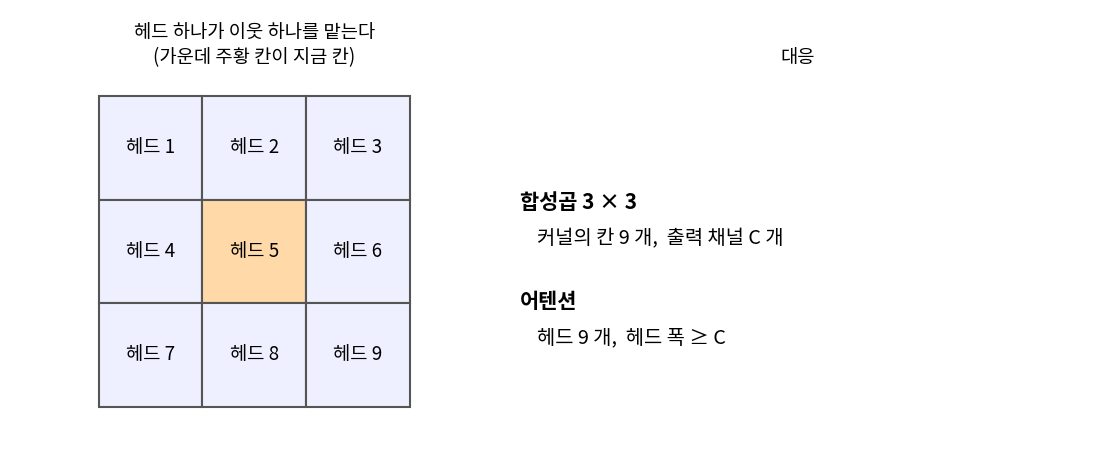
어텐션과 합성곱을 직접 비교한 논문이 있다. 코르도니에(Jean-Baptiste Cordonnier), 루카스(Andreas Loukas), 야기(Martin Jaggi)의 「On the Relationship between Self-Attention and Convolutional Layers」(ICLR 2020)다. 그들은 상대 위치 정보를 주면 헤드 N 개짜리 어텐션 층이 한 변 √N 칸인 커널의 합성곱을 무엇이든 표현할 수 있음을 증명했다. 3 × 3 커널이면 헤드 9 개로, 칸마다 헤드 하나가 정해진 이웃 하나를 맡으면 된다. 작은 사진 분류 데이터 CIFAR-10 으로 헤드 9 개 어텐션을 학습하자 헤드들은 실제로 지금 칸 둘레의 격자 모양 이웃을 하나씩 나눠 보았다. 이 대응에서 헤드는 채널이 아니라 커널의 한 칸이다. 민준의 「헤드가 곧 채널」은 그래서 절반만 맞다. 나란히 걸어 놓고 다른 것을 찾는다는 점은 같지만, 헤드 하나가 정하는 것은 「어디를 읽을까」이고 채널 하나가 정하는 것은 「무엇을 찾을까」에 가깝다.