헤드 하나로는 왜 느린가: 평균 하나의 한계
다시 얌전한 헤드 수 표를 앞에 두고 서연은 트랜스포머 논문의 그 문장을 한 번 더 읽었다.

「헤드 하나로는 평균을 내는 일이 이를 가로막는다」. 동화 표는 차이가 작아서 정말 그런지 모르겠어. 평균이 문제라면 평균으로는 못 하는 문제를 일부러 내 볼 수 없어?

한 군데 말고 여러 군데를 읽어야 맞히는 문제? 값을 합치면 어느 게 어느 건지 헷갈리는 걸로.
헤드 하나가 위치 t 에서 내놓는 값은 앞 토큰들의 값 벡터를 어텐션 비중으로 평균한 벡터 하나다.
비중 ws 는 모두 0 이상이고 합이 1 이라서, 헤드 하나는 값들을 빼지 못하고 섞기만 한다. 층이 하나뿐이면 값 벡터 vs 는 토큰 임베딩과 위치 임베딩을 더한 것의 변환이어서, 그 자리의 숫자와 위치를 떼어 놓을 수 없게 묶어 주지도 못한다. 이 조건에서 평균이 약점이 되는 장난감 태스크를 만들었다.
문제 2. 평균만 알려 주는 친구
친구가 수학과 영어 두 과목을 보고, 시험 결과를 평균 점수 하나로만 알려 준다. (가) 평균이 80 이면 두 과목 점수를 알 수 있는가? 어느 과목이 더 높은지 알 수 있는가? (나) 친구가 「수학에 2/3, 영어에 1/3 을 곱해 더한 값」을 알려 주면 무엇이 달라지는가? 점수가 0~100 의 정수라면 이 값으로 두 점수를 언제나 가려낼 수 있는가? (다) 친구 둘이 각각 한 과목씩 알려 주면 어떤가?

(가)는 안 돼. 70 과 90 이든, 90 과 70 이든 평균이 80 이야. 어느 쪽이 높은지도 몰라.
(나)는 90, 70 이면 83.3… 이고 70, 90 이면 76.6… 이니까 순서는 갈리네. 그런데 언제나 가려지나? 수학을 1 올리고 영어를 2 내리면 2/3 − 2/3 = 0 이라 값이 그대로야. 80 과 80, 81 과 78 이 둘 다 80 이니까 안 돼.
그럼 비중을 더 치우치게 주면 되겠네. 수학에 101/102, 영어에 1/102 를 주면 영어 점수가 수학 1 점 차이를 넘지 못하니까 가려져.

맞아요. 숫자를 끝까지 정확히 읽을 수 있다면요. 그런데 그 값을 소수 셋째 자리까지만 읽을 수 있거나 과목이 넷으로 늘면 어떻게 될까요?
칸이 모자라요. 과목이 많을수록 비중을 점점 더 치우치게 줘야 하는데, 알아볼 수 있는 자릿수는 그대로고요.
(다)는 그냥 두 수를 그대로 받는 거니까 고민할 게 없고요.
헤드 하나가 내놓는 것도 앞 토큰 값들의 평균 하나예요. 이 문제를 기억해 두고 장난감 태스크를 봐요.
장난감 태스크: 몇 군데를 동시에 읽어야 하는가
입력은 0~9 숫자 토큰 16 개와 물음 토큰 하나인데, 물음 토큰이 가리키는 자리들의 숫자를 읽어야 답할 수 있다. 층은 하나, 폭은 64 이고 헤드 수만 1, 2, 4, 8 로 바꾼다(폭을 나눠 쓰므로 파라미터는 모두 70,656 개로 같다). 물음 토큰은 240 가지다. 스텝마다 새 문제 512 개를 만들어 8,000 스텝 학습하니 데이터가 모자라 생긴 차이는 아니다. 시드는 셋이다.
| 태스크 | 답 | 읽을 군데 |
|---|---|---|
| 한 군데 | x_a | 1 |
| 두 군데 합 | x_a + x_b | 2, 순서 상관없음 |
| 두 군데 차 | x_a − x_b | 2, 순서가 중요 |
| 세·네·여섯 군데 | x_a − x_b + x_c − x_d … | 3, 4, 6, 더하는 자리와 빼는 자리가 번갈아 |
| 네 군데 합 | x_a + x_b + x_c + x_d | 4, 부호가 모두 같음 |
묶음         과제      층  헤드      평균      최소      최대 시드 수
d64_easy   first   1   1  1.0000  1.0000  1.0000    3
d64_easy   sum     1   1  0.9610  0.9490  0.9713    3
d64        diff    1   1  0.9498  0.9378  0.9625    3
d64        k3      1   1  0.1124  0.1023  0.1306    3
d64        k3      1   8  1.0000  1.0000  1.0000    3
d64        k4      1   1  0.2096  0.0934  0.3038    3
d64        k4      1   2  0.8255  0.7801  0.8551    3
d64        k4      1   8  0.9849  0.9589  0.9997    3
d64_a4     a4      1   1  0.9515  0.9369  0.9751    3
summary.out 뒷부분에서 줄을 골랐다(first 는 한 군데, sum·diff 는 두 군데 합·차, k3·k4 는 세·네 군데, a4 는 네 군데 합). 찍을 때의 정답률(언제나 가장 흔한 답을 낼 때)은 한 군데·두 군데 0.100, 세 군데 0.075, 네 군데 0.067 이다. 8,000 스텝 안에서 헤드 하나는 한 군데와 두 군데까지 잘하고(합 0.9610, 차 0.9498) 세 군데에서 0.1124 로 곤두박질친다. 여섯 군데도 헤드 하나는 0.0570 으로 찍는 수준이고 헤드 8 개는 0.9670 이다. 헤드 8 개는 어느 태스크든 0.96 을 넘는다. 헤드 둘은 시드마다 갈린다(세 군데에서 0.1032~0.9396).
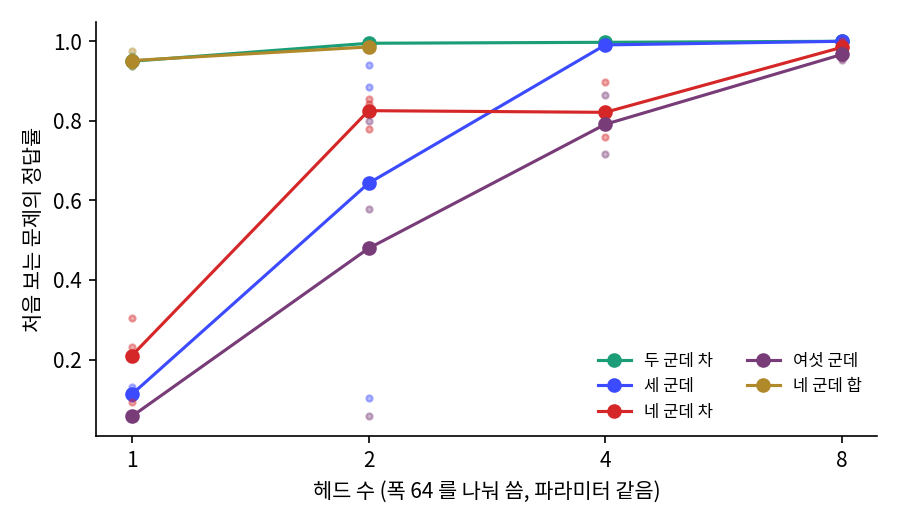

이건 얌전하지 않은데! 세 군데부터 헤드 하나는 찍는 수준이야. 파라미터는 똑같은데.

잠깐, 두 군데 차는 헤드 하나로 왜 돼? 평균이 문제라면 x_a 랑 x_b 가 섞여서 순서를 잃어야 하잖아. 아까 문제에서도 평균으로는 어느 쪽이 큰지 몰랐는데.
어디를 보는지 측정해 볼게.
[두 군데 차, 헤드 1 개]
  헤드 1: 빼이는 쪽(앞 자리) 0.603, 빼는 쪽(뒤 자리) 0.339, 둘의 합 0.942

0.603 이랑 0.339. 반반이 아니야! 비중을 다르게 줘서 둘을 구별하는 거네. 수학에 2/3, 영어에 1/3 곱한 친구랑 똑같아.
그럼 네 군데 차는 어떻게 했는지도 보자. 헤드 1, 2, 4 개.
[헤드 1 개] 정답률 0.1101
  헤드 1: 네 자리 비중 평균 0.289 0.178 0.327 0.176 | 합 0.970 | 나머지 숫자 자리 합 0.028 | 물음 자기 자리 0.002
[헤드 2 개] 정답률 0.7810
  헤드 1: 네 자리 비중 평균 0.059 0.357 0.067 0.355 | 합 0.838 | 나머지 숫자 자리 합 0.153 | 물음 자기 자리 0.009
  헤드 2: 네 자리 비중 평균 0.372 0.041 0.384 0.041 | 합 0.837 | 나머지 숫자 자리 합 0.152 | 물음 자기 자리 0.011
[헤드 4 개] 정답률 0.7471
  헤드 1: 네 자리 비중 평균 0.016 0.521 0.019 0.398 | 합 0.953 | 나머지 숫자 자리 합 0.044 | 물음 자기 자리 0.003
  헤드 2: 네 자리 비중 평균 0.030 0.399 0.018 0.494 | 합 0.940 | 나머지 숫자 자리 합 0.056 | 물음 자기 자리 0.004
  헤드 3: 네 자리 비중 평균 0.397 0.037 0.380 0.026 | 합 0.840 | 나머지 숫자 자리 합 0.150 | 물음 자기 자리 0.010
  헤드 4: 네 자리 비중 평균 0.144 0.124 0.129 0.121 | 합 0.517 | 나머지 숫자 자리 합 0.458 | 물음 자기 자리 0.025
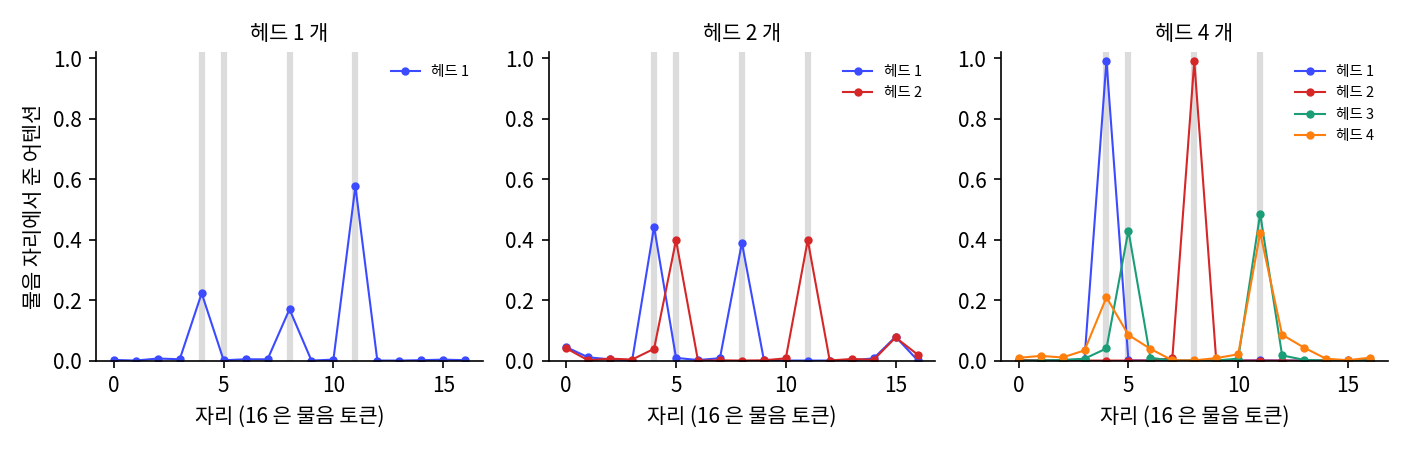
헤드 2 개 모델의 표를 위아래로 읽으면 헤드 1 은 둘째·넷째 자리에 0.357, 0.355 를, 헤드 2 는 첫째·셋째 자리에 0.372, 0.384 를 준다. 물음이 가리킨 자리 가운데 빼는 자리와 더하는 자리를 헤드가 하나씩 맡았으니, 헤드 하나 안에서는 합만 내면 되고 부호가 다른 값끼리 섞이지 않는다. 시드 1, 2 의 헤드 2 개 모델도 같은 모양이다(toy_view2.out, 헤드마다 한쪽 부호 자리에 0.37~0.39, 다른 쪽에 0.04~0.05). 트랜스포머 논문이 말한 「서로 다른 표현 부분 공간의, 서로 다른 위치」가 이 모델에서는 부호별로 나뉜 두 헤드로 나타났다. 다만 늘 그렇게 나누는 것은 아니어서, 두 군데 차를 배운 헤드 2 개 모델(시드 0)은 두 헤드가 앞 자리에 0.32, 0.33, 뒤 자리에 0.54, 0.51 로 비슷하게 읽었다.
이 설명이 맞다면, 읽을 군데가 넷이어도 부호가 모두 같은 「네 군데 합」은 헤드 하나로 될 것이다. 평균을 내도 잃는 것이 없기 때문인데, 표의 마지막 묶음이 그 예측을 시험한 결과다.
네 군데 합은 헤드 하나로 평균 0.9515 다. 읽을 군데가 같은 네 군데 차(0.2096)와 비교하면 어려운 것은 군데 수 자체가 아니었다. 합쳐도 잃는 것이 없으면 평균 하나로 금세 배우고, 값끼리 구별해야 할 때 평균이 걸림돌이 된다.
헤드가 많아서 푸는 게 아니었네. 더하는 자리랑 빼는 자리를 헤드 하나씩 맡으니까 부호가 안 섞이는 거야.
그래서 네 군데 합은 하나로도 됐구나. 섞어도 잃는 게 없으니까.
층을 쌓거나 폭을 넓히면 헤드 하나로도 네 군데 차를 풀 수 있어요?
측정해 봤어요. 네 군데 차, 헤드 하나, 8,000 스텝이에요.
묶음         과제      층  헤드      평균      최소      최대 시드 수
d64_L2     k4      2   1  0.5945  0.1220  0.8364    3
d128       k4      1   1  0.5421  0.4008  0.7654    3
d256       k4      1   1  0.0705  0.0682  0.0751    3
summary.out 에서 옮긴 줄이다(d64_L2 는 폭 64 에 층 둘, d128·d256 은 층 하나에 폭 128·256). 층을 쌓거나 폭을 128 로 넓히면 시드에 따라 0.12 에서 0.84 까지 갈리고, 폭 256 은 0.0705 로 찍을 때(0.067)와 거의 같다. 폭 256 에서는 넓히는 것이 오히려 방해가 됐다.

그럼 헤드 하나는 세 군데를 아예 못 하는 거네요.

세 군데는 못 한다기보다 느려요. 스텝을 다섯 배인 40,000 으로 주면 헤드 하나의 세 군데도 시드 셋 평균 0.8415 까지 올라요(summary.out 「스텝을 늘리면」). 헤드 8 개는 8,000 스텝에 1.0000 이고요. 다만 여섯 군데는 40,000 스텝에서도 0.0822 라서, 이 말은 네 군데(0.7610)까지예요. 스텝 수만의 효과인지 학습률 스케줄 때문인지는 가르지 않았으니 「이 학습 스케줄에서는 느리다」까지만 말해요.
ML에서: 큰 언어 모델에도 이런 일이 일어날까
우리 장난감 태스크는 층이 하나뿐이고, 답을 내려면 값들을 정해진 방식으로 합쳐야 한다. 실제 언어 모델은 층이 많고 글에는 이런 산수가 드물어서, 동화 표처럼 헤드 수의 차이가 작게 나오는 것이 오히려 자연스럽다. 장난감에서 헤드 수가 크게 가른 것도 할 수 있느냐보다 정해진 학습량 안에 배우느냐였으니, 미헬 팀이 남긴 학습 과정과의 관계와 같은 방향의 관찰이지만 그 이상을 말해 주지는 않는다. 그래도 모델을 키울 때는 헤드 수도 함께 늘리는 것이 관례다. 우리 동화 GPT 는 폭 512 에 헤드 8 개(헤드 하나의 폭 64)를 썼고, 이 책이 따라가는 nanochat 의 학습 스크립트(scripts/base_train.py)는 헤드 하나의 폭을 설정으로 받아 모델 폭을 그 값으로 나눠 헤드 수를 정한다.
서연은 공책 첫 장에 적어 둔 물음 「파라미터가 그대로인데 헤드를 왜 나눌까」 아래에 두 줄을 옮겨 적었다(sources/gpt-parts/summary.out, 시드 셋 평균).
| 측정한 것 | 헤드 1 개 | 헤드 2 개 | 헤드 8 개 |
|---|---|---|---|
| 장난감 네 군데 차 정답률 | 0.2096 | 0.8255 | 0.9849 |
| 작은 GPT 의 바이트당 비트 | 0.6252 | 0.6192 | 0.6099 |
나누는 건 일을 나누는 거였어. 파라미터는 한 개도 안 늘었는데 네 군데 차가 0.21 에서 0.83 이 됐잖아.
대신 아랫줄은 0.6252 랑 0.6099. 동화에는 부호가 다른 값을 가려 읽을 일이 별로 없나 봐.
헤드 하나는 앞 토큰 값들의 평균 하나만 내므로, 값끼리 가려내야 하는 문제를 이 학습 스케줄 안에서는 느리게 배운다. 둘로 나누면 더하는 자리와 빼는 자리를 헤드가 하나씩 맡는다. 동화 글에서 헤드 1 개와 8 개가 바꾸는 바이트당 비트는 0.0153 이다.