다섯 살 시험지: 무엇을 측정하고, 누구 기준으로 채점할까
첫 성적표
시험지를 믿을 수 있게 되자, 서연은 두 루나의 이름을 성적표 맨 위에 적었다. 동화만 읽은 루나 셋(시드 1337, 2, 3)과, 같은 셋에 대화를 읽혀 묻는 말에 답하게 한 루나 셋이다. 한 루나를 채점하는 데 RTX 4090 한 장에서 9초쯤 걸렸다. 비교를 위해 웹 글을 읽은 GPT-2(파라미터 1억 2,400만 개)와 GPT-2 XL(15억 개)도 같은 문항으로 측정했다.
| 칸 | 동화만 읽은 루나(시드 셋) | 대화로 가르친 루나(시드 셋) | GPT-2 | GPT-2 XL |
|---|---|---|---|---|
| 수학 | −0.093 ~ −0.084 | −0.087 ~ −0.080 | −0.095 | −0.057 |
| 논리 | −0.150 ~ −0.112 | −0.120 ~ −0.050 | −0.122 | −0.008 |
| 윤리 | 0.380 ~ 0.455 | 0.444 ~ 0.460 | 0.102 | 0.241 |
| 상식 | 0.387 ~ 0.471 | 0.452 ~ 0.477 | 0.343 | 0.505 |
| 루나 사실 | 0.039 ~ 0.111 | 0.022 ~ 0.048 | 0.114 | 0.149 |
| 설정서 점수 | 0.127 ~ 0.150 | 0.148 ~ 0.168 | 0.068 | 0.166 |
(중심화 점수, 완성형. sources/benchmark/results/v1_report.out)
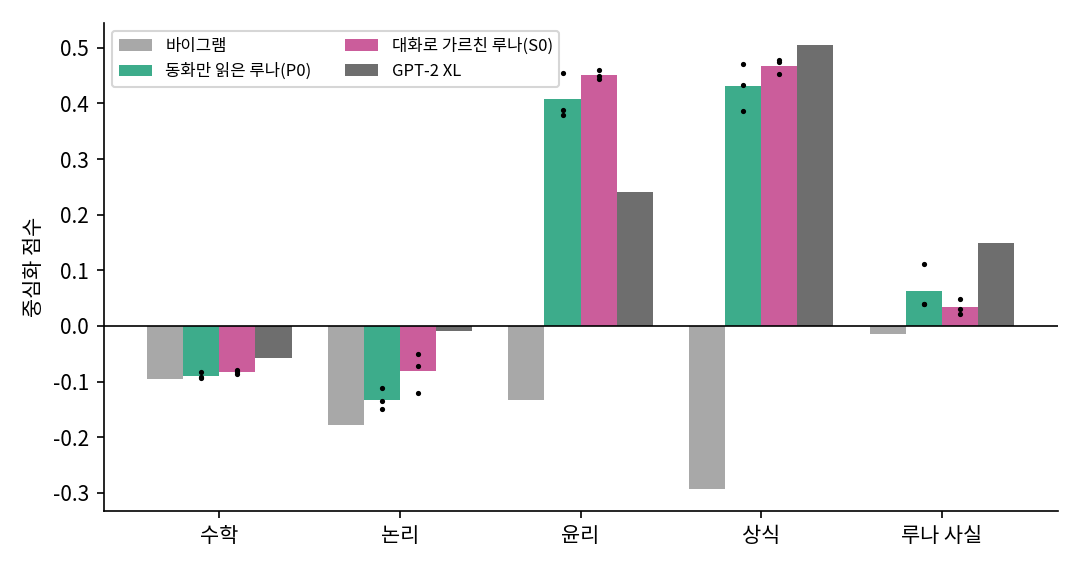

윤리는 루나가 GPT-2 XL 보다 높아. 0.38 이 넘어.

이 칸의 정답은 두 사람이 그린 루나, 나누고 돕는 아이가 하는 쪽이고, 문항은 동화의 말로 썼어요. 루나는 그런 동화만 읽었고 GPT-2 는 웹 글을 읽었어요. 이 칸 점수는 「동화 속 아이처럼 판단하는가」에 가까워요.

수학이랑 논리는 다 0 아래야. GPT-2 XL 까지. 사과 셋에서 하나 먹으면 몇 개 남는지는 다섯 살이면 아는 건데.
수학 칸의 줄을 하나씩 보면 루나는 산수 문항에서 우연 근처(이야기 산수 3.5~4.5%, 우연 4.8%)이고, 수 비교 짝은 1.5~4.5% 로 우연(25%)보다 훨씬 낮다. 「누가 더 많이 가졌나」의 짝 두 문항에 같은 이름을 고르기 때문일 것인데(문항마다 고른 보기는 이 표에 없다), 논리 칸도 마찬가지다. 「어디 있나」는 30.5~39.0% 로 우연(16.6%)보다 높지만, 참과 거짓 짝은 0.2~15.9% 다. 동화만 읽은 루나는 참과 거짓 문항의 대부분에서 짝의 두 문항에 같은 답을 냈다.
평균 밖의 공개 다리에서는 문법 짝(두 문장 가운데 문법에 맞는 쪽 고르기)을 두 루나 여섯이 75.3~82.3%, GPT-2 가 94.5% 맞혔다(우연 50%). 동화 말투의 문장은 맞게 고르지만, 웹 글을 읽은 모델과는 아직 거리가 있다.
루나 사실은 거의 0 이다. 새 루나가 다섯 살이고, Minjun 이 Daddy, Seoyeon 이 Mommy 라는 사실을 루나는 아직 읽은 적이 없다. 아직 가르치지 않은 것이니 0 이 맞는 점수다. 일부러 가르치지 않을 사실을 묻는 감시 줄은 16.7~30.0% 였는데, 문항이 30개뿐이라 우연(16.7%)과 갈리지 않는다.

대화로 가르친 루나가 설정서 점수가 조금 높네. 0.148 에서 0.168, 동화만 읽은 쪽은 0.127 에서 0.150.
시드 셋 모두에서 같은 쪽인가요? 범위는 겹치지 않나요?

…시드 2 는 대화 쪽이 0.001 낮아요. 범위도 0.148 과 0.150 이 겹치고요.

그러면 지난번에 정한 규칙대로, 「나아졌다」고 쓰지 않아요. 칸마다 봐도 수학, 윤리, 상식은 세 시드 모두 대화 쪽이 높지만 범위가 겹쳐요. 대화로 가르친 것은 답하는 형태였지, 산수이나 사실이 아니었으니까요.
대우 문항에서
성적표를 받은 저녁, 서연은 참과 거짓 줄의 개발 문항을 몇 개 골라 민준에게 내 보았다.
「If the cake is ready, Ned will jump. Ned did not jump. Is it true that the cake is ready?」
음… 모르지. 케이크가 됐는데 네드가 깜빡했을 수도 있잖아.
No. 케이크가 됐으면 네드는 무조건 뛰어. 안 뛰었으니까 케이크는 아직이야. 다음. 「If it is sunny, Amy will go out. Amy went out. Is it true that it is sunny?」

이건 yes.
We cannot tell. 해가 나면 나간다고 했지, 비 오는 날엔 안 나간다고는 안 했잖아. 아까는 확실한 걸 모른다고 하고, 지금은 모르는 걸 안다고 하네.
…루나랑 같은 데서 틀렸네, 나.
「p 이면 q 이다」에서 q 가 아니면 p 도 아니다(대우). 그러나 q 라고 해서 p 라고 할 수는 없다(역). 정답이 「we cannot tell.」인 시험 문항 100 개에서, 두 루나 여섯과 GPT-2, GPT-2 XL 가운데 이 보기를 한 번이라도 고른 모델은 없었다(sources/report-card/figs.out). 시험 문항을 외운 복제본은 참과 거짓 줄 전체(800 문항)를 99.9% 맞히니, 채점이 이 보기를 막고 있는 것은 아니다. 루나도 웹 글을 읽은 큰 모델도, 아직 「모른다」로 답할 줄 모른다.