다섯 살 시험지: 무엇을 측정하고, 누구 기준으로 채점할까
시험지를 시험하기
시험지를 만들었으면, 루나에게 내기 전에 시험지부터 시험한다. 시험지가 문항을 읽지 않고도 맞힐 수 있게 만들어졌다면, 루나가 받은 점수에는 실력 말고 시험지가 흘린 단서가 섞인다.

시험지를 시험하는 학생은 두 종류예요. 하나는 아무것도 모르는 학생이에요. 늘 첫 보기를 고르는 학생, 가장 흔한 답만 고르는 학생, 문맥에 마지막으로 나온 낱말을 고르는 학생, 그리고 동화에서 낱말이 얼마나 흔한지만 아는 모델이요. 이 학생들은 우연 근처여야 해요. 다른 하나는 답을 다 외운 학생이에요. 시험 문항의 정답을 일부러 외우게 한 루나의 복제본이요. 이 학생이 95% 를 못 넘으면 문항이나 채점 방법에 잘못이 있어요.
동화에서 낱말 하나만 보는 모델을 유니그램 모델, 바로 앞 토큰 하나를 보고 다음 토큰을 고르는 모델을 바이그램 모델이라 부른다. 둘 다 문항의 뜻은 읽지 못하고 낱말이 얼마나 흔한지, 어떤 낱말 뒤에 무엇이 자주 오는지만 안다.
처음 걸린 것은 딥시크가 쓴 상식과 교훈이었다. 상식 후보는 「Ben is very tired, so he will go to」 → bed / the moon 처럼 오답을 말이 안 되는 끝으로 썼고, 교훈 후보는 「to always say sorry when wrong」의 오답을 「to never say sorry when wrong」처럼 not 이나 never 를 붙여 만들었다. 바이그램 모델이 이 문항들을 문맥 없이도 맞혔다.
# 생성 문항 판 1(문항 하나씩) 대 판 2(짝, 둘 다 맞아야 1점)의 표면 신호. 정답률 %, 채점 단위 기준
# 표시 ← 는 우연 + 3 표준오차를 넘은 것(문맥 없이 보기의 흔함만으로 맞힘)

## 판 1
  fact         단위  131 우연  50.0  unigram  59.5    bigram  64.1 ←
  lesson       단위  103 우연  50.0  unigram  72.8 ←  bigram  83.5 ←
  reason       단위  275 우연  50.0  unigram  44.7    bigram  64.0 ←
  track        단위  275 우연  50.0  unigram  65.1 ←  bigram  64.4 ←

## 판 2
  fact         단위   85 우연  25.0  unigram   0.0    bigram   1.2
  lesson_pair  단위   72 우연  25.0  unigram   0.0    bigram   0.0
  reason       단위  141 우연  25.0  unigram   0.0    bigram   0.0
  track        단위  142 우연  25.0  unigram   0.0    bigram   6.3
(sources/benchmark/results/gen_surface.out. ← 는 우연에 표준오차 세 배를 더한 값을 넘은 줄)
「the moon」은 동화에서 「go to」 뒤에 거의 안 오니까, 바이그램은 앞 낱말만 보고도 bed 를 고르는 거야. never 도 마찬가지고.
문제를 읽지도 않는 모델이 맞혔다고? 그럼 루나가 맞혔을 때도 진짜인지 몰랐다는 거잖아.
그래서 시험지를 먼저 시험하는 거예요.
역사: 낱말 하나를 바꿔 정답을 뒤집는 문항
문항을 읽지 않고 겉모양만으로 맞히는 문제는 우리 시험지에서 처음 생긴 일이 아니다. 2012년 토론토 대학의 헥터 레베스크(Hector Levesque)는 어니스트 데이비스(Ernest Davis), 레오라 모겐스턴(Leora Morgenstern)과 함께 「위노그라드 스키마 챌린지(The Winograd Schema Challenge)」를 내놓으면서, 문항을 낱말 하나만 다른 두 문장으로 만들었다. 「The city councilmen refused the demonstrators a permit because they [feared / advocated] violence.」에서 「they」는 괄호 안 낱말이 feared 이면 시의원들이고, advocated 이면 시위대다. 사람은 상식으로 쉽게 가르지만, 낱말 하나로 답이 바뀌니 어떤 낱말이 흔한지만 아는 모델은 두 문장을 모두 맞힐 수 없다.
2020년 매트 가드너(Matt Gardner) 팀은 같은 생각을 이미 쓰이던 시험지들로 넓혔다. 논문은 데이터셋에 체계적인 빈틈이 있으면 모델이 단순한 규칙으로 점수를 얻어 원래 시험지가 실력을 부풀린다고 보았다. 그래서 데이터셋 열 개에서 데이터셋을 만든 사람들이 시험 문항을 손으로 조금씩 고쳐 대개 정답이 바뀌게 했고, 이렇게 만든 문항 묶음을 대조 세트(시험 문항을 조금 고쳐 정답을 뒤집은 묶음 / contrast set)라 불렀다. 모델들은 원래 시험지보다 대조 세트에서 점수가 크게 낮았고, 많게는 25% 까지 떨어졌다(Findings of EMNLP 2020, 「Evaluating Models’ Local Decision Boundaries via Contrast Sets」).
우리 짝 문항은 이 두 생각을 다섯 살 시험지에 작게 옮긴 것이다. 같은 두 보기를 쓰고 문맥만 바꿔 정답을 뒤집으면, 보기의 흔함만 아는 바이그램은 짝의 두 문항을 함께 맞힐 수 없다.
그래서 두 줄을 짝으로 다시 만들었다. 오답도 같은 종류의 그럴듯한 낱말로 쓰고(장소 둘, 동물 둘처럼), 짝의 다른 문항에서는 그 오답이 정답이 되게 했다. 교훈은 오답을 부정형이 아니라 다른 좋은 교훈으로 썼고, 짝으로 고친 뒤에는 바이그램 모델이 짝 둘을 모두 맞히는 일이 거의 없었다.
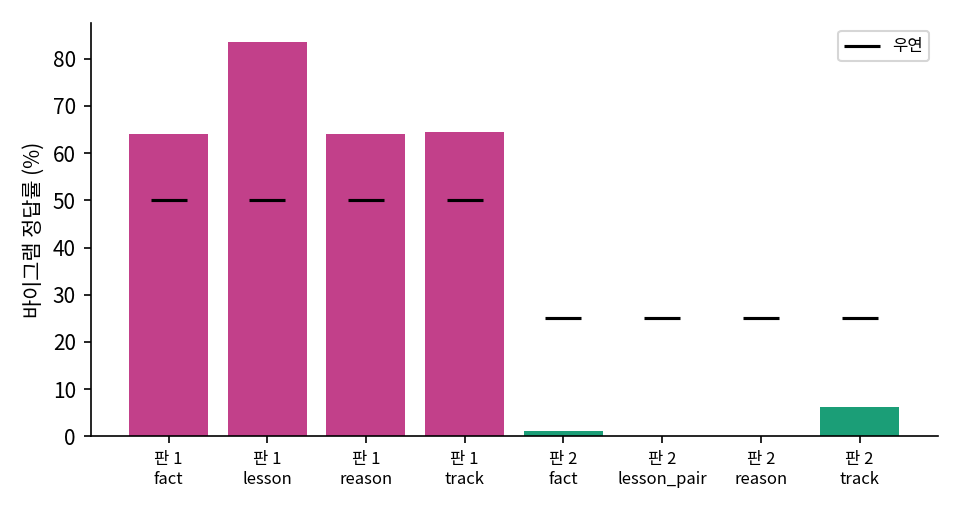
판 2 의 정답률이 우연보다도 낮은 것은 바이그램이 짝의 두 문항에 같은 보기를 고르기 때문이다. 짝으로 묶으면 문맥을 읽지 않는 모델은 0 쪽으로 밀린다.
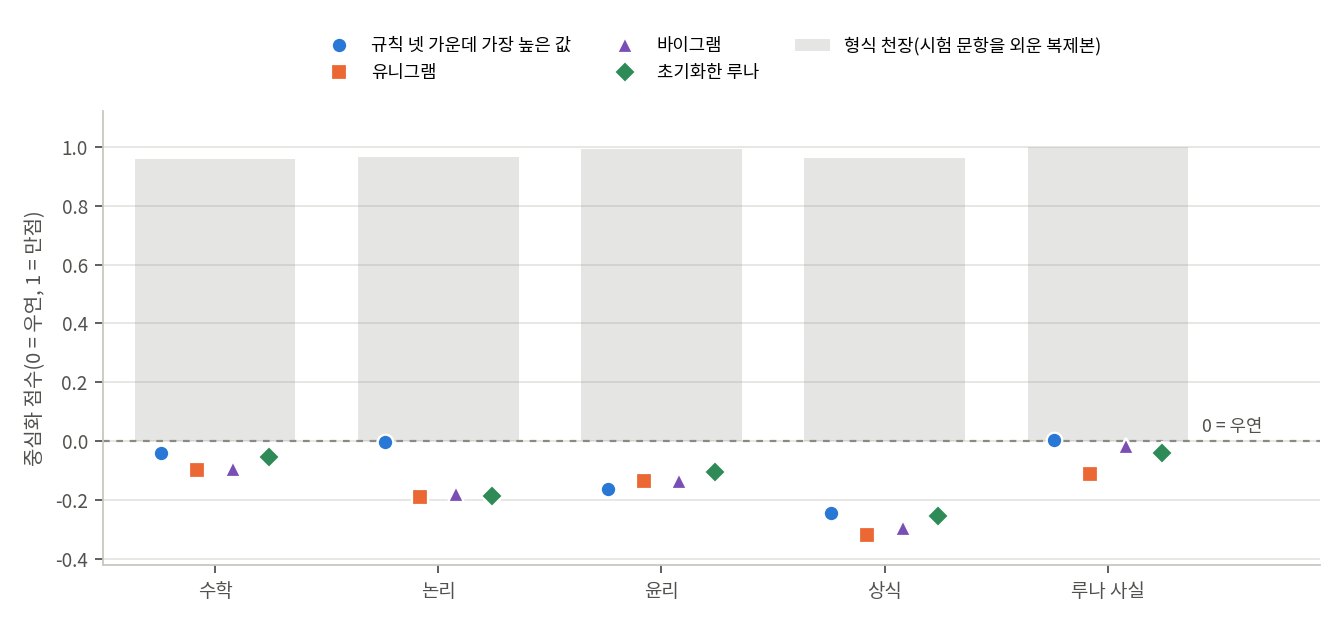
짝으로 고친 상식 가운데 한 유형은 다른 데서 걸렸다. 「앞에서 들은 것」은 정답이 문맥에 이미 나온 낱말이라, 문맥에 마지막으로 나온 보기를 그대로 베끼는 규칙이 짝의 45.5% 를 맞혔다. 동화만 읽은 루나 셋이 받은 점수도 똑같이 45.5% 였다. 이 유형은 상식이 아니라 베끼기를 측정하고 있었으므로, 칸의 평균에서 빼고 따로 두었다. 다섯 칸을 바닥 모델과 형식 천장으로 측정한 결과다(sources/benchmark/results/v1_report.out).
| 칸 | 규칙 넷 가운데 가장 높은 값 | 유니그램 | 바이그램 | 초기화한 루나 | 형식 천장 |
|---|---|---|---|---|---|
| 수학 | −0.038 | −0.098 | −0.095 | −0.053 | 0.959 |
| 논리 | −0.001 | −0.188 | −0.178 | −0.184 | 0.965 |
| 윤리 | −0.161 | −0.135 | −0.133 | −0.104 | 0.991 |
| 상식 | −0.243 | −0.318 | −0.293 | −0.252 | 0.962 |
| 루나 사실 | 0.005 | −0.110 | −0.014 | −0.039 | 1.000 |
(중심화 점수. 규칙 넷은 늘 첫 보기, 가장 흔한 정답, 문맥에 처음 나온 보기, 문맥에 마지막으로 나온 보기다. 형식 천장은 시험 문항을 4만 스텝 동안 외우게 한 복제본이다.)
바닥 모델은 다섯 칸 모두 0 근처이거나 0 아래이고, 외운 복제본은 0.959~1.000 이다. 줄 하나하나로 보면 외운 복제본은 93.0~100% 를 맞혔는데, 이야기 산수(93.5%)와 공 던지기(93.0%) 두 줄이 앞에서 정한 95% 에 조금 못 미쳤다. 시험지가 수학과 논리 여덟 줄뿐이던 때 같은 방법으로 외운 복제본은 이 두 줄을 98.0% 와 96.2% 맞혔다(sources/benchmark/results/v1_gen_first.out). 문항이 늘어 외울 것이 많아진 탓이 아닐까 추측하고 문항은 그대로 두었지만, 이 추측은 따로 확인하지 않았다. 시험지는 문항을 읽지 않는 학생에게 점수를 주지 않고, 답을 아는 학생에게는 점수를 준다. 바닥이 0 아래로 내려가는 칸이 많은 것은 짝 때문이다. 문맥을 읽지 않는 학생은 짝의 두 문항에 같은 보기를 고르기 쉽고, 그러면 짝을 하나도 못 맞힌다.
문제 3. 답을 외운 학생과 백지를 낸 학생
(가) 반에서 새로 만든 시험지로 시험을 봤는데, 시험 전에 정답지를 미리 본 학생이 70점을 받았다면 시험지에 무슨 문제가 있을까? 백지를 낸 학생이 40점을 받았다면? (나) 형식 천장을 측정하는 복제본은 시험 문항을 외우게 학습했는데, 이 복제본의 점수를 성적표에 「가장 좋은 루나」로 실어도 될까? (다) 바이그램 모델이 어느 줄에서 우연보다 크게 높게 나왔다면, 그 줄의 루나 점수에서 바이그램 점수를 빼고 실으면 될까?

(가)는 정답지를 본 학생이 70점이면 정답지랑 채점이 안 맞는 거야. 답을 아는데 틀렸다고 나오니까.

백지가 40점이면 문항이 답을 흘리고 있는 거고. 보기 가운데 하나만 말이 되게 쓴 문항처럼.
(나)는요?

안 돼요. 그 복제본은 시험지를 외웠을 뿐이에요. 그걸 싣는 건 정답지를 성적표에 붙이는 거예요.

(다)는 빼고 싣는 게 맞을 것 같은데… 아니다. 바이그램이 맞히는 문항은 루나도 같은 이유로 맞힐 수 있으니까, 빼고 남은 게 진짜 실력인지 알 수가 없어.

그래서 점수를 고치지 않고 문항을 고쳐요. 상식을 짝으로 다시 만든 것도, 「앞에서 들은 것」을 평균에서 뺀 것도 그래서예요.