주문서를 조립하다: 같은 주문을 300 번 보내면 이야기는 몇 가지가 올까
네 단계로 거른다
측정한 쏠림을 실제로 걸러 내 보려고, filter_simple.py 가 받은 글을 네 단계에 차례로 통과시키게 했다. 첫 단계는 길이로 40 낱말보다 짧거나 220 낱말보다 긴 글을 빼고, 둘째 단계는 낱말 목록으로 목록 밖 낱말이 하나라도 든 글을 뺀다. 셋째 단계에서는 자카드 유사도 0.3 이상으로 이어진 묶음마다 한 편만 남기고, 넷째 단계에서는 글의 시작을 보아 첫 두 낱말이 같은 글을 세 편까지만 남긴다.
| 단계 | plain | mix |
|---|---|---|
| 받은 편 | 1,200 | 1,175 |
| 길이 40~220 낱말 | 1,200 | 1,171 |
| 낱말 목록 안 | 1,194 | 1,130 |
| 자카드 묶음에서 한 편만 | 1,188 | 1,130 |
| 같은 첫 두 낱말은 세 편까지 | 229 | 1,032 |
| 받은 편 가운데 남은 비율 | 19.1% | 87.8% |
위 표는 거르기 단계마다 남은 편 수다(filter_simple.out 의 「거르기」 줄).
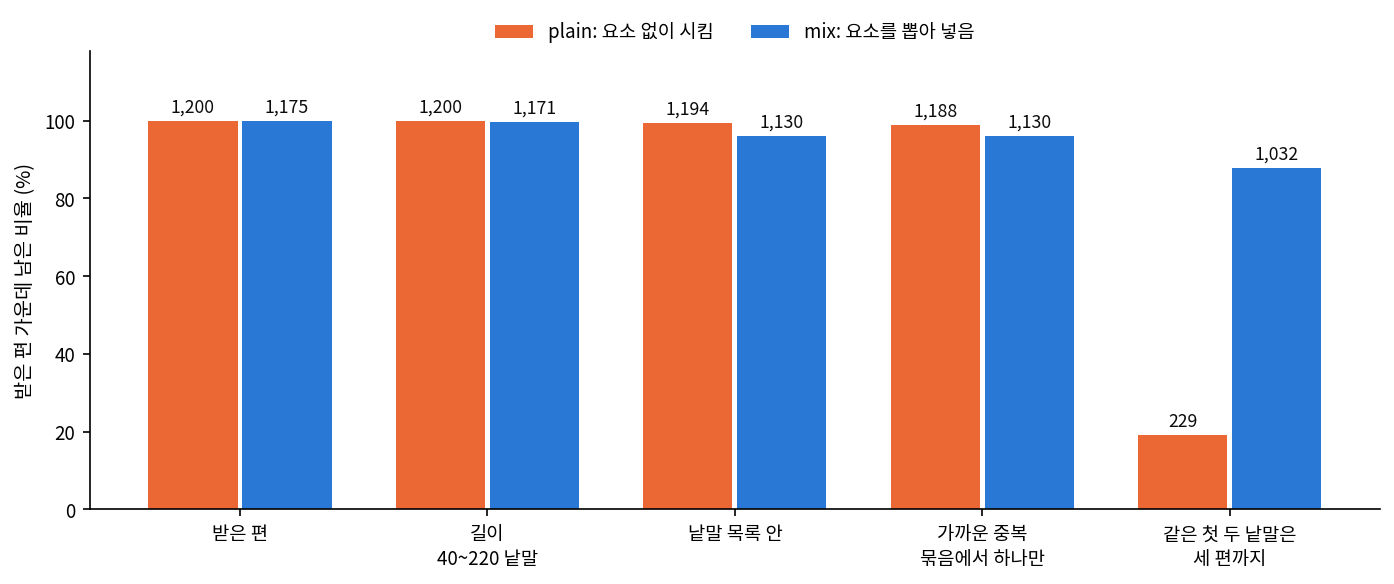
같은 요청 300 번에서 plain 은 229 편, mix 는 1,032 편이 남았다. 딥시크를 부른 횟수와 걸린 시간이 같으므로, 쓸 수 있는 글 한 편을 얻는 비용이 네 배 넘게 차이 난 것이다. mix 에서 가장 많이 빠진 단계는 낱말 목록(41 편)과 글의 시작(98 편)이다.

plain 의 229 편은 이제 괜찮은 걸까? 첫 두 낱말은 고르게 됐지만, 그건 글의 시작만 본 거잖아.
서연은 거른 뒤의 글에 뜻 중복 측정을 다시 돌렸다.
| 거른 뒤 | plain 229 편 | mix 1,032 편 |
|---|---|---|
| 가장 가까운 편과의 코사인 유사도, 평균 | 0.820 | 0.720 |
| 가장 가까운 편과의 유사도가 0.85 이상인 편 | 31.4% | 0.2% |
| 앞에서부터 읽으며 0.85 이상이면 버릴 때 남는 편 | 191 편 | 1,031 편 |
위 표는 거른 글을 다시 측정한 값이다(semdup_simple.out 의 「거른 뒤」 절).

plain 은 걸러서 5분의 1 로 줄였는데도 셋에 하나는 아직 0.85 이상으로 닮은 글이 있네.
문제 2 의 릴리와 새 이야기 두 편이 바로 거른 뒤에 남은 글이에요. 첫 두 낱말이 「Lily was」와 「Lily found」로 달라서 넷째 단계를 통과했어요.

낱말로 하는 거르기는 낱말로 드러나는 쏠림만 줄여요. 뜻의 쏠림까지 걸러 내려면 문장 임베딩을 거르기 단계에 넣어야 하고, 그러면 plain 은 191 편까지 줄어요. 처음 받은 1,200 편의 16% 예요. 반대로 mix 는 뜻 중복 단계를 더해도 한 편만 빠져요. 거르기로 고칠 수 있는 양에는 한계가 있고, 그 한계는 주문서를 쓸 때 이미 정해져요.
이 절에서 좋아진 것은 거르기 절차와 그 절차의 효과에 대한 이해다. 네 단계를 거친 뒤 mix 는 87.8%, plain 은 19.1% 가 남았고, 낱말로만 거른 plain 에는 뜻이 닮은 글이 31.4% 남는다는 것을 확인했다.