주문서를 조립하다: 같은 주문을 300 번 보내면 이야기는 몇 가지가 올까
낱말은 달라도 내용이 같은 글
plain 의 1,200 편에 글자까지 같은 글이 없었다면, 1,200 편은 서로 다른 이야기 1,200 가지일까? 이 물음에 답하려고 쏠림을 측정하는 방법 네 가지를 계산이 가벼운 것부터 차례로 적용해 보았다.
첫 번째는 글의 시작이다. 문제 1 의 표에서 본 대로 plain 은 「mia had a」로 시작하는 글이 191 편, 「tom had a」가 121 편, 「ben had a」가 97 편, 「lily had a」가 86 편이다. 네 가지 시작이 전체의 41% 를 차지한다.
두 번째는 흔한 낱말 조각이다. 글을 네 낱말짜리 조각으로 자르고, 가장 흔한 조각 100 개가 전체 조각에서 차지하는 비율을 구한다. plain 은 6.5%, mix 는 1.0% 였다. plain 에서 가장 흔한 조각은 「the sun was warm」으로 201 번 나왔고, 「it was a good」이 143 번, 「was a good day」가 142 번이다. 끝 문장만 따로 모으면 「It was a …」로 시작하는 끝 문장이 plain 에 173 편 있다.
세 번째는 거의 같은 중복이다. 루나 말투 대화의 중복을 지울 때 쓴 것과 같은 방법으로, 글을 낱말 다섯 개짜리 조각의 집합으로 바꾸고 두 글의 자카드 유사도를 구한다. 문턱은 그때의 0.7 보다 훨씬 낮은 0.3 으로 잡았다. 그래도 plain 1,200 편에서 걸린 것은 일곱 쌍, 아홉 편뿐이고 mix 에서는 한 쌍도 없었다.
자카드 0.39 (ssp00009-0 / ssp00215-0)
  'Mia had a little dog. The dog was Max. Max had a red ball. Mia and Max went to the park. Max ran with the ball. The ball went into a bush. Max looked '
  'Mia had a little dog. The dog was Max. Max had a red ball. Mia and Max went to the park. Max ran after the ball. The ball went into a bush. Max looked'
위는 자카드 유사도가 가장 높은 쌍의 앞부분이다(filter_simple.out). 서로 다른 요청에서 온 두 글이 앞의 다섯 문장에서 낱말 하나만 다르다.

일곱 쌍이면 깨끗한 거 아니야? 1,200 편에서 아홉 편이면 1% 도 안 되는데.

근데 보기를 읽어 보면 이상해. 거르기 뒤의 보기 둘도 「Mia had a little cat … red ball」, 「Tom had a little dog … park」야. 낱말은 다르게 썼는데 같은 이야기를 읽는 느낌이야.
다섯 낱말이 연달아 같아야 조각 하나가 겹치잖아요. cat 을 dog 으로, black 을 brown 으로 바꾸기만 해도 그 낱말이 든 조각 다섯 개가 전부 달라져요. 자카드는 말을 조금만 바꿔도 다른 글로 봐요.
네 번째 방법은 낱말 대신 뜻을 비교하는데, 여기에는 글 한 편을 읽고 수 384 개의 벡터 하나로 바꿔 주는 모델을 쓴다. 루나처럼 다음 토큰을 만들어 내는 모델과 달리 글을 벡터로 요약하기만 하므로 인코더(encoder)라고 부르고, 이렇게 얻은 벡터를 문장 임베딩(sentence embedding)이라고 부른다. 뜻이 비슷한 글이 가까운 벡터가 되도록 학습된 모델이어서, 두 글의 벡터가 가리키는 방향이 얼마나 같은지를 코사인 유사도로 구하면 낱말이 달라도 내용이 비슷한 글을 찾을 수 있다. 여기서는 공개된 작은 인코더 all-MiniLM-L6-v2 를 썼다.
문제 2. 두 글은 얼마나 같은가
아래는 plain 조건에서 서로 다른 요청이 돌려준 두 이야기의 앞부분이다.
A: Lily was in the garden. She saw a little bird. The bird was on the grass. It did not fly. Lily looked at the bird. The bird had a hurt wing. …
B: Lily found a small bird in the garden. The bird was on the grass. It was not able to fly. Lily was sad. She wanted to help. She picked up the bird. …
(가) 위에 보이는 부분에서 두 글에 함께 나오는 낱말 다섯 개짜리 조각을 찾아보자. 몇 개인가?
(나) 두 이야기 전체의 자카드 유사도와 문장 임베딩의 코사인 유사도는 각각 어느 정도일까?
(다) 자카드 유사도 0.3 을 문턱으로 쓰는 검사는 이 쌍을 중복으로 잡는가?
(가) 는 「the bird was on the」, 「bird was on the grass」. 둘이야. 그 앞은 「she saw a little bird」와 「lily found a small bird」처럼 낱말이 달라서 안 겹쳐.
하나 더 있어. 조각은 문장 끝에서 안 끊기잖아. 두 글 다 grass 다음 문장이 It 으로 시작하니까 「was on the grass it」도 겹쳐. 셋이야.
(나) 는, 조각이 글마다 여든 개쯤 될 텐데 겹치는 게 몇 개뿐이면 자카드는 0.05 도 안 되겠어요. 뜻은 거의 같으니까 코사인은 0.9 쯤?

측정한 값은 자카드 0.04, 코사인 0.935 예요(sources/simplestories/semdup_simple.out). (다) 는요?
0.04 니까 안 잡히죠. 0.3 은커녕 0.1 로 낮춰도 안 잡혀요. 근데 읽어 보면 같은 이야기잖아요. 릴리가 마당에서 날지 못하는 새를 발견하는 이야기.
그럼 낱말 조각 검사는 베껴 쓴 글을 찾는 도구고, 같은 줄거리를 다른 말로 쓴 글은 못 찾는 거네. 찾는 대상이 달라.
그래서 두 검사를 다 돌려요. 전체 숫자를 봅시다.
편마다 나머지 모든 편과의 코사인 유사도를 구하고, 그 가운데 가장 높은 값을 그 편의 「가장 가까운 편과의 유사도」로 적었다.
| 측정 | plain | mix |
|---|---|---|
| 자카드 0.3 이상인 쌍 | 7 | 0 |
| 가장 가까운 편과의 코사인 유사도, 평균 | 0.889 | 0.726 |
| 가장 가까운 편과의 유사도가 0.85 이상인 편 | 78.5% | 0.2% |
| 코사인 유사도 0.85 이상인 쌍 | 9,839 | 1 |
| 그 쌍들의 자카드 유사도, 평균 | 0.032 | 0.008 |
| 0.85 이상인 쌍을 이어 만든 묶음에서 하나씩만 남기면 지워지는 편 | 904 편 (75.3%) | 1 편 (0.1%) |
| 가장 큰 묶음 | 770 편 | 2 편 |
위 표는 두 조건의 뜻 중복을 측정한 값이다(semdup_simple.out, 자카드 쌍은 filter_simple.out).
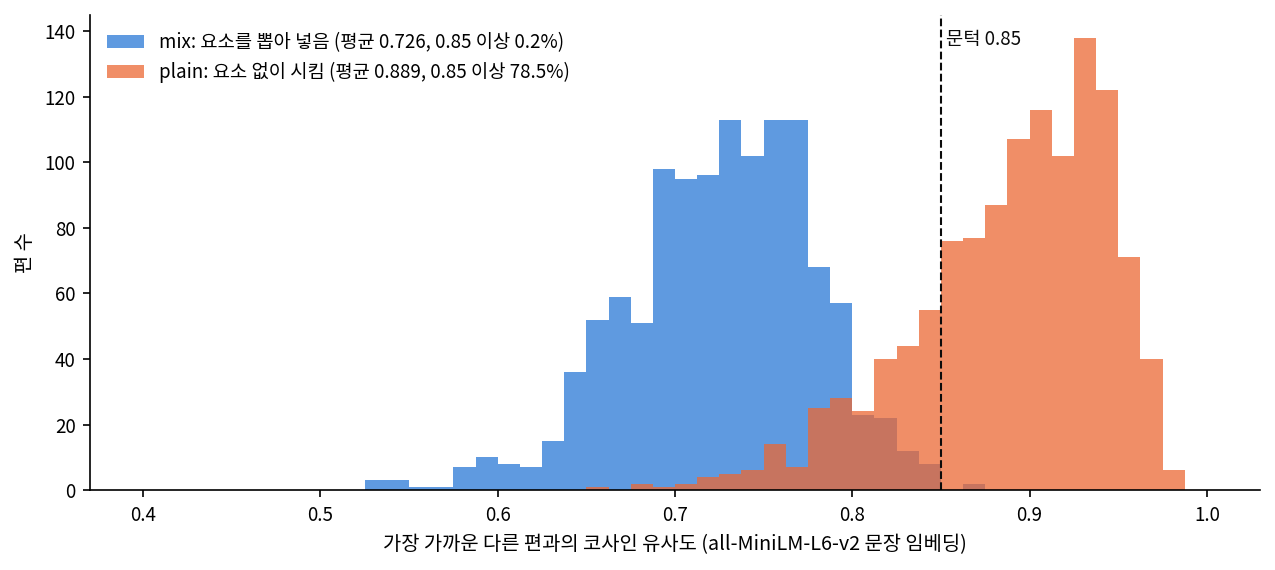
plain 에서 코사인 유사도가 0.85 이상인 쌍은 9,839 개인데, 이 쌍들의 자카드 유사도는 평균 0.032 이고 0.3 을 넘는 것은 앞에서 본 일곱 쌍이 전부다. 자카드 검사는 뜻이 같은 쌍 9,839 개 가운데 7 개를 잡은 것이다. 유사도 0.85 이상인 쌍을 서로 이어 묶음을 만들면 1,200 편 가운데 770 편이 한 묶음에 들어간다. 그 묶음이 어떤 이야기인지는 낱말을 세어 보면 드러난다. plain 의 26.2% 가 고양이나 개가 나오고 공도 나오는 이야기이고, red 가 든 편은 51.5% 다(sources/simplestories/detail_simple.out). mix 에서 같은 비율은 1.4% 와 24.9% 다.
770 편이 전부 서로 0.85 이상인 건 아니죠? A 와 B 가 가깝고 B 와 C 가 가까우면 A 와 C 는 멀어도 한 묶음이 되니까요.
맞아, 이어 붙여서 그래. 그래서 다른 방법으로도 세 봤어. 앞에서부터 한 편씩 읽으면서 이미 남긴 편 가운데 0.85 이상인 게 있으면 버리는 거야. 그렇게 하면 plain 은 507 편이 남고 mix 는 1,174 편이 남아(semdup_simple.out).
어느 방법으로 세도 plain 은 절반 넘게 같은 이야기라는 거네. 딥시크한테 「아이들 이야기 네 편」이라고만 하면 고양이, 개, 빨간 공, 공원이 나오는 거야.
모델이 주문서 하나를 받고 쓰는 글의 분포가 그만큼 좁다는 뜻이에요. 같은 주문서를 300 번 보내는 것은 그 좁은 분포에서 300 번 샘플링하는 것이고, 샘플마다 낱말은 달라져도 고양이와 개와 공이 나오는 이야기가 가장 많다는 점은 바뀌지 않아요. 주문서에 요소를 넣는 것은 요청마다 조건을 바꿔 서로 다른 분포에서 샘플링하는 거고요. 그리고 plain 과 mix 의 이런 차이는 뜻을 비교하는 도구로 봐야 드러났어요. 낱말 조각의 자카드만 봤다면 plain 은 중복이 1% 도 안 되는 깨끗한 데이터로 보였을 거예요.
이 절에서 좋아진 것은 쏠림을 보는 도구다. 낱말 조각의 자카드로는 7 쌍만 보이던 plain 의 중복이 문장 임베딩의 코사인 유사도로는 9,839 쌍으로 드러났고, 요소를 넣은 mix 는 같은 측정에서 1 쌍이었다.