루나의 동네: 따로 읽은 사실을 이어서 답할 수 있을까
아직 막힌 칸과 모델 크기
대조 쌍 판까지 오면서 「어디 있나」, 길의 첫 곳, 가족이 보이나, 들었거나 본 가족의 위치가 열렸다. 열리지 않은 칸은 넷이다.
| 막힌 칸 | 대조 쌍 판, 이야기 / 대화 | 알게 된 것 |
|---|---|---|
| 볼 수 있나, 대화 형식 | 0.74 / 0.67 | 대화 형식은 no 문항의 94% 를 맞히고 yes 문항은 40% 만 맞힌다. 애매하면 No 를 고른다 |
| 동네에 없는 물건 | 0.33 / 0.38 | 가족의 위치와 달리 대조 쌍을 넣어도 열리지 않았다 |
| 홉 카운트 | 0.21 / 0.24 | 무작위 수준 0.1 을 조금 넘는다 |
| 길의 첫 곳, 두 홉 | 0.62 / 0.64 | 먼 목적지(네다섯 홉 0.90 / 0.86)보다 가까운 목적지가 낮다 |
위 표는 대조 쌍 판에서 막힌 칸이다(world_bench.out 의 M15dqtfepR, world_chapter.out 3·4절, 시드 셋의 평균). 학습에 쓰지 않은 퀴즈 형식에서는 모르는 장면에 한 번도 모른다고 하지 않았다.

논리 때 변별력 평균이 제일 높았던 건 87M 이었잖아. 87M 으로 키우면 이것도 열리지 않을까?

그때도 평균이 높았을 뿐이야. 시드 범위가 26M 기준 판과 겹쳐서 변별력을 올렸다고 판정한 조건은 없었어. 그래도 측정은 해 보자.
마지막 데이터 믹스를 26M 과 87M(12층, 폭 768)에 똑같이 넣어 시드 셋씩 학습했다. 마지막 데이터 믹스는 대조 쌍 판의 글에 딥시크 동네 대화 2,755 편 전부와, 이 장에서 다루지 않는 마음과 행동의 글을 더한 것이다. 글이 늘어난 26M 판은 대조 쌍 판보다 「볼 수 있나」와 가족이 보이나가 조금 낮은데, 원인을 따로 대조하지 않았으므로 아래의 비교는 크기만 다른 두 판 사이에서만 읽는다.
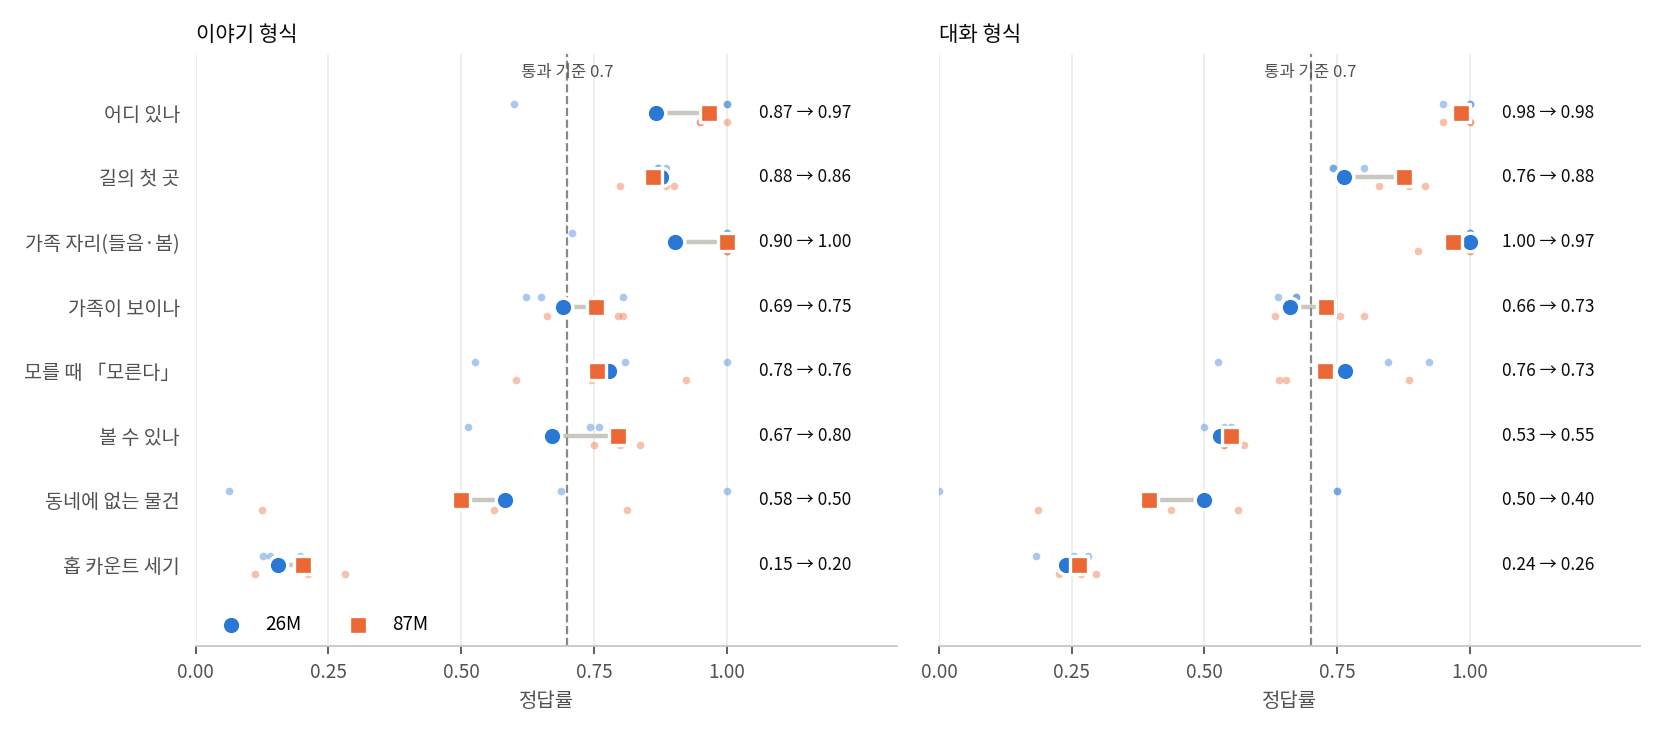
| 칸 | 26M, 이야기 / 대화 | 87M, 이야기 / 대화 | 87M 에서 |
|---|---|---|---|
| 가족이 보이나 | 0.69 / 0.66 | 0.75 / 0.73 | 평균이 두 형식 모두 0.7 을 넘음. 형식마다 시드 하나는 0.7 아래 |
| 볼 수 있나 | 0.67 / 0.53 | 0.80 / 0.55 | 대화 형식 막힘 |
| 동네에 없는 물건 | 0.58 / 0.50 | 0.50 / 0.40 | 막힘. 시드별 0.81·0.56·0.12 / 0.56·0.44·0.19 |
| 홉 카운트 | 0.15 / 0.24 | 0.20 / 0.26 | 막힘 |
| 길의 첫 곳, 두 홉 | 0.72 / 0.59 | 0.67 / 0.69 | 막힘 |
| 논리 시험(떼어 둔 이야기) | 0.74 | 0.84 | 87M 기준 판 0.83 과 같은 수준 |
| 논리 시험의 변별력 d′ | 1.71 | 2.50 | 87M 기준 판 2.51 과 같은 수준 |
위 표는 마지막 데이터 믹스의 26M 판과 87M 판이다(world_bench.out 의 M15dm3frR·M15dm3frR+big, 두 홉은 world_chapter.out 4절, 논리는 7절과 world_logic.out, 시드 셋의 평균). 87M 판은 RTX 4090 한 장에서 시드 하나의 학습에 약 43 분이 걸린다(run_m5fr.log).
크기가 바꾼 것은 이미 열린 칸의 수위와 논리 시험이다. 이 장의 26M 판 다섯은 논리 시험이 74~76%, 변별력이 1.7~1.9 로 기준 판(79%, 2.21)보다 평균이 낮았다. 시드별 값이 기준 판의 범위와 겹치는 판이 많아 판마다 내려갔다고 판정할 수는 없고, 평균이 내려가지 않은 판도 있다(가족 장면과 마음 장면만 더한 판 80%, 2.15, sources/logic-limits/logic_stop.out). 87M 에서는 마지막 데이터 믹스를 모두 넣고도 87M 기준 판과 평균이 같다. 크기가 바꾸지 못한 것은 막힌 칸이어서, 87M 판도 대화 형식의 yes 문항을 10% 만 맞혔다.
세 배 넘게 키웠는데 대화로 물으면 여전히 안 보인대. 처음에 내가 물어봤을 때랑 똑같이 No 만 해.

논리 때 본 것과 같은 모양이에요. 크기는 이미 열린 칸의 수위를 올리고 논리 시험의 평균도 지켰지만, 데이터가 열지 못한 칸을 대신 열어 주지는 않았어요.
이 절에서 좋아진 것은 한계의 위치다. 막힌 네 칸은 87M 시드 셋에서도 열리지 않았으므로, 원인을 크기가 아니라 글에서 찾는다.