유치원 숫자 공부: 계산을 따로 가르치면 루나는 무엇을 배울까
순서와 망각: 앞 단계를 배치에서 빼면
지도 파인튜닝을 거친 루나는 동화 실력을 잃었고, 강화학습과 나란히 놓고 보니 그 대부분은 학습률 때문이었다. 그런데 무엇을 잊느냐에는 학습률 말고도, 가르칠 것을 차례로 줄 때 지나간 단계의 글을 배치에 남겨 두느냐가 걸려 있다. 서연은 숫자 규칙의 표를 공책에 옮겨 적다가 손을 멈췄다.

우리는 세 자리 덧셈을 언제 배웠더라. 유치원에서 손가락으로 열까지 세고, 한 자리 덧셈을 하고, 받아올림은 그보다 한참 뒤였잖아.

그런데 루나한테는 첫 스텝부터 세 자리 덧셈을 줬네. 3 + 4 도 모르는 애한테.

사람한테 쓰는 순서가 루나한테도 통할까? 읽는 양이 같아도 쉬운 계산부터 보여 주면 더 잘하게 될지 궁금해.

쉬운 것부터는 논문마다 갈려요. 우리도 같은 1,000 스텝에서 세 범위를 처음부터 섞은 판과, 쉬운 것부터 하나씩 더해 간 판을 시드 다섯으로 돌려 봤어요. 작은 수 새 쌍이 섞은 판 46.5%, 쉬운 것부터 24.3% 였어요(sources/counting/curric_summary.out). 이 크기에서는 섞기를 못 이겼으니 오늘은 섞어 갑니다. 대신 순서를 정할 때 꼭 알아 둘 일을 하나 볼게요. 할머니 이야기만 읽힌 루나가 엄마 이름을 잊었던 일이 덧셈 안에서도 일어나는지요.
역사: 작게 시작해야 배운다는 주장과 그 반론
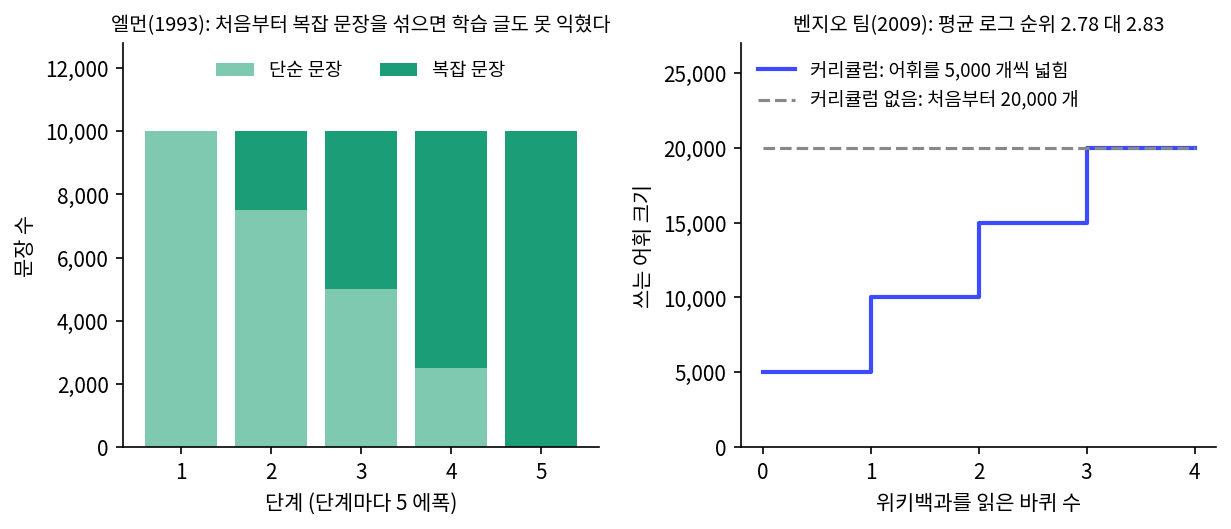
쉬운 것부터 보여 주면 나은가를 먼저 물은 사람은 언어 습득을 연구하던 인지과학자였다. 1993년 제프리 엘먼(Jeffrey L. Elman)은 관계절이 겹겹이 든 문장을 단순 순환 신경망에 처음부터 섞어 주면 학습 글조차 익히지 못하는데, 단순한 문장에서 복잡한 문장으로 다섯 단계에 걸쳐 옮겨 가면 익힌다고 보고했다. 더글러스 로드(Douglas Rohde)와 데이비드 플라우트(David Plaut)는 비슷한 신경망에 더 정교한 언어를 가르쳐 다시 시험하고, 처음부터 복잡한 글을 읽어도 잘 배우며 복잡한 예를 늦게 들이는 일은 오히려 자주 방해가 된다고 맺었다.
2009년 요슈아 벤지오(Yoshua Bengio) 팀은 쉬운 예의 비중이 큰 분포에서 시작해 어려운 예의 무게를 차차 늘리고 마지막에는 목표 분포에 닿는 학습 일정에 커리큘럼 학습 (쉬운 예부터 차례로 넓혀 가는 학습 / curriculum learning)이라는 이름을 붙였다. 정의에서 예의 무게는 단계가 지나도 줄지 않으니, 쉬운 예를 버리고 넘어가는 일정은 여기에 들지 않는다. 위키백과로 학습한 언어 모델에서는 어휘를 5,000 개에서 20,000 개로 넓혀 가는 일정이 다음 낱말의 평균 로그 순위를 2.83 에서 2.78 로 낮췄다. 2020년 말 우샤오샤(Xiaoxia Wu) 팀의 「When Do Curricula Work?」는 표준 벤치마크에서 수천 가지 학습 순서를 돌려, 학습 글을 무작위 순서로 늘려 가기만 해도 쉬운 것부터와 비슷하거나 나았다고 보고했다.
앞 단계를 잊는다
할머니 실험에서는 엄마 이름과 할머니 이름이 같은 문장 틀의 같은 자리를 다퉜다. 덧셈은 범위가 달라도 같은 계산이니, 앞 범위를 빼도 남을 수 있지 않을까? 숫자 규칙을 비교할 때 쓴 덧셈 줄의 세 범위(작은 수, 두 자리, 세 자리)로 시험했다. 조건은 그때와 같고, 스텝을 삼등분해 단계마다 한 범위만 읽히며 앞 범위는 배치에서 뺀다. 순서는 쉬운 것부터와 어려운 것부터 둘이고, 앞 범위를 남기고 넓혀 가는 일정을 함께 놓았다(sources/counting/run_curriculum.py).
시드 다섯의 평균으로, 쉬운 것부터 바꿔 간 루나의 작은 수 배운 쌍은 스텝 300 에 79.7% 였다가 두 자리 단계의 스텝 600 에 0.7% 가 되고, 두 자리 새 쌍은 스텝 600 에 39.4% 였다가 세 자리 단계가 끝나면 4.0% 가 된다(sources/counting/curric_summary.out). 시드 0 의 루나가 마지막에 쓴 답이다.
  예 작은 수 배운 쌍: [('1 + 1 =', ' 310.'), ('1 + 2 =', ' 410.'), ('1 + 4 =', ' 600.')]
  예 세 자리 새 쌍: [('474 + 268 =', ' 732.'), ('537 + 336 =', ' 884.'), ('192 + 346 =', ' 538.')]
어려운 것부터 바꿔 간 루나는 반대쪽으로 틀려서, 1 + 1 에 3 을 쓰고 474 + 268 에 20 을 썼다.
1 더하기 1 이 310 이래. 192 + 346 은 맞히면서.

뒤집은 쪽은 474 + 268 이 20 이고. 세 자리 공부를 먼저 끝낸 아이인데.
앞 범위를 넓혀 간 일정에서는 이런 일이 없어서, 쉬운 것부터 넓혀 간 루나의 작은 수 배운 쌍은 두 자리가 들어온 스텝 400 에 72.2% 로 내려갔다가 다시 올라 93.6% 로 끝났다. 정답률이 바닥까지 떨어지면서도 바이트당 비트는 0.4294~0.4297 사이에 머물렀는데, 어느 일정에서나 배치의 24 줄은 동화였기 때문이다. 배치에 남아 있는 글은 잊지 않았고 배치에서 빠진 글은 잊었다.
문제 5. 왜 덧셈은 잊고 동화는 잊지 않았나
쉬운 것부터 바꿔 간 루나는 작은 수 배운 쌍이 79.7% 에서 0.7% 로 떨어졌는데, 같은 학습에서 바이트당 비트는 0.4297 이다. (가) 두 숫자의 차이를 어떻게 설명할 수 있는가? (나) 두 자리 덧셈도 같은 덧셈인데 왜 작은 수를 잊을까? (다) 루나에게 산수, 이야기, 대화를 차례로 가르치려면 학습 일정에 무엇이 들어가야 하는가?

(가)는 배치야. 스텝마다 24 줄이 동화니까 동화에는 계속 손실이 걸려 있어. 작은 수 줄은 다음 단계부터 한 줄도 없고.

(나)는 이상해. 같은 덧셈이잖아. 두 자리에서 일의 자리끼리 더하는 걸 배우면 작은 수도 할 수 있어야지.
그런데 답을 봐. 1 + 1 이 310 이야. 세 자리 단계에서는 답이 늘 세 자리나 네 자리니까, 앞이 뭐든 긴 수를 쓰는 것부터 배운 것 같아.
아, 그럼 틀린 계산을 배운 게 아니라 답의 길이를 학습 글에 맞게 바꾼 거네. …근데 이것도 안을 안 봤네.
네, 측정해 보려면 답의 자릿수만 따로 채점해야겠죠. (가)로 돌아가 볼까요? 동화를 잊지 않은 이유를 (다)의 일정에도 쓸 수 있나요?
동화처럼 남겨 둬야 해요. 다음 단계로 넘어가도 앞 단계 글을 배치에 일부 두는 거요. 할머니 이야기를 가르칠 때 킨더테일즈 이야기를 함께 읽힌 것처럼요. 어느 글을 얼마나 둘지는 정해야 하고요.

그래요. 어느 글을 어떤 비율로 섞을지 정한 표를 데이터 믹스라고 불러요. 루나를 키우는 동안 그 표를 여러 번 고치게 될 거예요.