유치원 숫자 공부: 계산을 따로 가르치면 루나는 무엇을 배울까
정말 다 잊었을까: 탐침으로 망각 측정하기
다시 읽기 없이 계산을 배운 우리 루나는 「Who is Luna’s Daddy?」에 수를 셌고, 킨더 사실을 바로 물으면 시드 셋 모두 0% 였다. 그런데 이 0% 는 루나가 대답으로 내놓은 글만 채점한 값이다. 사실이 루나 안에서 지워졌는지, 안에는 남아 있는데 묻는 말에 답으로 꺼내는 길만 막혔는지는 이 숫자로 가를 수 없다. 앞으로 루나에게 도구와 생각하는 법을 차례로 더 가르칠 텐데, 잊는 일이 어느 쪽이냐에 따라 막는 법이 달라진다.

0% 라는데 난 안 믿겨. 킨더테일즈를 몇 번을 읽혔는데. 머리 어딘가엔 있을 거야.

있는지 없는지 어떻게 알아? 물어보면 수를 세는데.

층마다 무슨 일이 일어나는지 볼 때 쓴 도구가 있죠. 모델은 얼려 두고 층의 벡터 위에 작은 분류기를 얹어, 그 벡터에서 읽히는지 보는 거요. 말로는 못 해도 탐침으로 읽히면 「남아 있는데 못 꺼낸다」, 탐침으로도 안 읽히면 「지워졌다」에 가까워요.
시험지부터 시험하기
탐침은 모델 안의 벡터에 얹어 정보가 있는지 확인하는 작은 분류기다. 탐침의 시험지도 다섯 살 시험지처럼 아무것도 모르는 모델로 먼저 풀어 보았다. 정답 하나와 오답 일곱을 보기로 준 첫 시험지는 가족 사실을 배우기 전인 동화 단계 루나에서도 탐침이 60~89% 를 냈다(sources/forgetting/probe/probe_v0_8opts.out). 정답인 turtle, noodles, gray 가 동화에 드문 낱말이라, 탐침이 「드문 낱말이면 참」을 배운 것으로 보인다.
그래서 값은 그대로 두고 주어만 바꾼 짝으로 시험지를 다시 만들었다. 「Every day Luna’s Daddy feeds a pet turtle.」과 「Every day Luna’s Mommy feeds a pet turtle.」은 토큰 수가 같고 같은 turtle 로 끝나며, 킨더테일즈에서 turtle 은 Daddy 의 애완동물이라 앞 문장만 참이다. 값의 흔함은 짝의 두 문장에 똑같이 들어가니 지름길이 사라진다. 이름·애완동물·음식·취미·좋아하는 색·대학 공부의 여섯 속성에 틀을 너댓 개씩 써서 짝 104 개를 만들고, 그 가운데 학습 글에 글자 그대로 있는 7 짝을 빼 97 짝을 남겼다(sources/forgetting/probe/probe.out). 우연히 고르면 50% 다.
세 겹으로 측정하기
같은 짝으로 세 가지를 측정한다.
- 바로 묻기: 지금까지 쓴 「킨더 열두 사실 바로 묻기(그리디)」다. 루나가 묻는 말에 답으로 사실을 꺼내는가.
- 문장 속 값 고르기: 값 바로 앞까지 짝의 두 문장을 넣고(「Every day Luna’s Daddy feeds a pet」과 「… Mommy feeds a pet」), 루나의 출력이 값의 첫 토큰 「 turtle」에 준 확률이 참 주어 쪽에서 더 큰지 본다. 묻고 답하는 형식 없이, 문장을 이어 쓰는 가장 기본 동작으로 사실을 아는가를 확인한다.
- 중간 층 탐침: 2번과 같은 비교를 루나의 출력 대신 층 1~7 의 벡터에서 한다. 층마다 작은 선형 변환을 하나씩 학습해, 그 층의 벡터를 루나 자신의 마지막 정규화와 출력층으로 읽는다. 로짓 렌즈에 층마다 배운 변환을 붙인 것으로, 튜닝드 렌즈 (층마다 배운 선형 변환을 거쳐 중간 층을 출력처럼 읽는 탐침 / tuned lens)라 부른다. 학습 글은 동화 검증 글뿐이라 가족 사실은 한 줄도 보지 않는다. 체크포인트마다 따로 학습하고, 일곱 층 가운데 가장 높은 층의 값을 적는다.
중간 층 탐침은 가족 사실을 한 번도 보지 않고 「동화를 이어 쓰듯 중간 층을 읽는 법」만 배우는데, 그 읽기로 참 주어를 고른다면, 그 사실이 중간 층에 이미 들어 있다는 뜻이다.
결과: 말로는 다 잊었고, 안에는 일부만 남았다
단계마다 시드 셋을 측정했다(sources/forgetting/probe/summary.out, 단위 %, 시드 1/2/3).
| 단계 | 다시 읽기 | 바로 묻기 | 문장 속 값 고르기 | 중간 층 탐침 |
|---|---|---|---|---|
| 동화(배우기 전) | 0/4/0 | 56/55/60 | 64/66/65 | |
| 묻는 말에 답하기 | 0/0/4 | 54/61/57 | 63/66/65 | |
| 킨더테일즈 | 79/79/71 | 98/100/98 | 85/96/98 | |
| 정체성 대화 | 없음 | 29/38/38 | 93/95/98 | 81/92/100 |
| 정체성 대화 | 1/16 | 58/79/62 | 99/100/97 | 94/97/98 |
| 계산 | 없음 | 0/0/0 | 60/77/73 | 64/81/78 |
| 계산 | 1/16 | 79/79/58 | 99/96/99 | 90/96/100 |
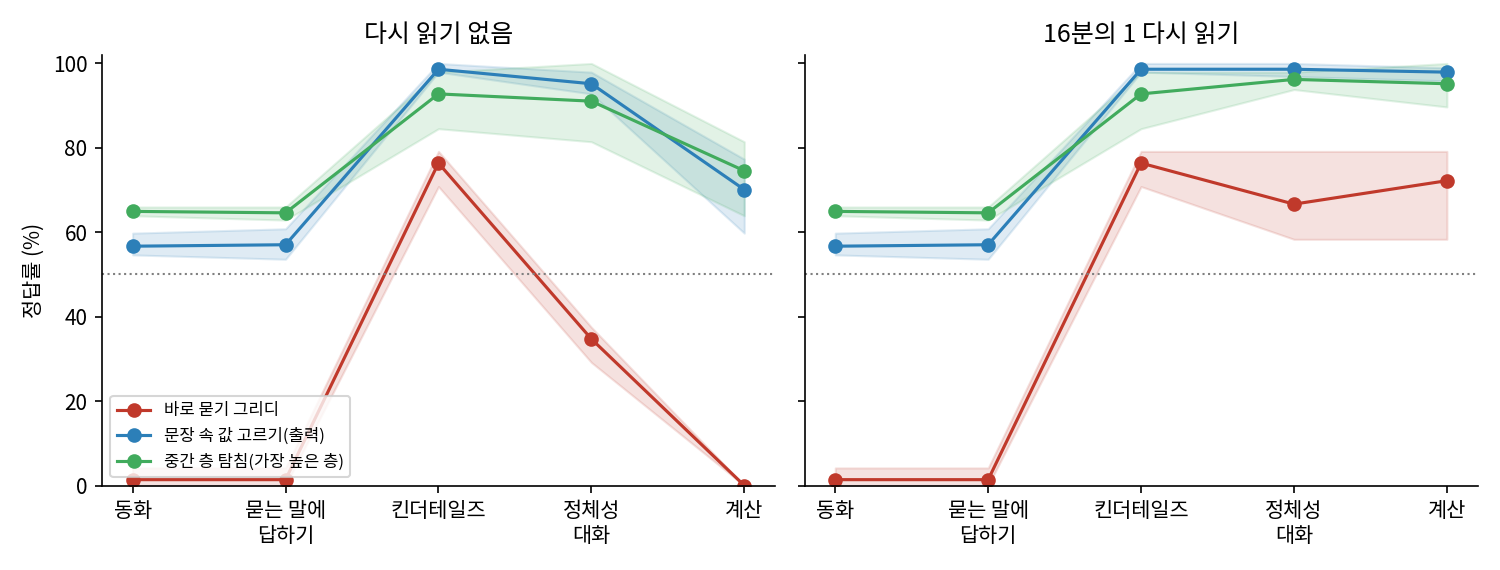
동화 단계 루나도 문장 속 값 고르기가 55~60%, 탐침이 64~66% 로 50% 보다 높다. 동화에 아빠와 엄마가 나오는 문장의 쏠림이 있어서다. 그래서 「얼마나 남았나」는 이 높이를 바닥으로 놓고 센다. 배우기 전(동화 단계)을 0, 킨더테일즈를 배운 직후를 100 으로 놓고, 계산 단계 값이 그 사이 어디인지 본다.
남은 비율 = (COUNT − P0) / (KT − P0), 시드 1·2·3 마다 「다시 읽기 없음/1/16」 %. ask = 바로 묻기 그리디, out = 문장 속 값 첫 토큰 짝(루나 출력), mid = 중간 층 탐침 가장 높은 층
ask 0/100 -6/100 0/82
out 10/102 50/91 35/103
mid 0/125 52/100 41/106
(sources/forgetting/probe/retention.out. 칸마다 앞이 다시 읽기 없는 줄, 뒤가 1/16 줄이다.)
다시 읽기 없는 루나는 바로 묻기로는 남은 것이 0 이다. 그런데 문장을 이어 쓰게 하면 10%, 50%, 35% 가 남아, 평균 3분의 1 쯤이다. 중간 층 탐침은 0%, 52%, 41% 로 출력과 거의 같다.
봐, 있잖아! 3분의 1 은 남았어.

그런데 탐침이 출력보다 별로 더 찾지 못했어. 계산 단계에서 탐침이 출력보다 4~5 점 높은데, 동화 단계에서도 탐침이 5~11 점 높았잖아.
그 차이는 무엇 때문일까요?

탐침은 일곱 층 가운데 가장 높은 걸 골랐으니까 원래 조금 높게 나와요. 그만큼을 빼면 출력에 안 나오고 안쪽에만 숨은 사실은 거의 없어요. 남은 건 시드마다 10%, 50%, 35% 이고 그건 출력에서도 보여요. 평균으로는 3분의 2 쯤을 정말 잊은 거예요. 다만 묻는 말에 답할 때는 남은 것도 안 나오고요.

그래서 잊는 일이 두 겹이에요. 사실 자체가 평균 3분의 2 쯤 지워졌고, 남은 사실도 「묻고 답하는 길」로는 나오지 않아요. 남은 비율이 시드마다 10%, 50%, 35% 로 넓다는 것도 같이 적어 둬요. 우리가 지금까지 본 0% 는 두 겹을 함께 측정한 숫자였어요.
16분의 1 을 옛 글로 채운 줄은 세 잣대 모두 82~125% 다. 1/16 다시 읽기는 사실 자체만이 아니라 묻는 말에 답하는 길까지 지켰다.
두 겹이 따로 움직인다는 것은 다른 실험에서도 보였다. 사실을 지킨 1/16 루나에게 킨더테일즈 이야기 가운데 애완동물·음식·취미 이야기만 50 스텝 더 읽히자, 읽히지 않은 대학 공부와 좋아하는 색의 바로 묻기가 75/100/75% 에서 25/25/38% 로 떨어졌다. 같은 두 속성의 문장 짝 고르기는 94/97/87% 에서 84/97/94% 로 그대로였다(sources/forgetting/probe/relearn.out). 사실은 그대로인데, 묻는 말에 답하는 길만 이야기 몇 편에 무너졌다.
답하는 길이 사실보다 훨씬 약하구나. 사실은 이야기 문장에 박혀 있고, 묻고 답하는 건 그 위에 따로 얹힌 거니까.
역사: 잊은 것인가, 못 꺼내는 것인가
새 일을 배운 모델이 옛 일을 못 하게 되는 것을 오래 「파국적 망각」이라 불렀다. 2022년 몬트리올의 모하마드레자 다바리(MohammadReza Davari)와 동료들은 이 망각을 정답률이 아니라 표현으로 측정했다. 옛 일을 배운 뒤 새 일을 배운 신경망에서 마지막 분류층을 떼고, 남은 벡터 위에 선형 분류기를 새로 학습해 옛 일을 얼마나 맞히는지 본 것이다(CVPR 2022). 망각을 막는 장치 없이 학습한 신경망도 이렇게 측정하면 표현은 생각보다 적게 잊었고, 넓고 깊은 신경망일수록 덜 잊었다. 정답률이 떨어진 만큼 표현이 잊은 것은 아니었다.
언어 모델에서는 2023년 카네기멜런 대학의 수하스 코타(Suhas Kotha), 제이컵 스프링어(Jacob Springer), 아디티 라그후나탄(Aditi Raghunathan)이 비슷한 물음을 던졌다(ICLR 2024). 그들은 파인튜닝이 능력을 지우기보다, 모델이 「지금 어떤 일을 하라는 건가」를 짐작할 때 파인튜닝한 일로 기울게 만든다고 보았다. 파인튜닝 데이터가 대부분 영어라는 점을 이용해 물음을 다른 언어로 옮겨 묻자, 잃은 것처럼 보이던 능력 일부가 돌아왔다.
2025년 중국 화남이공대학의 정쥔하오(Junhao Zheng)와 동료들은 이를 「가짜 망각(spurious forgetting)」이라 불렀다(ICLR 2025). 언어 모델이 새 일을 배울 때 옛 일의 성능이 급히 떨어지는 것은 대개 지식을 잃어서가 아니라, 새 일을 배우는 첫 스텝들이 옛 일의 「작업 정렬」(물음을 받으면 그 일을 하는 버릇)을 흐트러뜨려서라는 것이다. 그들은 아래층을 얼려 두는 단순한 방법으로 이 망각을 크게 줄였다.
우리가 쓴 층별 탐침은 2023년 노라 벨로즈(Nora Belrose)와 동료들의 튜닝드 렌즈를 따른 것이다. 원래 튜닝드 렌즈는 층마다의 변환을 모델 자신의 마지막 출력에 맞추도록 학습하는데, 우리는 동화 검증 글의 다음 토큰에 맞췄다.
우리 결과는 이 연구들과 한 점에서 같다. 바로 묻기가 0% 로 떨어진 것은 묻고 답하는 길이 끊긴 것이 크고, 사실을 지킨 루나에서도 답하는 길만 따로 무너졌다. 다른 점도 있다. 다시 읽기 없는 우리 루나는 사실 자체도 평균 3분의 2 쯤 잃었고, 탐침도 출력보다 더 찾아내지 못했다. 이 연구들의 모델은 우리보다 훨씬 크고, 옛 일과 새 일의 글이 우리처럼 서로 다르지 않았다. 작은 모델에서 다른 글만 1,900 스텝 읽히면 사실 자체도 지워질 수 있다.
문제 7. 바닥이 50 이 아닌 시험
(가) 동전을 던져 앞뒤를 맞히는 내기에서, 한 친구는 늘 「앞」이라고만 말하는데 60% 를 맞힌다. 이 친구가 동전을 읽는 능력이 있다고 볼 수 있을까? (나) 동화 단계 루나는 가족 사실을 배우기 전인데도 문장 속 값 고르기가 56/55/60% 였다. 시드 2 의 계산 단계 값 77%, 킨더테일즈 단계 값 100% 로 남은 비율을 계산하고, 「77% 니까 77% 를 기억한다」와 비교하라. (다) 중간 층 탐침이 일곱 층 가운데 가장 높은 층의 값을 적는다면, 이 값이 출력보다 높은 것만으로 「안에 숨은 지식이 있다」고 말할 수 있을까?

(가)는 동전이 앞으로 기운 거지. 친구가 읽는 게 아니라.
(나)는 바닥이 55 니까… (77 − 55) ÷ (100 − 55) 면 22 ÷ 45 라서 0.49, 49% 쯤이야. 출력에는 50 으로 나와 있네. 반올림 전 값으로 계산해서겠지.
77% 와 49% 는 무엇이 다르죠?

77 은 배우기 전부터 있던 아빠·엄마 쏠림까지 넣은 거고, 49 는 킨더테일즈로 새로 배운 것 가운데 남은 비율이에요.

(다)는… 탐침이 출력보다 높으니까 숨은 게 있는 거 아냐?
동화 단계에서는 어땠죠? 그때는 숨길 가족 사실이 없었어요.

그때도 탐침이 5~11 점 높았지. 아, 일곱 개 중에 제일 좋은 걸 골라서 원래 높게 나오는구나. 그럼 그만큼보다 더 높아야 숨은 거네.
맞아요. 비교하려면 같은 방식으로 측정한 바닥과 비교해야 해요. 시험지를 먼저 시험하는 것과 같은 이야기예요.