유치원 숫자 공부: 계산을 따로 가르치면 루나는 무엇을 배울까
강화학습: 뽑은 답을 채점해서 고른다
지도 파인튜닝은 답을 알려 주는 학습인데, 산수 공부에는 그보다 싼 방법이 하나 더 있다. 답을 일일이 알려 주지 않아도 맞았는지는 프로그램이 안다.

산수는 채점이 공짜잖아. 루나가 쓴 답을 프로그램이 맞다 틀리다만 알려 주면?
그거 강화학습 수업에서 했어. 그 비평가 없는 거.
딥시크매스(DeepSeekMath, 2024)가 낸 GRPO 는 PPO 에서 비평가를 덜어 낸 것이지만, 우리는 거기서 더 덜어 낸다. nanochat 의 scripts/chat_rl.py 머리 주석이 줄인 네 가지를 그대로 따랐다. 기준 모델과의 KL 항이 없고, 모델이 방금 뽑은 답으로만 배우니 PPO 의 비율과 클립이 없고, 표준편차로 나누지 않아 어드밴티지는 보상에서 평균을 뺀 값이며, 합을 토큰 수로 나눈다. 정답 확인기는 뽑은 글에서 처음 나온 수를 정답과 비교하는 한 줄이다.
# sources/counting/run_ladder.py 의 grpo_step 에서 (발췌, G = 8)
for L, group in by_len.items():                              # 길이가 같은 물음끼리 묶어 G 번씩 뽑는다
    x, _ = sample_group(m, [e for e, _ in group], n_new, r_gen)
    for i, (e, c) in enumerate(group):
        rs, ans = [], []
        for g in range(G):
            a = trim(x[i * G + g, L:].tolist())              # 온점이 든 토큰까지가 답
            rs.append(float(K.first_int(tok.decode(a)) == c))  # 정답 확인기: 맞으면 1, 틀리면 0
            ans.append(a)
        mu = sum(rs) / G
        for a, rw in zip(ans, rs):
            seqs.append(e + a); marks.append(len(e))
            advs.append(rw - mu)                             # 어드밴티지 = 보상 - 그룹 평균
...
logp = -F.cross_entropy(logits.float().transpose(1, 2), yb, ignore_index=-100, reduction="none")
loss = -(logp * adv).sum() / valid                           # KL 없음, 비율·클립 없음, 표준편차 나누기 없음
코드의 mu 가 그 그룹 평균이고, 우리는 표준편차로 나누지 않았다.

지도 파인튜닝처럼 학습률 0.0001 로 돌리면 빠르지 않아요?

nanochat 은 기본값의 5% 에서 시작해요(--init-lr-frac 0.05). 0.0001 로 돌렸을 때는 시작점에 따라 3 만 말하는 루나가 나왔어요. 오늘은 0.00001(1e-5) 로 갑니다.
이후 모든 강화학습은 학습률 1e-5, 300 스텝, 스텝마다 물음 32 개에 답 8 개씩이다. 시드 하나에 RTX 4090 을 나눠 쓰며 4~5 분이 걸렸다.
시작점이 정한다
「둘 다」로 읽힌 루나에서 시작한 강화학습을 같은 루나의 지도 파인튜닝과 나란히 놓는다.
| 식 배운 쌍 | 이야기 배운 쌍 | 바이트당 비트 | |
|---|---|---|---|
| 시작(둘 다) | 81.7% | 6.8% | 0.432 |
| + 지도 파인튜닝 | 99.6% | 62.2% | 0.515~0.529 |
| + 강화학습 | 99.2% | 11.5% | 0.433 |
식에서는 답을 알려 주지 않았는데도 강화학습이 지도 파인튜닝과 같은 값까지 갔고, 동화 실력의 바이트당 비트는 0.432 에서 0.433 으로 거의 변하지 않았다. 샘플을 보면 「Tom had 3 apples. He ate 1 apple. Now Tom has」 다음에 「 3 apples left. Tom was happy.」처럼 동화를 계속 쓴다. 반면 이야기 물음은 6.8% 에서 11.5% 로 조금 오른 데 그쳤다.
답을 한 번도 안 알려 줬는데 99.2% 야. 맞았다, 틀렸다만 듣고.
다만 동화 실력이 남은 것을 강화학습의 덕으로 읽으면 안 된다. 강화학습의 학습률은 1e-5 로, 지도 파인튜닝(1e-4)의 10분의 1 이다. 대화를 배운 본줄기 루나에게 논리 문항을 가르친 다른 실험에서 두 방법의 학습률을 1e-5 로 맞춰 보니, 바이트당 비트가 시작 0.448~0.450 에서 지도 파인튜닝은 0.452~0.453, 강화학습은 0.450~0.451 이 되어 차이가 0.003 안쪽이었다. 지도 파인튜닝을 1e-4 로 돌린 판만 0.494~0.517 로 나빠졌다(sources/logic-rl/summary.out). 같은 학습률이면 차이가 없었고, 동화 실력을 잃은 것은 대부분 학습률 때문이다.

식은 처음부터 뽑으면 맞는 답이 섞여 나오던 거고, 이야기 물음은 여덟 개를 뽑아도 맞는 답이 거의 안 나오는 거야. 없는 답은 칭찬할 수가 없잖아.
시작점을 바꿔 같은 강화학습을 네 번 더 돌렸다(sources/counting/ladder_R_*.out, 정답률은 시드 셋 평균).
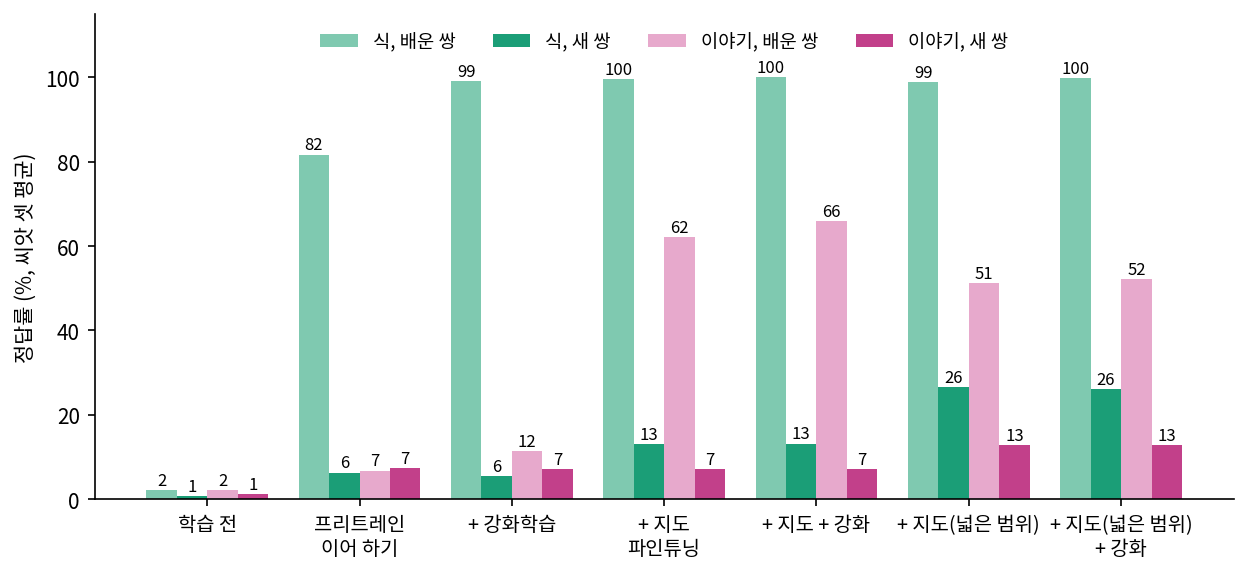
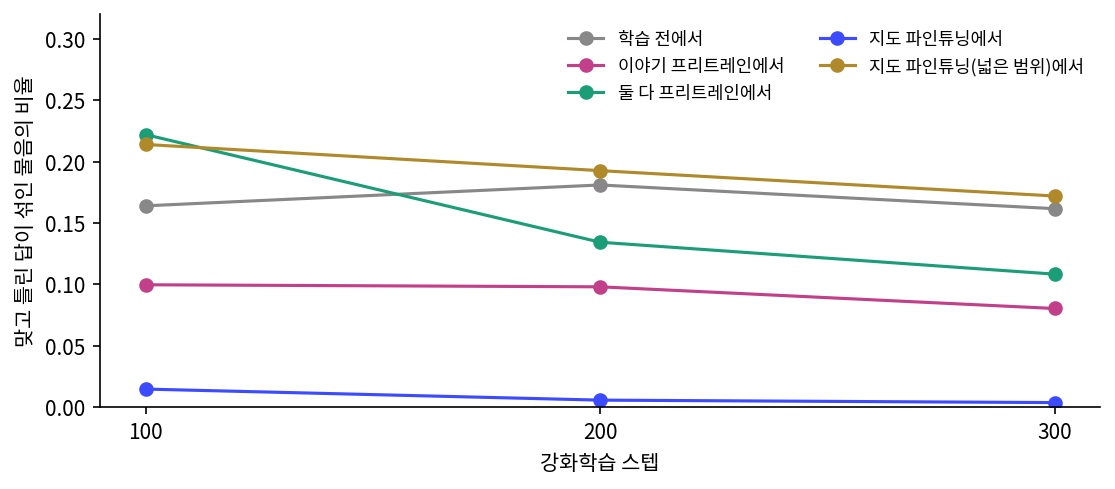
시작점이 강화학습의 결과를 정했다. 학습 전 동화 GPT 에서 바로 시작하면 식 배운 쌍이 14.2% 에 머물고, 「둘 다」로 읽힌 루나에서는 99.2% 까지 간다. 이어 읽기의 효과가 보이는 자리다. 지도 파인튜닝이 끝난 루나는 배운 쌍 문항을 거의 다 맞혀서 맞고 틀린 답이 섞인 물음이 0.3% 뿐이고, 어드밴티지가 거의 언제나 0 이다. 배울 것이 없는 문항을 주면 강화학습은 아무것도 하지 않는다(이야기 62.2% → 65.9%, 식 새 쌍 13.0% → 13.2%). 두 자리 문항을 섞은 시작점(넓은 범위)은 신호가 끝까지 남았지만(마지막 100 스텝의 섞인 물음 0.145~0.196), 새 쌍의 식은 26.5% 에서 26.1% 로 오르지 않았다. 강화학습이 민 것은 문항에 나온 쌍이고, 신호가 있어도 그 신호가 새 쌍으로 번지지는 않았다.
문제 4. 몇 개를 뽑아야 배우나
한 물음에서 답 하나가 맞을 확률이 p 일 때, 답 G 개가 모두 맞거나 모두 틀리면 그 물음은 어드밴티지가 0 이다. (가) G = 8 일 때 p = 0.01, 0.5, 0.99 인 물음이 신호를 줄 확률을 각각 구하라. (나) 둘 다로 읽힌 루나의 이야기 물음(그리디 정답률 6.8%)과 지도 파인튜닝을 마친 루나의 식 물음(99.6%)은 어느 쪽에 가까운가? (다) 신호를 키우려면 G 를 늘리는 것과 문항을 바꾸는 것 가운데 무엇이 나을까?
신호가 있을 확률은 1 빼기 모두 맞을 확률 빼기 모두 틀릴 확률이니까 1 − p⁸ − (1−p)⁸. p = 0.5 면 1 − 2/256 해서 0.992.

p = 0.01 은 1 − 0.01⁸ − 0.99⁸, 0.99⁸ 이 0.923 이니까 0.077. p = 0.99 도 똑같이 0.077 이네.

(나)는요? 그리디 정답률을 p 로 그대로 넣어도 될까요?
안 돼요. 그리디는 1 등 답이 맞는 비율이고, p 는 뽑았을 때 맞을 확률이에요.

그럼 뽑은 답의 평균 보상을 보면 되잖아. 둘 다로 읽힌 루나가 처음 100 스텝에 0.487 이었지.
그건 식과 이야기를 합친 값이야. 나눠서 재지는 않았어.
그래도 지도 파인튜닝 끝난 건 처음 100 스텝의 평균 보상이 0.995 니까 p = 0.99 쪽이야. 같은 때 섞인 물음이 0.014 면 공식의 0.077 보다도 낮고.
그래요. (다)는 어떨까요? G 를 천 개로 늘리면 p = 0.99 인 물음도 신호가 생기죠.
그런데 그때 민 답은 이미 99% 인 답이니까 배울 게 적어요. 지도 파인튜닝을 마친 뒤라면 안 푼 문항으로 바꾸는 게 낫겠어요. 넓은 범위 문항처럼요. 예전 수업에서 적정 난이도라고 했던 거네요.