용량: 외우는 것과 옮기는 것
먼저 이야기 편수를 늘린 판들이 건드린 용량 축을 끝까지 측정한다. 이야기 4,300 편은 70만 토큰으로 프리트레인 글의 0.6% 이고 14,000 스텝 동안 한 번 지나가므로, 4,300 편에서 정체된 이유가 한 번씩만 보여 준 데 있을 수도 있다. 그래서 같은 4,300 편을 여러 번 넣은 판을 학습했다. 반복하면 이야기 토큰이 늘어나므로 논리 글 전체가 차지하는 양을 15% 로 올렸고, 그것만의 효과를 가르려고 한 번씩 넣고 15% 로 올린 판도 함께 두었다.
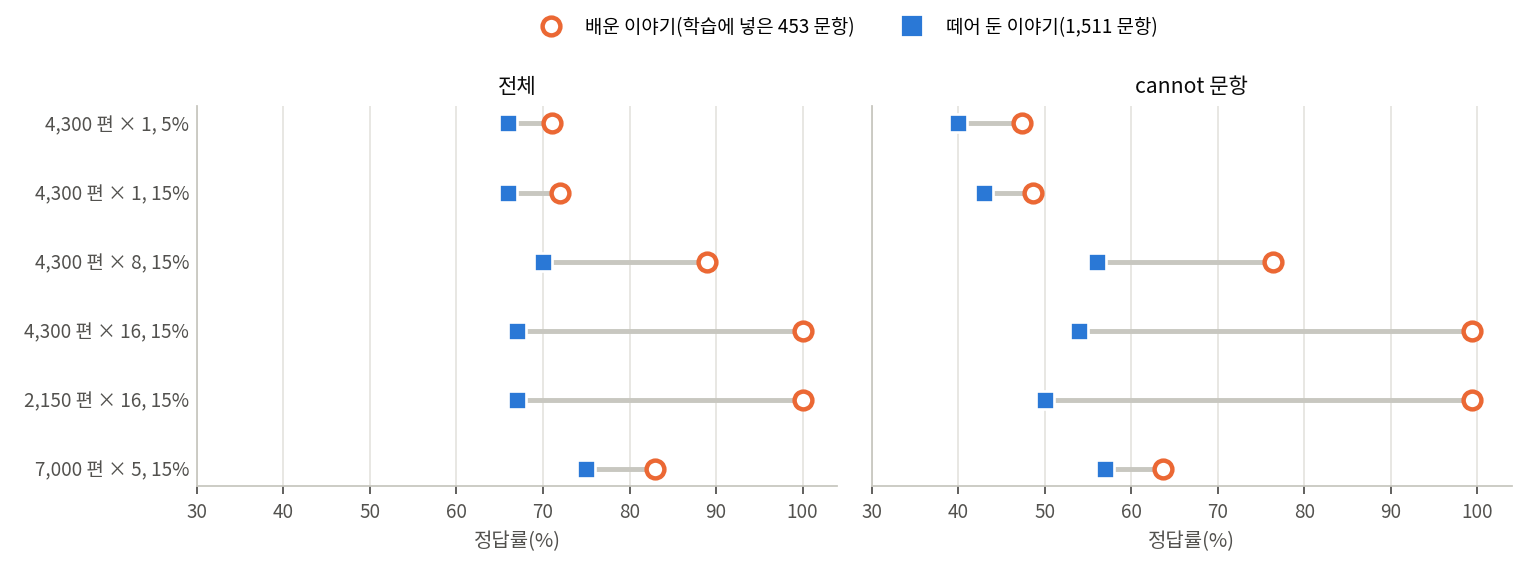
| 판 | 배운 이야기 전체 | 배운 이야기 cannot | 떼어 둔 이야기 전체 | 떼어 둔 이야기 cannot |
|---|---|---|---|---|
| 4,300 편 × 1, 5% | 71 | 47 | 66 | 40 |
| 4,300 편 × 1, 15% | 72 | 49 | 66 | 43 |
| 4,300 편 × 8, 15% | 89 | 76 | 70 | 56 |
| 4,300 편 × 16, 15% | 100 | 99 | 67 | 54 |
| 2,150 편 × 16, 15% | 100 | 99 | 67 | 50 |
| 7,000 편 × 5, 15% | 83 | 64 | 75 | 57 |
위 표는 같은 이야기를 보는 횟수와 서로 다른 이야기의 수를 바꾼 판들이다(sources/logic-limits/form_map.out, 시드 셋의 평균, %). 표의 아래 두 줄은 이야기를 보는 횟수를 약 34,400 번으로 셋째 줄과 같게 두고 편수만 바꾼 판이다.
넣는 양만 15% 로 올린 판은 달라지지 않았고, 여덟 번씩 보여 준 판에서 떼어 둔 이야기의 cannot 이 56% 로 처음 40% 대를 벗어났다. 열여섯 번은 배운 이야기를 모두 외웠지만(99%) 떼어 둔 이야기는 오르지 않았다. 보는 횟수를 고정하고 편수를 2,150 편, 4,300 편, 7,000 편으로 바꾸면 전체는 67%, 70%, 75% 로 오르는데 cannot 은 50%, 56%, 57% 로 느리게 오른다. 편수 비교에는 단서가 하나 있다. 딥시크에게 준 프롬프트는 도중에 한 번 바뀌었는데, 학습 이야기의 앞 1,750 편은 모두 첫 판 프롬프트로 쓴 것이고 시험지는 63% 가 둘째 판 이야기다. 2,150 편 판에는 둘째 판 이야기가 400 편, 7,000 편 판에는 5,250 편 들었으니, 편수가 늘면서 시험지와 같은 말투도 함께 늘었고 편수만의 효과는 표의 숫자보다 작다.
모델 크기도 같은 축에 놓인다. 여덟 번씩 넣은 데이터를 그대로 두고 모델을 7분의 1(4층, 폭 256, 381만 개)로 줄이면 배운 이야기가 70%, 떼어 둔 이야기의 cannot 이 43% 로 내려가 한 번씩 넣은 판의 자리로 돌아간다. 작은 모델은 여덟 번 본 글도 외우지 못한다.

반복은 외울 수 있는 만큼까지만 값이 있어요. 여덟 번까지는 외우면서 cannot 도 같이 오르고, 그 뒤로는 외우기만 해요.
큰 모델의 프리트레인에서도 같은 것을 측정한 연구가 있어요. 2023년에 나온 한 연구는 데이터가 모자라 같은 글을 반복해 읽힐 때, 네 번까지는 새 글을 읽힌 것과 거의 차이가 없고 그보다 많이 반복하면 값이 빠르게 줄었다고 보고했어요. 우리 문항에서는 그 문턱이 여덟 번 근처였어요.
남은 것도 숫자로 적는다. 용량 축만으로는 홉 3·4 의 cannot 이 43%·39% 까지 왔다(4,300 편 × 8). 편수를 두 배로 늘릴 때마다 5%p 안팎씩 오르는 기울기이고 그것도 크게 잡힌 값이라, 이 축만으로 90% 에 닿으려면 편수가 지금의 100 배를 넘어야 한다.