데이터 모양의 지도
문형 한 가지에서 이만큼 움직였으니, 다른 능력에도 같은 방법이 통하는지 확인할 차례다. 서연은 이야기 4,300 편을 여덟 번씩 넣고 논리 글을 15% 넣은 판을 기준으로 정하고, 이야기는 그대로 둔 채 프로그램 문항의 모양만 한 가지씩 바꿨다. 딥시크에게 새로 쓰게 할 것이 없으니 판 하나가 시드 셋에 한 시간이면 끝난다.
| 능력 | 바꾼 데이터의 모양 | 기준 | 바꾼 판 |
|---|---|---|---|
| 문형 | 규칙 글틀의 가짓수 | 6 벌 | 8 벌 / 12 벌 + 사실·물음 글틀 |
| 너비 | 한 홉에 반대쪽 규칙이 붙을 확률 | 0.35 | 0 / 0.7 |
| 깊이 | 학습 문항의 홉 수 | 1~4 | 1~6 |
| 멈춤 | 학습 문항에서 cannot 의 비율 | 1/3 | 1/2 |
위 표는 데이터 모양 지도의 판들이고, 이야기·모델·스텝·시험은 모두 기준 판과 같다(sources/logic-limits/luna_surface.py 의 FORM).
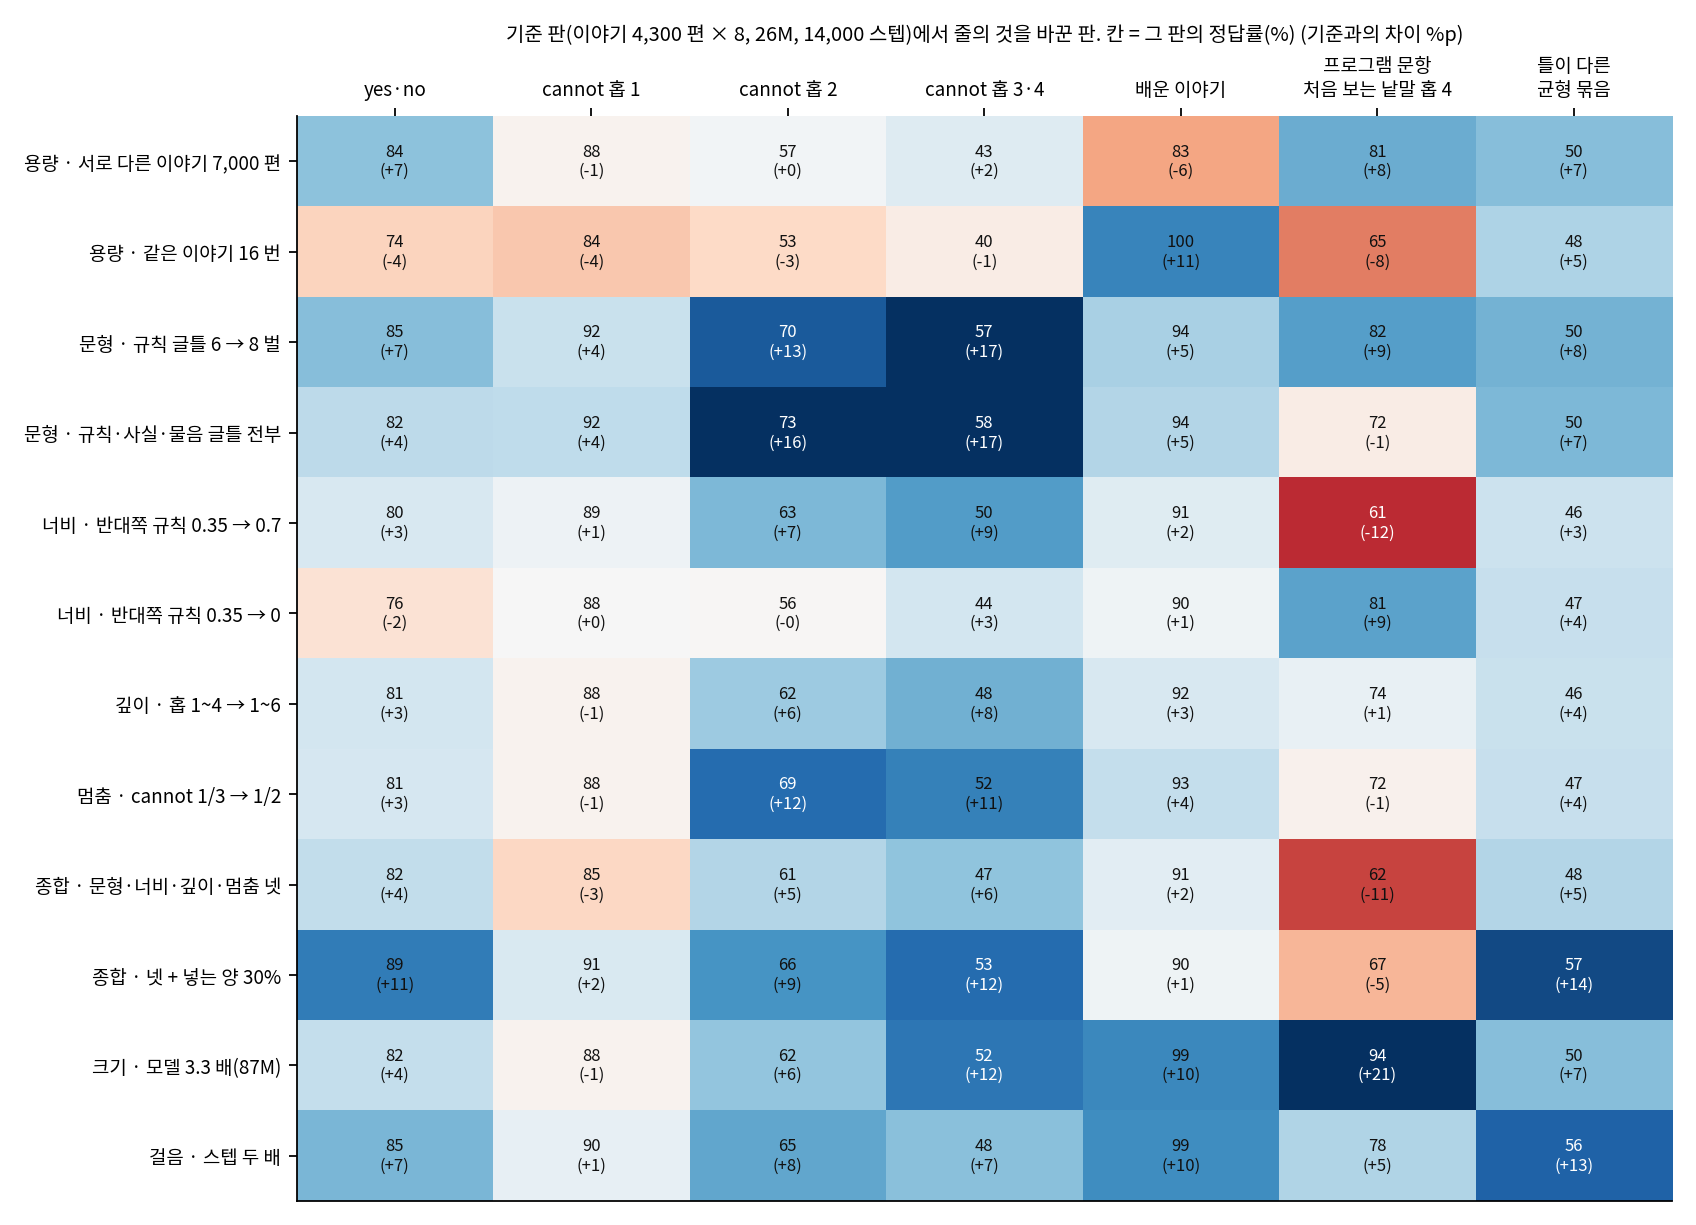
결과를 한 장에 모은 것이 아래 그림이다. 줄은 바꾼 것, 칸은 능력을 측정하는 시험이고, 칸 안의 위 숫자는 그 판의 정답률, 아래 괄호는 기준 판과의 차이다. 용량 축의 두 판과, 데이터 대신 모델 크기와 스텝을 바꾼 두 판도 같은 기준에 맞춰 함께 넣었다. 읽기 전에 시드 사이의 변동부터 적어 둔다. cannot 홉 3·4 는 기준 판의 세 시드가 51%, 37%, 34% 였고, 같은 판 안에서 30% 와 64% 가 함께 나온 판도 있다(sources/logic-limits/form_map.out 의 시드별 표). 세 시드가 모두 기준 판의 가장 높은 시드(51%)를 넘은 판은 글틀을 넓힌 두 판뿐이어서, 너비, 깊이, 멈춤 판의 홉 3·4 이득은 평균으로는 오르지만 시드 셋으로 확정한 것은 아니다.

줄마다 움직이는 칸이 달라요.
그림에서 읽은 것을 능력별로 적으면 다음과 같다.
- 용량. 서로 다른 이야기를 늘리면 yes·no 가 7%p 오르고 cannot 홉 3·4 는 그대로다. 같은 이야기를 더 보여 주면 배운 이야기만 100% 가 되고 나머지는 조금씩 내려간다.
- 문형. 규칙 글틀을 여덟 벌로 늘리면 cannot 홉 2 와 홉 3·4 가 13~17%p 오른다. 이 장의 실험 가운데 가장 큰 칸이다.
- 멈춤. cannot 비율을 1/2 로 올리면 cannot 홉 2 와 홉 3·4 가 11~12%p 오르고 yes·no 는 내려가지 않는다. 앞 절의 대조 쌍도 cannot 을 늘린 데이터였지만 이야기 700 쌍뿐이었고, 여기서는 프로그램 문항 수만 개의 비율을 바꿨다.
- 너비. 반대쪽 규칙을 늘리면 cannot 홉 3·4 가 9%p 오르지만 프로그램 문항이 12%p 내려간다. 빼는 쪽은 차이가 없다.
- 깊이. 홉 6 까지 배우게 하면 cannot 홉 2~4 가 6~8%p 오른다.
이게 이 장에서 그리려던 지도예요. 「데이터를 늘린다」는 한 가지 조작이 아니라 여러 가지 조작이에요. 늘리는 데이터가 어느 능력을 덮는지에 따라 움직이는 칸이 달라요. 그리고 같은 계산량에서 가장 많이 움직인 것은 양이 아니라 모양이었어요.

크기 줄도 봐요. 87M 은 프로그램 문항을 94 까지 올리는데 이야기 cannot 은 글틀 여덟 벌이랑 비슷해요.
크기와 스텝은 모든 칸을 조금씩 올렸고, 크기는 프로그램 문항과 배운 이야기를, 스텝은 틀이 다른 균형 묶음을 가장 크게 올렸다(87M 판은 시드 둘이다). 데이터의 모양은 칸을 골라서 올려서, 겨냥한 칸에서는 모양을 바꾼 판이 크기를 3.3 배로 키운 판만큼, 또는 그보다 더 올랐다. 어느 판에서도 오르지 않은 칸은 겉 단서를 뺀 균형 묶음의 cannot 이다. 균형 묶음의 yes 와 no 문항은 이야기 판들에서 41~70%, 61~86% 로 옮겨 갔는데 cannot 문항은 15~29% 에 묶여 있고, 이야기를 넣기 전 판의 48% 보다 낮다(sources/logic-limits/bench_by_answer.out).
문제 2. 무엇을 바꿀까
루나 설정서의 「모르면 모른다고 한다」 줄을 이야기 글에서도 지키고 싶다. 지도를 보고, 계산량을 늘리지 않고 cannot 홉 3·4 를 올리는 데이터 변경 둘을 고르라. 그리고 두 변경을 함께 했을 때 cannot 홉 3·4 가 얼마나 될지 예측하라.

글틀을 여덟 벌로 늘리는 것(+17)과 cannot 을 1/2 로 올리는 것(+11)이요.

합치면 41 에 17 이랑 11 을 더해서 69!
둘 다 같은 걸 고치는 거면 그렇게 안 더해질 수도 있어요. 둘 다 「멈출 자리를 알아보는 연습」을 늘리는 거라면 겹치는 만큼은 한 번만 올라요.

그래서 확인해 봐야 해요. 지도에서 오른 네 줄, 문형, 너비, 깊이, 멈춤을 한꺼번에 바꾼 판을 학습해 봐요.
네 가지를 한꺼번에 바꾸면
규칙·사실·물음 글틀을 모두 넣고, 반대쪽 규칙을 0.7 로, 홉을 1~6 으로, cannot 을 1/2 로 한꺼번에 바꾼 판이다.
| 판 | 전체 | cannot | cannot 홉 2 | cannot 홉 3·4 | 프로그램 문항 | 섞은 프로그램 문항 수 |
|---|---|---|---|---|---|---|
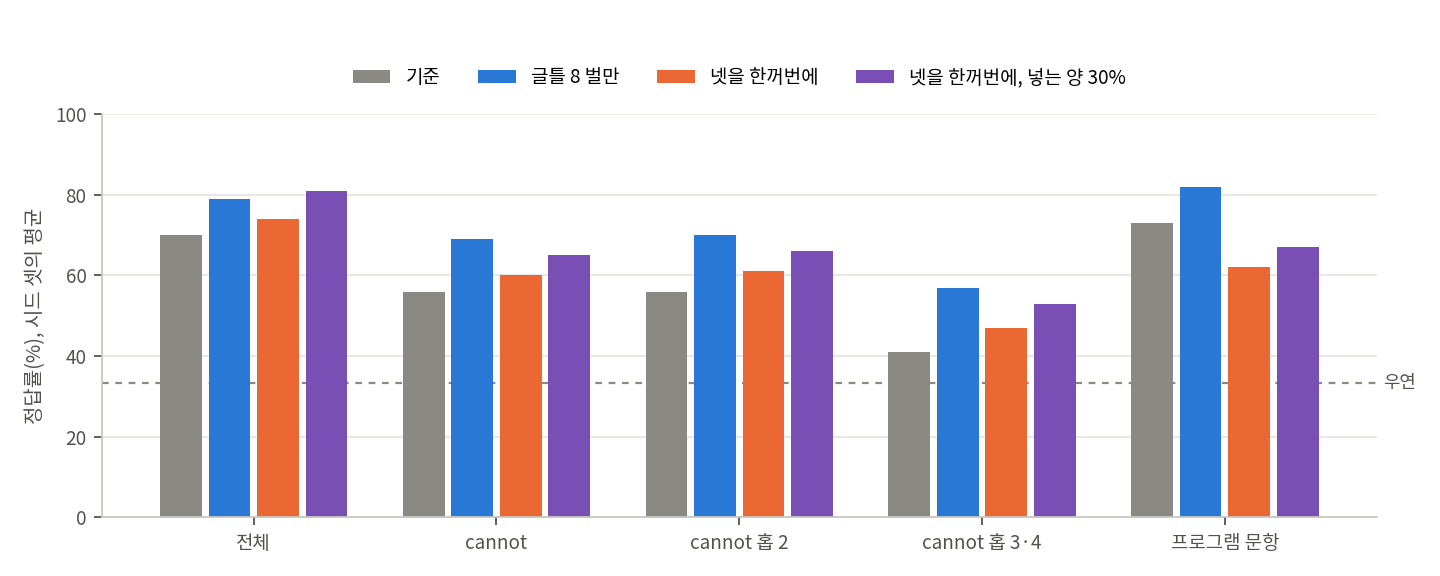
| 기준 | 70 | 56 | 56 | 41 | 73 | 132,654 |
| 글틀 8 벌만 | 79 | 69 | 70 | 57 | 82 | 131,611 |
| 넷을 한꺼번에 | 74 | 60 | 61 | 47 | 62 | 102,433 |
| 넷을 한꺼번에, 넣는 양 30% | 81 | 65 | 66 | 53 | 67 | 301,890 |
위 표는 네 가지를 한꺼번에 바꾼 판이다(sources/logic-limits/form_map.out, plot_logic_data.out 의 X15R·X30R, runs_bridge/mix_X15R.log·mix_X30R.log, 시드 셋, %). 섞은 프로그램 문항 수는 로그의 문항 수에서 딥시크 이야기 34,400 편을 뺀 수다. 전체 정답률은 시드별로 넷을 한꺼번에 바꾼 판이 81·73·69, 넣는 양 30% 판이 74·84·84 였다.
넷을 합친 판은 글틀 하나만 바꾼 판보다 높지 않았고(74% 대 79%), 시드 사이가 69~81% 로 벌어졌다. 민준의 덧셈도 하은의 「겹치는 만큼 한 번만」도 아니었는데, 표의 마지막 칸이 단서다. 넣는 양 15% 는 토큰 수로 정해 두었으므로, 홉이 늘고 반대쪽 규칙이 붙어 문항이 길어지자 같은 양 안에 든 프로그램 문항이 13만 3천 개에서 10만 2천 개로 줄었고, 그 문항이 글틀 열두 벌, 홉 여섯 가지, 반대쪽 규칙의 있고 없음으로 나뉘었다.

처음 보는 낱말에서 명사만 383 개로 넓혔을 때랑 같은 모양이에요. 넓힌 만큼 문항이 더 있어야 했는데 문항 수는 그대로여서 오히려 내려갔잖아요.
같은 판을 논리 글 30% 로 다시 학습해 프로그램 문항을 30만 2천 개로 늘리자(스텝 수는 그대로여서 이야기 한 편을 보는 횟수는 조금 줄었다) 전체는 81%, yes·no 는 90%·88% 로 이 장에서 가장 높았고, 균형 묶음도 57% 로 기준보다 14%p 높아졌다. 그러나 cannot 은 65%, 홉 3·4 는 53% 로 글틀 하나만 바꾼 판(69%, 57%)을 넘지 못했다.
모양을 넓히면 그 모양마다 다시 양이 필요해요. 모양과 양은 따로 떼어 정할 수 있는 조건이 아니에요. 그리고 양을 채워도 홉 3·4 의 cannot 은 55% 안팎에서 더 오르지 않았어요.
끊기기 전에 이은 홉 수로 다시 나누면
홉 3·4 의 cannot 이라는 칸에는 첫 홉에서 끊기는 문항이 절반 가까이 섞여 있었다. 그래서 cannot 문항 519 개 전체를 끊기기 전에 맞게 이은 홉 수로 다시 나눠 측정했다.
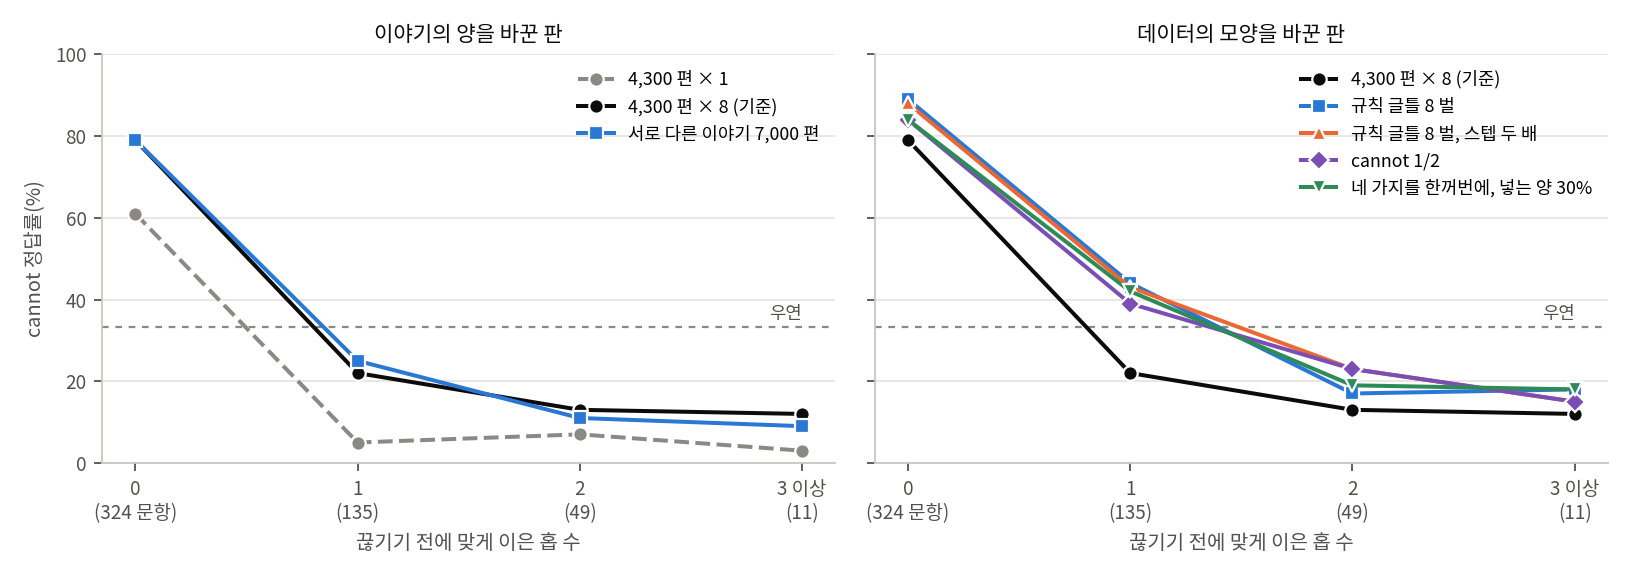
| 판 | 이은 홉 0 (324 문항) | 1 (135) | 2 (49) | 3 이상 (11) |
|---|---|---|---|---|
| 4,300 편 × 1 | 61 | 5 | 7 | 3 |
| 4,300 편 × 8 (기준) | 79 | 22 | 13 | 12 |
| 서로 다른 이야기 7,000 편 | 79 | 25 | 11 | 9 |
| 규칙 글틀 8 벌 | 89 | 44 | 17 | 18 |
| 규칙 글틀 8 벌, 스텝 두 배 | 88 | 43 | 23 | 15 |
| cannot 1/2 | 84 | 39 | 23 | 15 |
| 네 가지를 한꺼번에, 넣는 양 30% | 84 | 42 | 19 | 18 |
위 표는 cannot 문항을 끊기기 전에 맞게 이은 홉 수로 나눈 정답률(%)로, 떼어 둔 이야기 1,511 문항에서 시드 셋을 합친 값이다(sources/logic-limits/form_map.out 의 마지막 표).
이 장에서 오른 것은 모두 앞의 두 줄, 이은 홉이 0 과 1 인 문항이었다. 0 은 61% 에서 89% 로, 1 은 5% 에서 44~50% 로 올랐다. 두 홉 이상을 맞게 이은 뒤 멈춰야 하는 문항은 어느 판에서도 23% 를 넘지 못했고, 우연(33%)보다도 낮다. 이 칸은 문항이 60 개뿐이라 판끼리의 작은 차이는 읽을 수 없지만, 모든 판이 우연 아래라는 것은 읽을 수 있다.
두 홉을 맞게 가면 그 다음은 무조건 이어 가요. 틀린 답이 다 yes 나 no 예요.
학습 이야기 4,300 편에서 이런 문항이 몇 편이나 됐어요?

176 편이에요. 이야기를 만드는 프로그램이 끊기는 자리를 이른 홉에 몰아서 뽑았거든요. 프로그램 문항은 같은 칸을 배운 글틀에서는 92~98% 푸는데, 이야기 말투로 쓴 깊은 끊김은 거의 본 적이 없는 거예요. 두 홉 넘게 이은 뒤 멈추는 문항이 이 장의 데이터 조작으로 넘지 못한 칸이에요.
깊은 칸 이야기가 끝나자 서연은 표의 둘째 칸, 한 홉을 이은 뒤 멈추는 문항으로 손가락을 옮겼다. 이야기를 한 번씩 넣은 판에서 5% 이던 칸이 규칙 글틀 여덟 벌에서 44% 가 되었다. 서연은 그 칸에서 편수를 세 배로 늘려도 「Then the pony is white」라고 이어 가던 문항 하나를 골라, 이야기를 넣기 전 판, 이야기를 한 번씩 넣은 판, 글틀을 여덟 벌로 늘린 판(모두 시드 1)이 이어 쓴 풀이를 나란히 띄웠다(sources/logic-limits/runs_bridge/ 의 story_y5R_s1_held.json, story_e5R_s1_held2.json, story_M15R_s1_held2.json).
문항: Amy looked in the snow and saw that the grass is not fast. Amy asked, "Is it true that the pony is white?" … Max thought out loud.   (정답은 cannot)
  이야기를 넣기 전:          "The cave is smooth, so it is not true that the grass is fast." "So the answer is no, the answer is no."
  이야기 4,300 편을 한 번씩:  "The grass is not fast, so the bell is quiet. Then the pony is white. So the answer to the question is yes." Max says yes.
  규칙 글틀 여덟 벌:         "The grass is not fast, so the bell is quiet. Here it breaks. The only rule about this needs the bell is not quiet, but we have the bell is quiet. No rule tells about that case." Max says we cannot tell.
세 사람은 셋째 줄 앞에서 한동안 말이 없었다.
「Here it breaks.」래. 여기서 끊긴다고 루나가 자기 말로 했어. 종은 조용한데 규칙은 조용하지 않을 때 얘기라는 것까지 짚고.
첫 줄은 이야기에 없는 동굴을 꺼냈고, 둘째 줄은 끝까지 갔다가 틀렸고, 셋째 줄만 멈췄네요. 셋째 줄 판은 이야기를 더 쓴 판이 아니죠?
응. 이야기는 한 편도 바꾸지 않고 프로그램 문항의 규칙 글틀만 여섯 벌에서 여덟 벌로 늘린 판이야. 딴 이야기를 쓰던 루나가 이야기 속 규칙을 한 칸 따라가고, 맞지 않는 데서 멈췄어.
| 측정한 것 | 이야기를 넣기 전 | 이야기 4,300 편을 한 번씩 | 규칙 글틀 여덟 벌 |
|---|---|---|---|
| 떼어 둔 이야기 전체 | 27 / 29 / 29% | 67 / 65 / 65% | 79 / 79 / 80% |
| 그 가운데 cannot 문항 | 54 / 48 / 41% | 41 / 41 / 39% | 65 / 71 / 70% |
| 답 문장을 쓰지 않은 문항 | 39 / 43 / 40% | 2 / 2 / 2% | 0 / 1 / 1% |
위 표는 시드별 값이고 우연은 33% 다(sources/logic-limits/story_summary.out). 이야기를 넣기 전 판은 떼어 둔 453 문항, 나머지 두 판은 1,511 문항에서 측정했으므로 첫 열은 같은 시험지의 값이 아니다. 첫 열의 cannot 은 yes·no 문항을 11~25% 만 맞히는 판이 답을 쓸 때 대개 cannot 을 고른 값이고, 위 문항에서도 풀이는 틀렸는데 뒤에 이어 쓴 글에 「We cannot tell」이 나와 맞은 것으로 채점되었다.
이야기 편수는 답 문장을 쓰게 하고 yes·no 문항을 올렸지만 cannot 은 그대로 두었다. 그 칸을 움직인 것은 이야기의 양이 아니라 프로그램 문항의 모양이었다. 늘린 데이터가 어느 능력을 덮느냐에 따라 오르는 칸이 정해졌고, 이 장의 어떤 데이터도 덮지 못한 깊은 멈춤 칸은 앞의 표처럼 23% 아래에 남았다.