문형: 규칙을 말하는 방식
용량 축을 다 쓰고도 남은 칸을 보려고, 서연은 cannot 문항을 한 번 더 나누었다. 이번에는 끊기는 규칙을 이야기가 어떤 말로 했는지로 나눈다. 딥시크는 같은 규칙 「the bell is not quiet → the pony is white」를 「If the bell is not quiet, then the pony is white.」로도, 「The pony is white as soon as the bell is not quiet.」로도, 「The bell is not quiet means the pony is white.」로도 쓴다. 계층 구조를 시험하는 Lano 시험이 문법의 나무 모양을 배우는지를 보았다면, 여기서는 조건이 문장의 어디에 놓였는지를 읽어 내는지를 본다.
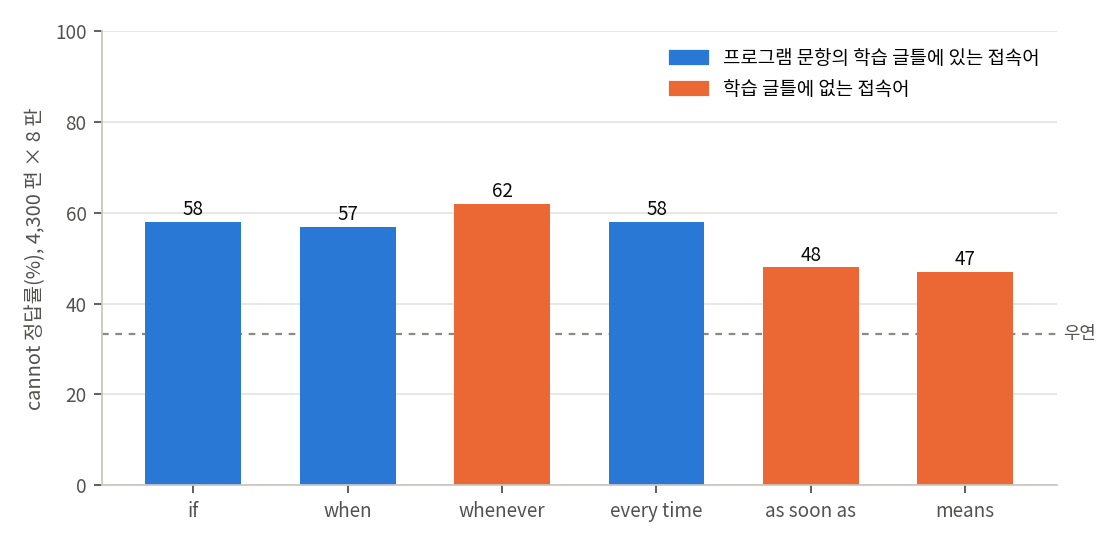
| 끊기는 규칙의 접속어 | if | when | whenever | every time | as soon as | means |
|---|---|---|---|---|---|---|
| cannot 문항 수 | 202 | 137 | 52 | 30 | 40 | 56 |
| 4,300 편 × 8 판의 정답률 | 58 | 57 | 62 | 58 | 48 | 47 |
| 프로그램 문항의 학습 글틀에 | 있음 | 있음 | 없음(시험용) | 있음 | 없음 | 없음 |
위 표는 끊기는 규칙의 접속어로 나눈 cannot 정답률(%)로, 떼어 둔 이야기 1,511 문항에서 시드 셋을 합친 값이다(sources/logic-limits/form_map.out 의 n15R).
as soon as 랑 means 가 10 점쯤 낮아요. 둘 다 프로그램 문항에는 없는 말이에요. 이야기는 4,300 편이지만 프로그램 문항은 16만 개가 넘으니까, 규칙을 따라가는 법은 거의 프로그램 문항에서 배웠을 거예요.

whenever 도 프로그램 문항에는 없는데 62 잖아.
「Whenever A, B.」는 「When A, B.」랑 모양이 같아요. 「A means B.」는 조건을 알리는 낱말 없이 평서문처럼 시작하고요.
서연의 짐작대로 프로그램 문항의 규칙 글틀 여섯 벌에 「A means B.」와 「As soon as A, B.」 두 벌을 더한 판을 학습했고, 이야기와 모델과 스텝, 시험에 쓰는 글틀은 모두 그대로 두었다. 이야기가 쓰는 문형을 더 넣은 판도 하나 두었는데, 규칙 글틀에 「B as soon as A.」와 「A means that B.」를 더하고 사실과 물음의 글틀에도 이야기에서 흔한 「Max saw that …」, 「Amy asked, “Is it true that …?”」를 더한 판이다.
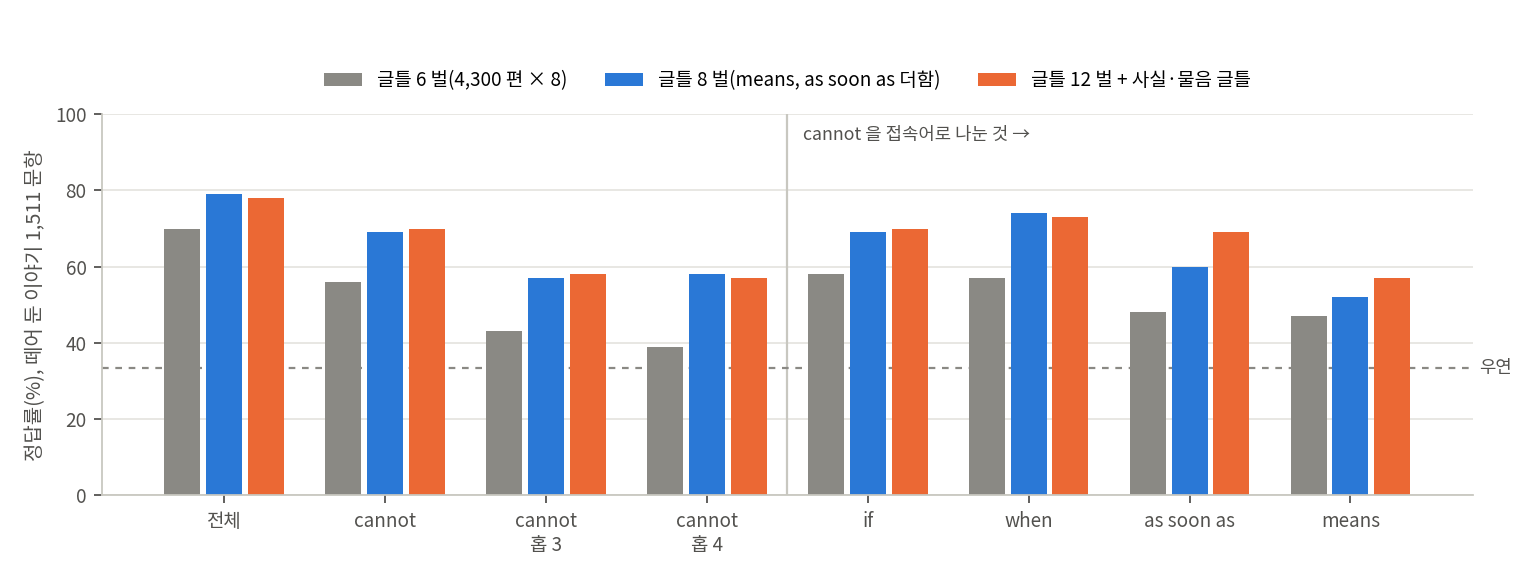
| 판 | 전체 | cannot | cannot 홉 3 / 4 | if | when | as soon as | means |
|---|---|---|---|---|---|---|---|
| 글틀 6 벌(4,300 편 × 8) | 70 | 56 | 43 / 39 | 58 | 57 | 48 | 47 |
| 글틀 8 벌(means, as soon as 더함) | 79 | 69 | 57 / 58 | 69 | 74 | 60 | 52 |
| 글틀 12 벌 + 사실·물음 글틀 | 78 | 70 | 58 / 57 | 70 | 73 | 69 | 57 |
위 표는 프로그램 문항의 글틀만 바꾼 판들이다(sources/logic-limits/form_map.out 의 n15R·M15R·F15R, 시드 셋, %). 전체 정답률은 시드별로 70·74·68 → 79·79·80 → 79·76·79 였다.

올랐어요. 세 시드가 79, 79, 80 이에요. 이야기는 한 편도 안 건드렸는데 이야기 시험이 9 점 올랐어요.

딥시크한테 몇천 편을 더 쓰게 할 생각만 했는데, 프로그램 문항 글틀 두 벌이었어? 편수로는 꿈쩍도 안 하던 cannot 이 69 야!
이야기는 한 편도 바꾸지 않았는데 글틀 두 벌을 더한 판은 전체 70% 에서 79% 로, cannot 은 56% 에서 69% 로, 홉 3·4 의 cannot 은 40% 안팎에서 57% 안팎으로 올랐고, 세 시드가 모두 79~80% 였다. 그런데 서연이 짚은 means 문형은 47% 에서 52% 로 가장 적게 오르고, 원래 글틀에 있던 if 와 when 이 11~17%p 씩 올랐다. 글틀을 열두 벌로 더 늘리고 사실과 물음의 글틀까지 넓힌 판은 두 벌을 더한 판과 거의 같았다.
빠진 문형을 채워서 오른 거라면 means 줄이 제일 크게 올라야 해요. 그렇지 않았으니, 측정한 대로만 말하면 「규칙 글틀을 여섯 벌에서 여덟 벌로 늘리자 모든 문형이 함께 올랐고, 그 뒤로 더 늘려도 그대로였다」예요. 왜 모든 문형이 함께 올랐는지는 이 실험으로는 가를 수 없어요.
그래도 이거 하나로 87M 모델보다 높잖아요.
민준의 말은 평균으로 맞다. 같은 데이터로 모델을 3.3 배(12층, 폭 768, 8,702만 개)로 키운 판은 전체 75%, cannot 64% 였고, 스텝을 28,000 으로 두 배 늘린 판은 77%, 62% 였다. 글틀 두 벌을 더한 판은 계산량이 그대로인 채 79%, 69% 다. 다만 87M 판은 시드가 둘뿐이고 전체가 79% 와 72% 로, cannot 홉 3·4 가 66% 와 38% 로 갈렸으므로 시드 셋으로 확정한 비교는 아니다.