한계 지도: 문항 수와 상관없는 규칙
네 후보 가운데 먼저 알고 싶은 것은 문항의 수다. 루나에게 읽힌 논리 이야기 2,900 묶음은 규칙을 배우기에 많은 것일까, 적은 것일까? 서로 다른 문항의 수를 1,000 개에서 30만 개까지, 홉 카운트를 1 에서 6 까지 바꾸었다. 모델과 학습 시간은 그대로여서, 문항이 적은 칸은 같은 문항을 여러 번 다시 읽고 문항이 많은 칸은 문항마다 두세 번만 읽는다.
| 홉 카운트 | 1천 | 3천 | 1만 | 3만 | 10만 | 30만 |
|---|---|---|---|---|---|---|
| 1 | 53.4 | 76.1 | 97.9 | 98.8 | 100.0 | 99.9 |
| 2 | 45.3 | 56.3 | 86.3 | 96.0 | 99.3 | 99.6 |
| 3 | 40.4 | 47.3 | 86.0 | 92.9 | 96.2 | 97.8 |
| 4 | 37.3 | 43.6 | 78.2 | 94.8 | 97.6 | 98.1 |
| 6 | 37.0 | 45.2 | 74.3 | 87.1 | 95.2 | 97.3 |
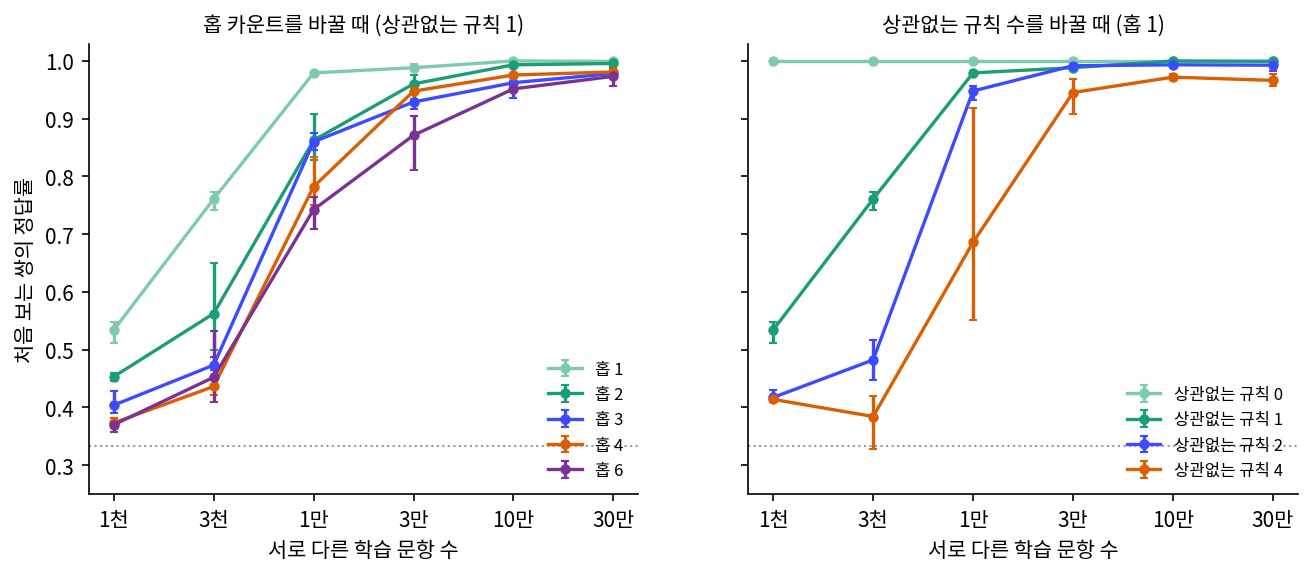
표의 값은 시드 셋의 평균 정답률(%)이다(sources/logic-limits/map_summary.out). 문항이 1,000 개인 칸은 학습 문항을 100% 맞히면서 처음 보는 쌍은 우연 근처여서, 문항을 외운 것이다. 문항이 1만 개를 넘는 곳에서 정답률이 가파르게 오르고, 95% 를 넘는 데 홉 1 은 1만, 홉 2 는 3만, 홉 6 은 10만 문항이 필요했다.
모델은 그대로인데 문항만 늘렸더니 37 에서 98 이 됐어. 우리가 루나한테 준 논리 이야기가 2,900 묶음이었지.

표의 맨 왼쪽 칸 근처네. 외우는 칸.
오른쪽 그림은 홉 카운트를 1 로 묶고 상관없는 규칙의 수를 바꾼 것이다. 상관없는 규칙이 하나도 없으면 문항 1,000 개로 100% 를 맞혔는데, 하나가 끼면 1만 개가 필요했고 넷이 끼면 3만 개에서 94.5% 였다. 홉 하나를 늘리는 것보다 상관없는 규칙 하나를 끼우는 것이 문항을 더 많이 요구했으니, 규칙을 잇는 일보다 이어야 할 규칙을 여러 규칙 가운데서 찾는 일이 먼저 배워야 하는 일이다.
성질의 수와 학습 시간은 문턱을 옮기지 못했다. 성질을 24 개, 96 개, 480 개로 바꿔도 문항 1만 개에서 91.2%, 86.3%, 86.4% 였다(시험 문항은 학습에 나온 성질로만 만들었으므로, 학습 문항에 없던 낱말로 된 문항을 푸는지는 여기서 알 수 없다). 홉 4 에 문항 3,000 개인 칸은 스텝을 네 배인 24,000 으로 늘려도 43.6% 에서 44.7% 였고, 문항 1만 개인 칸도 78.2% 에서 83.2% 로 조금 오르는 데 그쳤다.
문제 2. 무엇을 늘릴까
홉 6, 문항 3만 개인 칸의 정답률은 87.1% 이고, 95% 를 넘기려고 한 가지만 바꿀 수 있다. (가) 학습을 네 배로 늘린다 (나) 성질을 96 개에서 24 개로 줄인다 (다) 문항을 10만 개로 늘린다. 한계 지도는 어느 것을 가리키는가?

(다). 같은 줄에서 10만 개가 95.2% 야.

(가)도 조금은 오르지 않을까? 문항 1만 개인 칸에서 78 이 83 이 됐잖아.

오를 수 있어요. 다만 홉 6 에서 스텝을 늘린 칸은 측정하지 않았으니 얼마나 오를지는 몰라요. 측정한 범위에서 말하면, 스텝을 네 배로 늘려 얻은 5 점보다 문항을 세 배로 늘려 얻은 값이 컸어요. (나)는 성질 수를 바꾼 세 칸이 비슷했으니 기대하기 어려워요.