풀이를 적게 하면
지도에는 넘지 못한 칸이 둘 남았는데, 층이 둘뿐인 모델과 문항이 1만 개 아래인 칸이다. 사람은 긴 체인을 머릿속으로만 풀지 않고 가운데 결론을 종이에 적으면서 푼다. 그렇다면 모델에게도 답하기 전에 가운데 결론을 쓰게 하면 어떨까?

여러 단계가 필요한 계산을 한 번에 내놓게 하면 못 하던 모델이, 중간 결과를 쓰도록 학습하면 긴 덧셈과 프로그램 실행까지 해낸다는 것을 맥스웰 나이(Maxwell Nye)와 동료 연구자들이 2021년에 보였어요. 그 논문은 모델이 중간 결과를 쓰는 자리를 스크래치패드라고 불렀어요. 우리도 같은 것을 가장 작은 규모로 해 봐요. 대조군을 하나 더 둬야 하고요.
같은 문항에서 답 앞에 쓰는 글만 다른 세 판을 만들었다(sources/logic-limits/steps.py). 바로 답하기는 지금까지처럼 문항 바로 뒤에 답을 쓴다. 풀이 적기는 사실에서 출발해 규칙을 하나 쓸 때마다 얻은 결론을 「so」로 이어 적고 나서 답하고, 체인이 끊기는 자리에서는 「so」 대신 cannot 을 쓴다. 채우기는 풀이 적기와 같은 길이만큼 뜻 없는 낱말 「think」를 늘어놓고 답한다.
바로 답하기   … Lucy sees that the jar is not open. Sue says no
풀이 적기     … Lucy sees that the jar is not open. Sue says the jar is not open so the gate is not dry so the cat is not loud so the bird is not big no
채우기       … Lucy sees that the jar is not open. Sue says think think think … think no
채우기는 왜 넣어요? 답이 뻔한데.

답 앞에 토큰이 늘면 모델이 계산할 자리도 늘어. 풀이 적기가 이겼을 때, 적은 내용 때문인지 자리가 늘어서인지를 가르려면 자리만 늘린 판이 있어야 해.
홉 4 까지 배운 모델을 다섯 칸에서 비교했다. 풀이 적기 판은 문항만 주고 한 토큰씩 스스로 쓰게 해서, 처음 나온 답 토큰으로 채점했다.
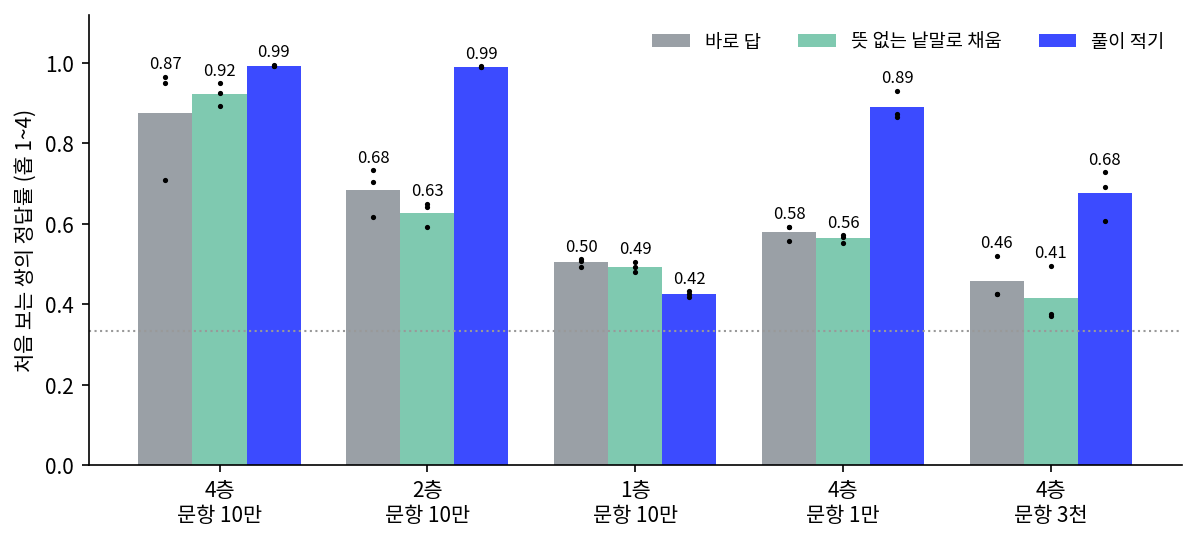
| 칸 | 바로 답하기 | 채우기 | 풀이 적기 |
|---|---|---|---|
| 4층, 문항 10만 | 87.5 | 92.2 | 99.3 |
| 2층, 문항 10만 | 68.5 | 62.8 | 99.0 |
| 1층, 문항 10만 | 50.4 | 49.2 | 42.5 |
| 4층, 문항 1만 | 58.0 | 56.4 | 89.0 |
| 4층, 문항 3천 | 45.7 | 41.4 | 67.5 |
값은 시드 셋의 평균(%)이다(sources/logic-limits/steps_summary.out). 2층 모델은 바로 답하기로 68.5% 였는데 풀이를 적게 하자 99.0% 가 되어 4층 모델과 같아졌고, 문항이 1만 개뿐인 칸도 58.0% 에서 89.0% 로 올랐다. 채우기는 2층과 문항 1만 개 칸에서 바로 답하기보다 낮았으므로, 두 칸에서 오른 것은 늘어난 자리가 아니라 적은 내용 덕분이다. 풀이를 적으면 모델은 한 번에 규칙 하나만 이으면 되고, 방금 적은 결론을 다음 홉의 출발점으로 다시 읽을 수 있다.
4층도 달라졌어. 바로 답하기는 시드 하나가 71 에서 멈췄는데, 풀이 적기는 셋 다 99 야.

1층은 풀이를 적어도 42 네. 홉 하나도 층 하나로는 안 되는 거야.
문항이 3,000 개인 칸은 67.5% 까지만 올랐으니, 풀이를 적는 일은 필요한 문항 수를 열 배쯤 줄여 주었지만 0 으로 만들지는 못했다. 여기까지는 홉 4 까지 배운 칸에서 얻은 결론이다. 돌린 일곱 칸 가운데 표에 싣지 않은 「홉 2 까지만 배운 칸」에서는 풀이 적기의 시드 하나가 cannot 문항을 하나도 맞히지 못해서, 평균이 88.4% 로 바로 답하기의 93.9% 보다 낮았다.
배운 것보다 긴 체인
홉 4 까지만 배운 모델이 더 긴 체인을 푸는지도 측정했다. 측정용 모델은 토큰의 자리마다 위치 임베딩을 따로 배우므로, 긴 문항의 끝자리가 한 번도 학습되지 않은 자리로 남지 않도록 세 판 모두 글이 시작하는 자리를 무작위로 밀어 학습했다(밀지 않은 한계 지도의 칸들은 긴 체인에서 대부분 35~55% 였다). 바로 답하기는 홉 5 에서 79.8%, 홉 6 에서 76.2% 를 맞혔고, 풀이 적기는 95.2%, 83.7% 였다. 홉 8 에서는 64.4% 와 55.7% 로 둘 다 떨어졌으므로, 모델은 배운 것보다 홉이 한둘 많은 체인까지는 풀고 그 범위에서는 풀이 적기가 더 낫다고 말할 수 있다.
문제 3. 풀이는 틀리고 답은 맞다
2층 모델의 풀이 적기 판은 홉 4 문항에서 답을 98.3% 맞혔다. 그런데 적은 풀이가 처음부터 끝까지 정답 풀이와 글자 그대로 같은 문항은 34.1% 뿐이었다. 4층 모델은 답 98.1%, 풀이 92.8% 다(시드 셋의 평균,
sources/logic-limits/steps_results.jsonl의 홉 4 값). (가) 2층 모델은 적은 풀이를 읽고 답했다고 말할 수 있는가? (나) 이것을 가리려면 무엇을 더 측정해야 하는가?

(가) 풀이가 틀렸는데 답이 맞으면, 풀이를 안 보고 답한 거 아니야?
꼭 그렇진 않아. 풀이가 어디서 틀렸는지 몰라. 중간 성질의 이름 하나를 잘못 적고도 마지막 결론은 맞게 적었을 수 있어. 「글자 그대로 같다」는 기준이 너무 엄한 걸 수도 있고.
(나)는 적은 풀이를 일부러 고쳐 보면 돼요. 모델이 쓴 가운데 결론 하나를 반대로 바꿔 넣고, 답이 따라 바뀌는지 보는 거예요. 바뀌면 읽고 답한 거고, 안 바뀌면 풀이는 장식이에요.
하은 학생의 방법이 맞아요. 이 장에서는 그 실험을 하지 않았으니, 2층 모델이 풀이를 읽고 답했다고도 안 읽었다고도 적지 않아요. 적을 수 있는 것은 풀이를 적도록 학습한 2층 모델이 답을 98.3% 맞혔다는 것까지예요.