처음 보는 낱말: 막는 것을 다시 측정한다
표를 본 하은이 손을 들었다. 시험 문항이 학습 문항과 같은 프로그램에서 나왔으므로, 쌍은 처음 보는 것이어도 「Sue says the rule.」로 시작하는 글의 모양과 lamp, gate 같은 낱말은 모두 배운 것이다.
글의 모양을 외운 건지, 낱말을 외운 건지, 규칙을 잇는 법을 배운 건지 이 시험으로는 못 갈라요.
그래서 겉모습을 한 가지씩 바꾼 시험을 만들었다(sources/logic-limits/luna_surface.py). 규칙 문장의 틀은 「If A, then B.」, 「When A, B.」, 「B if A.」를 비롯한 여섯 벌로 학습하고 「Whenever A, B.」처럼 학습에 없던 틀로 시험했다. 낱말은 학습 문항에 한 번도 나오지 않은 명사 12 개(apple, moon 등)와 상태 낱말 8 개(blue, cold 등)로 시험했는데, 이 낱말들은 동화에는 흔히 나온다. 풀이 적기 문항 5% 를 넣은 루나는 처음 보는 틀의 문항을 홉 2 에서 100%, 홉 4 에서 96% 맞혔지만, 처음 보는 낱말의 문항은 47% 와 34% 였다(시드 하나).

틀은 여섯 벌만 보여 줘도 일곱째 틀을 푸는데, 낱말은 안 되네. 그럼 낱말도 많이 보여 주면 되잖아!
민준의 말대로 성질을 96 개에서 3,000 개로 넓혔지만(명사 185 개, 상태 낱말 63 개에 「the N has a M」, 「the N rings」 같은 모양을 더했다) 처음 보는 낱말의 홉 4 는 60%, 59%, 43% 에 머물렀고, 넣는 양을 5% 에서 15% 로 세 배 늘려도 49%, 50%, 44% 였다(시드 셋). 홉 2 는 87%, 78%, 58% 였다.

지도에서는 문항 수가 제일 셌는데. 세 배를 넣었는데 왜 그대로야?
우리 또 넣을 것부터 골랐어. 뭐가 막는지 측정 안 했잖아.
낱말의 무엇이 막는가
서연은 「처음 보는 낱말」이라는 한 칸을 넷으로 나누어, 이미 학습한 루나에게 시험만 다르게 냈다(sources/logic-limits/surface_diag.py). 낱말은 배웠지만 둘의 묶음이 처음인 문항, 명사만 처음인 문항, 상태 낱말만 처음인 문항, 둘 다 처음인 문항이다. 대조도 하나 넣었다. 처음 보는 명사는 12 개뿐이어서 성질 일곱 개가 들어가는 문항 하나에 같은 명사가 여러 번 나오는데, 학습 문항은 명사 185 개에서 뽑으므로 그런 일이 드물다. 낱말이 처음이어서 틀리는 것과 같은 명사가 겹쳐서 틀리는 것을 가르려고, 배운 낱말을 명사 12 개와 상태 낱말 8 개로 좁힌 문항을 함께 풀게 했다.
| 시험 문항의 낱말 | 홉 2 | 홉 4 |
|---|---|---|
| 학습 문항에 나온 성질 그대로 | 98 | 96 |
| 낱말은 배웠고 묶음만 처음 | 98 | 94 |
| 배운 낱말, 같은 명사가 겹침 | 90 | 76 |
| 배운 낱말, 명사가 겹치지 않음 | 95 | 91 |
| 명사만 처음(겹치지 않음) | 95 | 85 |
| 상태 낱말만 처음(겹치지 않음) | 72 | 59 |
| 둘 다 처음(겹침) | 69 | 53 |
표의 값은 시드 셋의 평균 정답률(%)이다(sources/logic-limits/diag_summary.out의 w5R). 묶음만 처음인 문항은 그대로 풀었으므로 루나가 「the lamp is red」라는 성질 하나하나를 외운 것은 아니다. 정답률을 떨어뜨린 것은 둘이었다. 하나는 같은 명사의 겹침으로, 배운 낱말만 써도 명사가 겹치면 홉 4 가 91% 에서 76% 로 내려갔다. 다른 하나는 상태 낱말로, 처음 보는 상태 낱말은 59% 였고 처음 보는 명사는 85% 였다. 학습 문항에서 명사 자리에는 185 개가, 상태 낱말 자리에는 63 개가 섰으니, 낱말의 가짓수가 적은 자리에서 더 크게 떨어진 것이다. 시험용 낱말 스무 개는 모두 토큰 하나였으므로 토큰이 조각나서 생긴 일도 아니다.
상태 낱말만 처음인 문항에서 루나가 틀리게 쓴 풀이 하나를 보면, 겹침이 무엇을 하는지 드러난다.
Bob wants to know if the corn is long. Max tells the rules. The pony is cold when the yard is not sad. If the pony is dark, then the yard is not sad. If the tiger is not small, then the sand is not blue. If the bottle is blue, then the pony is dark. The corn is long if the pony is cold. Max says the tiger is not small. Bob looks and the bottle is blue. Max says
  정답 풀이: the bottle is blue so the pony is dark so the yard is not sad so the pony is cold so the corn is long
  루나:      the bottle is blue so the pony is dark so the corn is not red. Max says no.
pony 가 규칙 네 개에 나와요. 「the pony is dark」에서 yard 로 가야 하는데, 「the pony is cold」가 조건인 corn 규칙으로 건너뛰었어요. 명사만 보고 다음 규칙을 찾은 거예요.
학습 문항에서는 명사만 봐도 다음 규칙이 하나로 정해졌어요. 명사가 겹치지 않았으니까요. 루나는 주어진 문항에서 통하는 가장 싼 방법을 배웠고, 그 방법이 안 통하는 문항은 학습에 없었어요. 끝의 규칙만 읽던 모델과 같은 일이에요.
문제 4. 세 배를 넣어도 오르지 않을 때
성질을 3,000 개로 넓힌 문항을 5% 넣은 판과 15% 넣은 판이 처음 보는 낱말의 홉 4 문항에서 둘 다 50% 안팎이다. 다음 가운데 진단표가 가리키는 것을 고르고, 그렇게 고쳤을 때 표의 어느 줄이 오를지 미리 적어라. (가) 30% 를 넣는다 (나) 학습 문항의 절반을 명사 서너 개와 상태 낱말 서너 개만으로 만들어 한 문항에 같은 명사가 겹치게 한다 (다) 상태 낱말을 63 개에서 168 개로 늘린다.

(가)는 아니야. 세 배에서 안 올랐으니까.

(나)를 하면 「배운 낱말, 같은 명사가 겹침」 줄이 오를 거야. 76 이 91 근처로. (다)를 하면 「상태 낱말만 처음」 줄이 오르고.
두 줄이 따로 오르는지 보려면 한 번에 하나씩 넣어야 해요. (나)만 넣은 판, 거기에 (다)를 더한 판.

그렇게 돌려 봐요. 미리 적은 줄이 오르고 다른 줄은 그대로면 진단이 맞은 거예요.
진단대로 고친다
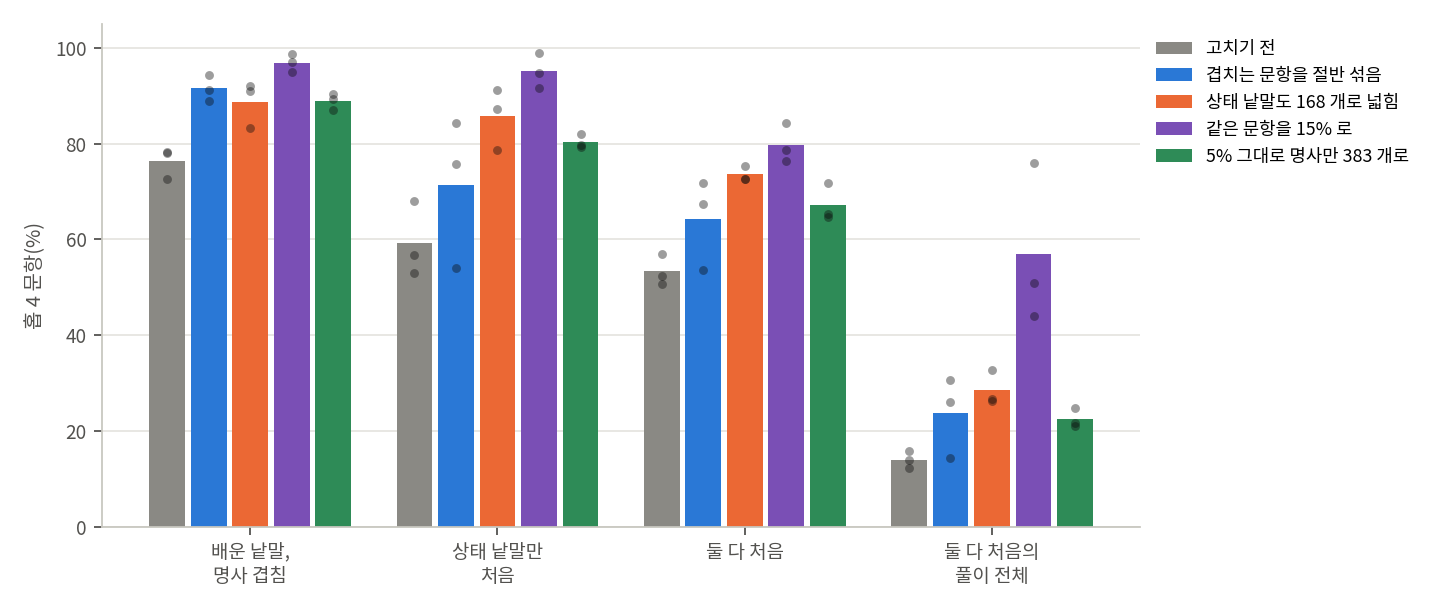
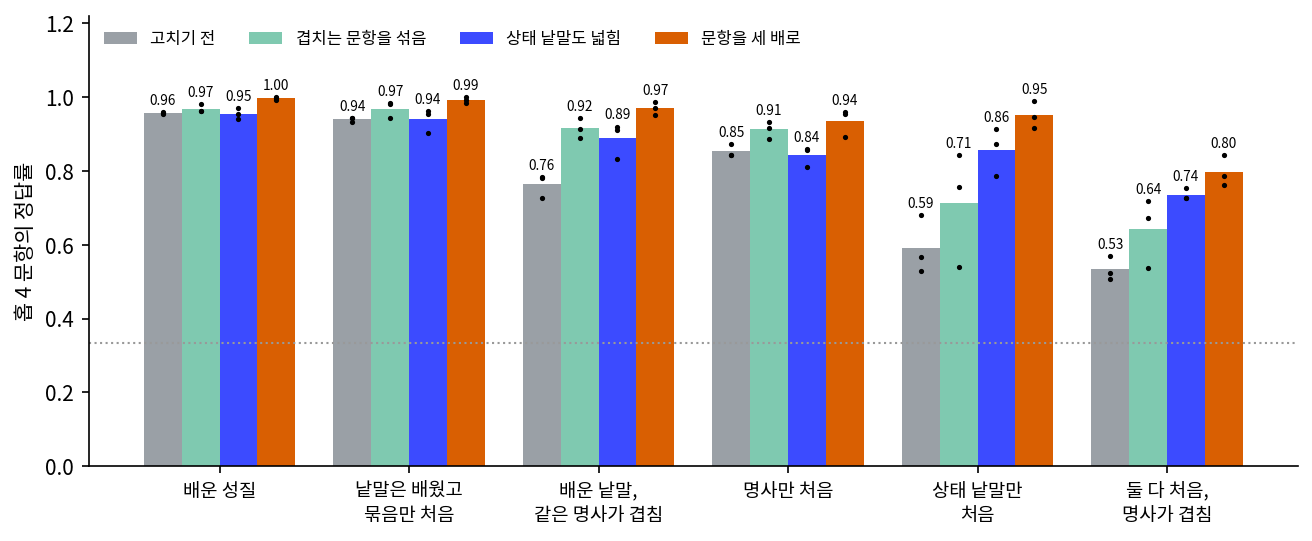
| 판 | 배운 낱말, 명사 겹침 | 상태 낱말만 처음 | 둘 다 처음 | 둘 다 처음의 풀이 전체 |
|---|---|---|---|---|
| 고치기 전 | 76 | 59 | 53 | 14 |
| 겹치는 문항을 절반 섞음 | 92 | 71 | 64 | 24 |
| 상태 낱말도 168 개로 넓힘 | 89 | 86 | 74 | 29 |
| 같은 문항을 15% 로 | 97 | 95 | 80 | 57 |
| 5% 그대로 명사만 383 개로 | 89 | 80 | 67 | 22 |
표의 값은 홉 4 문항에서 측정한 시드 셋의 평균(%)이고, 넣는 양은 넷째 줄만 15%, 나머지는 5% 다. 마지막 칸은 적은 풀이가 정답 풀이와 한 글자도 다르지 않은 비율이다. 겹치는 문항을 섞자 겹침 줄이 76% 에서 92% 로, 상태 낱말을 넓히자 상태 낱말 줄이 71% 에서 86% 로 올라, 서연이 미리 적은 두 줄이 각각 올랐다. 둘 다 처음인 문항은 53% 에서 74% 가 되었다.
미리 적은 줄이 그대로 올랐어. 그럼 이제 세 배를 넣으면?
넷째 줄이 그 답이다. 고친 문항을 15% 로 늘리자 둘 다 처음인 문항이 80%, 풀이 전체가 57% 로 올랐다. 고치기 전에는 세 배를 넣어도 오르지 않던 칸이다. 반대로 넣는 양은 5% 로 두고 명사만 383 개로 넓힌 다섯째 줄은 67% 로 조금 내려갔는데, 낱말이 넓어진 만큼 문항이 더 있어야 하는데 문항 수는 그대로였기 때문이다.
문항 수는 여전히 가장 센 조건이에요. 다만 문항의 구조가 시험과 어긋나 있는 동안에는 아무리 넣어도 그 어긋난 방법을 더 굳힐 뿐이에요. 막는 것을 찾아 고친 다음에야 양이 들어요.
한계 지도를 한 장 더 그린 거네요. 가로축이 문항 수가 아니라 「그 자리에 선 낱말의 가짓수」인 지도.
고친 판의 마지막 시드가 끝난 저녁, 민준은 이 장을 열게 한 루나, 논리 문항 없이 프리트레인한 루나를 다시 불렀다. 규칙 체인을 처음 만들 때 본 홉 3 문항을 그 루나와 풀이 적기 문항 1.5% 를 섞은 루나(둘 다 시드 1)에게 이어 쓰게 하고, 두 줄을 화면에 나란히 띄워 놓고 두 사람을 불렀다(sources/logic-limits/runs_bridge/chain_base_s1.json, chain_c1R_s1.json).
문항: Lucy asks if the bird is big. … Lucy sees that the jar is not open. Sue says   (정답은 no)
  논리 문항 없이 프리트레인한 루나:    the rule says if the cat is not loud, then the bird is not big
  풀이 적기 문항 1.5% 를 섞은 루나:   the jar is not open so the gate is not dry so the cat is not loud so the bird is not big no
윗줄은 규칙을 읽기만 했고, 아랫줄은 따라갔어. 병에서 문, 문에서 고양이, 고양이에서 새. 우리 루나가 한 칸씩 건너간 거야!
징검다리 세 개네요. 다섯 살한테는 꽤 멀리 뛴 거예요.

윗줄도 「the rule says」 하고 따지는 말투는 있어. 딥시크 이야기에서 말투만 배우고 따라가지는 않은 거야. 막고 있던 게 크기도 학습 시간도 아니라 서로 다른 문항의 수였으니까, 문항을 넣자 따라가기 시작했고.
| 측정한 것 | 논리 문항 없는 루나 | 풀이 적기 문항 1.5% 를 섞은 루나 |
|---|---|---|
| 처음 보는 쌍의 홉 4 문항 | 32 / 30 / 35% | 97 / 94 / 96% |
| 그 가운데 cannot 문항 | 0 / 0 / 0% | 92 / 87 / 94% |
| 동화의 바이트당 비트 | 0.6331 / 0.6342 / 0.6357 | 0.6373 / 0.6337 / 0.6366 |
위 표는 시드별 값이고 우연은 33% 다(sources/logic-limits/bridge_summary.out). 낱말 세기로는 34~46% 밖에 나오지 않는 시험이고, 풀이를 적게 하자 필요한 문항이 열 배쯤 줄었다. 다만 루나가 이렇게 따라가는 것은 프로그램이 찍은 글에서다. 둘 다 처음인 낱말의 홉 4 문항은 답 80% 에 풀이 전체 57% 로 풀이를 틀리고 답을 맞힌 문항이 많고, 딥시크에게 같은 규칙 묶음을 아이 둘이 주고받는 이야기로 쓰게 해서(sources/logic-limits/gen_chain_stories.py) 풀이 직전까지 주자 여덟 판이 803 문항에서 12~29% 로 돌아갔다(sources/logic-limits/story_summary.out).