묻는 말에 대답하기: 이어 쓰는 모델에서 답하는 모델로
대화 데이터를 구하거나 만들기
채점하는 법은 정했으니 이제 읽힐 대화가 필요했고, 민준은 먼저 nanochat 이 지도 파인튜닝에 쓰는 데이터를 열어 봤다.
역사: 작은 모델을 위한 대화 데이터
nanochat 의 기본 지도 파인튜닝 데이터는 허깅페이스 팀의 smol-smoltalk 다(tasks/smoltalk.py). 이 팀은 작은 언어 모델 SmolLM2(논문 2025)를 만들면서, 더 큰 대화 데이터 SmolTalk 를 파라미터 10억 개 미만 모델에 맞게 줄였다. 데이터 카드에 적힌 손질은 셋이다. 대화를 더 짧게 했고, 함수 호출처럼 특정 일에 쓰는 데이터와 고쳐 쓰기·요약 예를 줄였고, 어려운 수학 데이터를 뺐다. 작은 모델은 담을 수 있는 양이 적으니 무엇을 넣을지 골라야 한다는 판단이었다. 이 데이터로 파라미터 1억 3,500만 개, 3억 6,000만 개짜리 모델을 지도 파인튜닝했고, 학습 대화 460,341 개와 시험 대화 24,229 개가 있다. 라이선스는 Apache-2.0 이다.
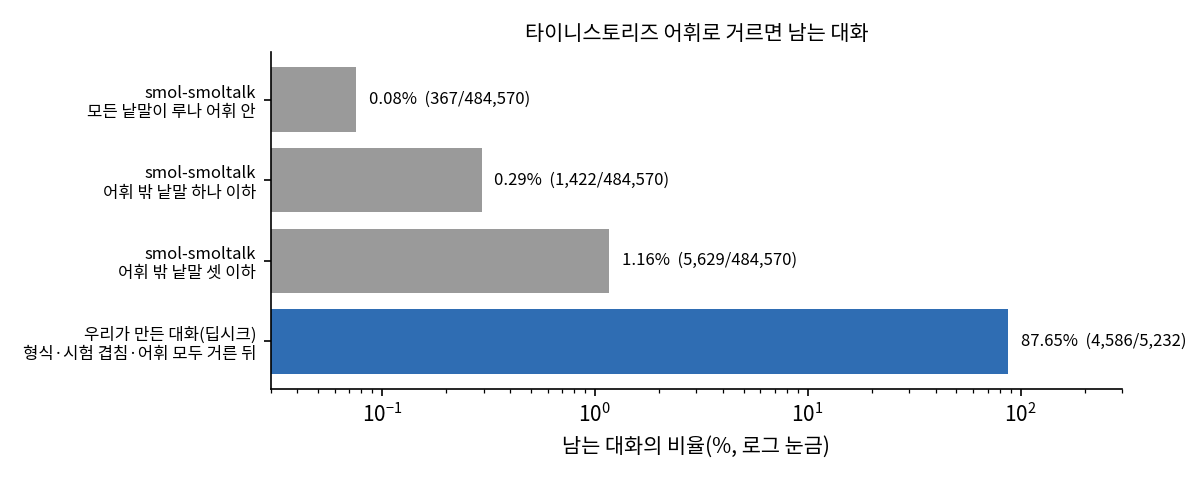
10억 개 미만에 맞췄다는 데이터도 파라미터가 2,760만 개이고 무엇보다 동화 낱말만 아는 루나에게는 크다. 민준이 데이터 전체를 루나 어휘로 걸러 보니, 대화 하나에 어휘 밖 낱말이 중앙값으로 52 개였다(sources/answer/prep_data.out).
모든 낱말이 루나 어휘 안: 367/484,570 = 0.08%
  그 가운데 BPE 4096 글자 줄 형식 512 토큰 이하: 348/484,570 = 0.07%
대화 하나에 어휘 밖 낱말(서로 다른 것) 수: 중앙값 52, 평균 67.1, 90% 135
어휘 밖 낱말이 든 대화 수 상위 20: specific 123,760, function 108,835, data 93,634, essential 92,423, additionally 90,704, …
specific, essential, additionally. 회사 보고서 낱말이네. 동화에는 「additionally」 같은 말이 안 나오지.

348 개로는 학습이 안 되겠다. 어휘 밖 낱말을 몇 개 봐주면?

봐준 낱말은 루나가 한 번도 못 읽은 토큰 조각들이에요. 대답을 배우면서 그 낱말까지 새로 배워야 해요. 우리에게 필요한 건 루나가 읽을 수 있는 대화예요. 동화 데이터를 처음 만든 사람들도 큰 모델에게 아이 낱말로 이야기를 쓰게 했죠. 대화도 그렇게 만들면 돼요. 이렇게 큰 모델에게 써 달라고 해서 만든 학습 글을 합성 데이터(synthetic data)라고 해요. 연구실 서버에 딥시크 모델이 떠 있으니, 게이트웨이 주소를 줄게요.
딥시크에게 동화 낱말로 대화를 주문하기
둘은 선생님이 알려 준 게이트웨이로 연구실 서버의 딥시크에게 대화를 주문했다. 주문서 하나에 대화 열 편이고, 유형은 일곱 가지다: 일상 물음, 짧은 이야기를 주고 묻기, 쉬운 산수, 한 단계 추론, 착한 행동과 마음, 모르는 것을 묻기, 짧은 이야기 부탁. 유형마다 주문서를 번갈아 늘어놓아 513 장을 보냈다. 주문서의 앞부분은 이렇다(각 줄의 원문은 받은 응답 파일의 prompt 칸에 있다).
Write 10 different short chat conversations between a user and an assistant.
Use only very simple words, like the TinyStories dataset (stories for 3-year-old children). Both the user and the assistant must talk this way. A small model that has only read children's stories must be able to read every message.

Rules:
- English only. No slang, no emojis, no markdown, no lists. Write numbers as words.
- The assistant is helpful, kind and honest. Its answers are short, clear and correct.
- Do not give the assistant a name.
- Keep each whole conversation under 250 words.
받은 대화 5,232 편을 차례대로 걸렀다. 형식이 깨진 것(사람으로 시작해 번갈아 말하지 않거나 답으로 끝나지 않는 것) 141 편, 시험 문항과 낱말 여덟 개가 연속으로 겹치는 것 480 편, 루나 어휘 밖 낱말이 든 것 25 편을 빼서 4,586 편이 남았다. 그 가운데 217 편을 개발 대화로 떼어 학습률을 고르는 데만 썼다.
유형마다 601~727 편이 남았다(sources/answer/prep_data.out).
남은 대화는 이런 형태이고, 한 편이 평균 87 토큰이다.
User: I have five books. I put away one book. How many books are out?
Assistant: Four books are out. Five take away one is four.

User: Ann has a small cat. The cat is white. The cat sits on a mat. Ann gives the cat milk. The cat drinks the milk. Where is the cat?
Assistant: The cat sits on a mat.
시험 겹침으로 480 편이나 빠졌네.
동화 낱말로 쓰면 문장이 비슷해지기 쉬워요. 「I have five apples」 같은 문장은 우리 시험에도, 딥시크의 대화에도 나와요. 시험에 그대로 있는 문장을 읽히면 시험이 시험 노릇을 못 하니, 시험에 쓸 것과 읽힐 것은 처음부터 갈라 둬요.
문제 2. 시험 겹침으로 빠진 480 편
거르기에서 시험 문항과 낱말 여덟 개가 연속으로 겹친 대화 480 편을 뺐다. (가) 학교 숙제로 낸 문제가 기말고사에 글자 그대로 나오면 그 시험 점수는 무엇을 측정하는가? (나) 겹친 대화를 빼지 않고 읽혔다가 나중에 그 시험으로 루나를 평가하면, 점수는 루나의 어떤 실력을 부풀릴까? (다) 쉬운 산수 대화가 727 편 남았는데, 루나가 이 데이터만으로 계산을 배울까?

(가)는 실력이 아니라 숙제를 기억하는지를 측정해. 처음 보는 문제를 푸는 힘은 측정 못 하고.
(나)는 시험 문장을 그대로 외운 게 점수에 섞여. 다르게 물어도 맞히는지는 그 점수로 모르고.
그래요. 그래서 겹침은 학습 전에 빼요. (다)는요?

727 편이면 꽤 많은데… 근데 「Four books are out」 같은 답이 다 다른 수잖아. 한 계산을 몇 번이나 보지?
세어 보면 작은 수 계산은 꽤 여러 번 나와요. 학습 대화의 답에 「three take away one」만 49 번 있어요. 그런데 산수 물음 1,380 개 가운데 829 개가 「I have …」처럼 묻는 사람 자신의 이야기로 시작하고, 「Mia has one apple.」처럼 다른 아이의 이야기로 묻는 물음은 둘뿐이에요(~/lm-book-lab/data/sft/answer/train.jsonl). 루나는 계산을 본 적은 있어도 오늘 같은 형태의 물음은 거의 못 봤어요. 대화 데이터는 답하는 형태를 가르치는 재료이고, 산수 실력은 따로 가르쳐야 해요.