묻는 말에 대답하기: 이어 쓰는 모델에서 답하는 모델로
학습과 결과: 동화 실력을 지키며 대답 배우기
출발점은 동화 GPT 체크포인트, 배치는 32 줄이고, 학습률은 개발 대화의 답 손실로 넷을 비교해 0.0001, 600 스텝으로 정했다(sources/answer/sweep_lr*.out).
그다음 두 조건을 시드 셋씩 돌렸는데, 대화만은 배치 32 줄이 모두 대화다. 대화 + 동화는 32 줄 가운데 8 줄을 동화 학습 글에서 뽑은 128 토큰 조각으로 채우고, 그 조각은 모든 칸을 채점한다. 개발 답 손실은 개발 대화 217 편의 답 칸 토큰당 손실(nat)이고, 바이트당 비트는 검증 글 전체에서 측정했다. 학습 하나는 RTX 4090 한 장에서 17초가 걸렸다.
조건               시드      개발 답 손실      바이트당 비트     초
대화만               1       0.7550       0.5541    17
대화만               2       0.7461       0.5533    17
대화만               3       0.7581       0.5541    17
대화 + 동화 1/4       1       0.7857       0.4404    17
대화 + 동화 1/4       2       0.7739       0.4407    17
대화 + 동화 1/4       3       0.7829       0.4406    17

학습 전(0 스텝) 개발 답 손실 2.7244
시드마다 (섞기 − 대화만): 답 손실 +0.0307, +0.0278, +0.0249 | 바이트당 비트 -0.1137, -0.1126, -0.1136
(sources/answer/summary.out)
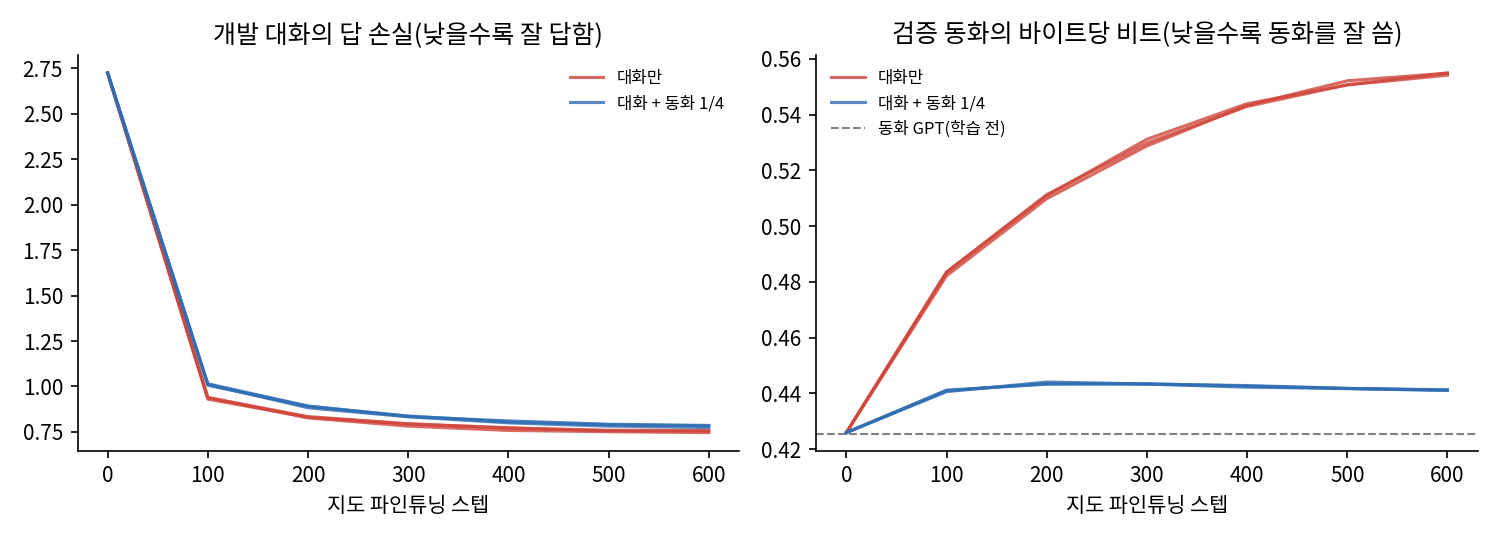
대화만 읽힌 루나는 답 손실이 2.72 에서 0.75 안팎으로 내려간 대신, 동화의 바이트당 비트가 0.4253 에서 0.553~0.554 로 나빠졌다. 동화를 4분의 1 섞은 루나는 답 손실이 0.774~0.786 으로 0.025~0.031 높고, 동화는 0.440~0.441 로 거의 지켰다. 시드 셋 모두 같은 쪽으로 갈렸다. 다만 섞은 루나는 한 배치에서 읽는 대화가 32 편이 아니라 24 편이어서, 답 손실의 차이에는 대화를 덜 읽은 영향도 들어 있다.
같은 물음 여섯을 동화를 섞은 시드 1 에 다시 넣은 답이다.
  Q: What sound does a duck make?
  A: 'A duck makes a sound. It sounds like a duck.'
  Q: Why do we wear coats?
  A: 'We wear a coat to stay warm. A coat keeps us warm.'
  Q: Which is bigger, a mouse or a horse?
  A: 'A horse is bigger. A horse has a big body. A mouse has a small body.'
  Q: Sam had three apples. He ate one. How many apples does Sam have now?
  A: 'Sam has three apples now. Three apples take away one apple is three apples.'
  Q: What should you do if your friend is sad?
  A: 'You should say, I am sorry. I can help you with a sad day.'
  Q: Can you tell me a short story about a frog?
  A: 'A frog sits on a log. The log is near a pond. The frog sees a fly. The frog jumps up. The frog gets the fly. The frog jumps down. The frog is happy.'
이제 물음마다 한두 문장으로 답하고 답을 다 쓰면 멈추며, 외투 물음과 말·쥐 물음에는 맞게 답했다. 오리 물음에는 「오리는 오리 같은 소리를 낸다」고 얼버무렸고, 사과 물음에는 「3 빼기 1 은 3」이라고 했다.
말과 쥐의 답이 뜨자 민준은 한동안 화면을 내리지 않았다.
「A horse is bigger.」 물은 것에 물은 것만 답했어. 오리를 만들러 연못에 가지도 않고.

네가 설정서 쓸 때 그랬잖아. 묻는 말에 딴소리 안 하고 대답한다고.

…그 줄이 처음으로 움직였네.
동화를 쓰게 하면 두 조건의 차이가 보인다. 아래는 같은 시작 문장과 같은 시드로 뽑은 글이다.
[대화만 시드 1] Once upon a time, there was a little girl named Lily. She had a small box. She put a toy bear in the box. She did not know what was in the box. So she opened the box.\nBut the box was empty. There was no toy bear. …
[대화 + 동화 시드 1] Once upon a time, there was a little girl named Lily. She loved to learn new things every day. Her mom and dad were very smart. … She gave the cat some food and water. The cat was very happy and started to purr. …
대화만 읽힌 루나의 동화는 대화의 답처럼 짧은 문장이 되풀이되고, 상자에 넣은 곰 인형이 사라졌다가 다시 나온다. 섞은 루나는 동화의 말투를 지켰다.

대답은 하는데… 루나 같지가 않아. 「A duck makes a sound」 라니.
누구 말투도 아니니까. 이름 없는 도우미 말투로 쓴 대화를 읽혔잖아.

오늘 배운 건 묻는 말에 답하는 형태가에요. 누구로서 답할지, 어떤 말투로 답할지는 그다음 일이에요. 그리고 사과 물음은 형태만 맞았지 계산은 틀렸어요. 답하는 법과 계산하는 실력은 따로 가르쳐야 해요.
개발 대화가 학습 대화와 겹쳐 있었다
다음 날 서연은 거르기 때 시험 문항과 겹친 대화를 뺀 것처럼, 개발 대화도 학습 대화와 겹치는지 세어 보았다. 개발 대화 217 편의 물음 408 개 가운데 160 개가 학습 대화의 물음과 글자까지 같았고, 개발 대화를 만든 주문 178 개는 모두 학습 대화를 만든 주문이기도 했다(sources/answer/split_v2.out). 같은 주문서로 받은 대화를 편 단위로 무작위로 나눴기 때문이다.
그럼 0.75 는 루나가 외운 물음까지 맞힌 점수였어?
열 문제 가운데 네 문제는 문제집에서 그대로 나온 시험이었던 거지.
그래서 시험에 쓸 것과 읽힐 것은 처음부터 갈라 둬요. 이번에는 주문 단위로 갈라 봐요.
서연은 주문 510 개 가운데 34 개로 받은 대화만 개발로 떼고, 개발 물음과 같은 물음이 든 학습 대화 1,002 편을 뺐다. 이 판 2 는 학습 3,277 편, 개발 277 편이고, 개발 물음 548 개 가운데 학습 물음과 글자까지 같은 것은 없다. 학습률과 스텝도 판 2 의 개발 대화로 다시 골랐다. 학습률은 0.0001 그대로였지만, 개발 답 손실이 가장 낮은 곳은 600 스텝이 아니라 300 스텝 근처였고 그 뒤로는 다시 올랐다(sources/answer/v2_sweep_lr*.out). 판 1 에서는 외운 물음의 손실이 계속 내려가면서, 처음 보는 물음에서 손실이 다시 오르는 것을 가리고 있었다.
판 2(학습률 0.0001, 300 스텝)   시드   개발 답 손실   바이트당 비트(검증 글 전체)
대화만                            1      1.0580        0.5043
대화만                            2      1.0575        0.5043
대화만                            3      1.0584        0.5064
대화 + 동화 1/4                   1      1.1043        0.4381
대화 + 동화 1/4                   2      1.0996        0.4380
대화 + 동화 1/4                   3      1.0951        0.4381
학습 전 개발 답 손실 2.9180
(sources/answer/v2s300_mix*_s*.out)
겹침을 걷어 내자 답 손실은 0.75 안팎이 아니라 1.06 안팎이었다. 두 조건이 갈린 방향은 판 1 과 같다. 동화를 섞은 루나는 답 손실이 시드마다 0.037~0.046 높고, 동화의 바이트당 비트는 0.438 로 대화만 읽힌 루나(0.504~0.506)보다 낫다. 다만 600 스텝까지 학습하면 대화만 읽힌 쪽이 먼저 학습 대화에 오버피팅해 답 손실의 순서가 뒤집혔다(대화만 1.077~1.082, 섞음 1.053~1.057, sources/answer/v2_mix*_s*.out). 동화를 섞어 치르는 값이 얼마인지는 어디서 멈추느냐에 달렸다.
이 장의 뒤와 다음 실습들이 쓰는 루나는 판 1 의 학습 대화 4,369 편을 600 스텝 읽은 체크포인트다. 그 루나가 처음 보는 물음에 내는 답 손실은 0.75 보다 판 2 의 1.06 안팎에 가깝다고 읽어야 한다.
문제 3. 동화를 섞으면 대답을 덜 배우나
겹침을 걷어 낸 판 2 에서 동화를 4분의 1 섞은 루나는 개발 답 손실이 시드마다 0.037~0.046 높았고, 동화의 바이트당 비트는 0.066~0.068 낮았다. (가) 한 학기 동안 수학 학원만 다니고 책을 한 권도 안 읽은 아이와, 학원을 조금 줄이고 책을 계속 읽은 아이를 떠올려 보자. 무엇을 얻고 무엇을 잃었나? (나) 섞은 쪽은 배치에서 대화를 24 편만 읽었다. 답 손실의 차이가 「동화를 섞어서」인지 「대화를 덜 읽어서」인지 가르려면 무엇을 더 돌려야 할까? (다) 대화만 읽힌 루나의 동화가 나빠진 이유을 손실을 매긴 칸으로 설명하라.
(가)는 수학만 한 애가 수학 문제는 조금 더 잘 풀겠지만, 읽던 실력이 떨어져. 책을 계속 읽은 애는 수학이 조금 덜 늘고 읽기는 지키고.
(나)는… 섞은 쪽 스텝을 32 분의 24 만큼 늘려서 대화를 똑같이 읽게 하고 다시 측정하면 되겠다. 그래도 답 손실이 높으면 동화 탓이고.
그래요. 오늘 표만으로는 동화를 섞은 영향과 대화를 덜 읽은 영향을 가르지 못해요. 그래서 본문에도 「대화를 덜 읽은 영향도 들어 있다」고 적었어요. (다)는요?
대화만 읽힐 때는 답 칸만 채점하니까, 동화 같은 긴 글을 맞히는 손실이 한 칸도 없어. 동화를 잘 써도 손실이 줄지 않으니까, 파라미터가 답을 쓰는 방향으로만 끌려가.
맞아요. 섞은 조각은 모든 칸을 채점하니까, 동화를 쓰는 실력에도 계속 손실이 걸려요.