묻는 말에 대답하기: 이어 쓰는 모델에서 답하는 모델로
지도 파인튜닝: 대화의 형태와 답 칸만 채점하기
지도 파인튜닝도 다음 토큰을 맞히고 크로스 엔트로피 손실을 줄이는 방향으로 파라미터를 고친다는 점에서 학습 루프는 프리트레인과 같다. 바뀌는 것은 읽히는 글의 형태와 손실을 매기는 칸, 이렇게 두 가지다.
글의 형태. 대화 한 편을 글자 줄로 이어 붙인다. 사람의 말 앞에는 「User:」, 루나의 말 앞에는 「Assistant:」를 붙이고 줄을 바꾼다. 맨 앞과 맨 끝에는 동화를 읽힐 때와 같은 문서 경계 토큰 <|endoftext|> 를 둔다. 새 특수 토큰은 더하지 않았는데, 루나가 이미 아는 글자들로 차례를 표시하므로 어휘와 임베딩 행렬을 고칠 필요가 없기 때문이다.
채점하는 칸. 대화에는 사람이 쓴 물음과 루나가 쓸 답이 섞여 있는데, 루나가 나중에 할 일은 답을 쓰는 것뿐이니 답 칸에서만 손실을 매긴다. 크로스 엔트로피는 정답 자리에 -100 이 들어간 칸을 건너뛰므로, 물음 칸의 정답을 -100 으로 바꾸면 된다.
# sources/answer/sft.py 의 encode_dialog (발췌)
ids, lab = [EOT], [-100]
for j, x in enumerate(msgs):
    last = j == len(msgs) - 1
    if x["role"] == "user":
        t = tok.encode_ordinary("User: " + x["content"].strip() + "\n")
        ids += t
        lab += [-100] * len(t)                       # 물음 칸은 채점하지 않는다
    else:
        head = tok.encode_ordinary("Assistant:")
        body = tok.encode_ordinary(" " + x["content"].strip() + "\n") + ([EOT] if last else [])
        ids += head + body
        lab += [-100] * len(head) + body             # 답 글과 줄바꿈(마지막 차례는 문서 끝까지)만 채점
return ids[:-1], lab[1:]                             # 다음 토큰을 정답으로 한 칸 민다
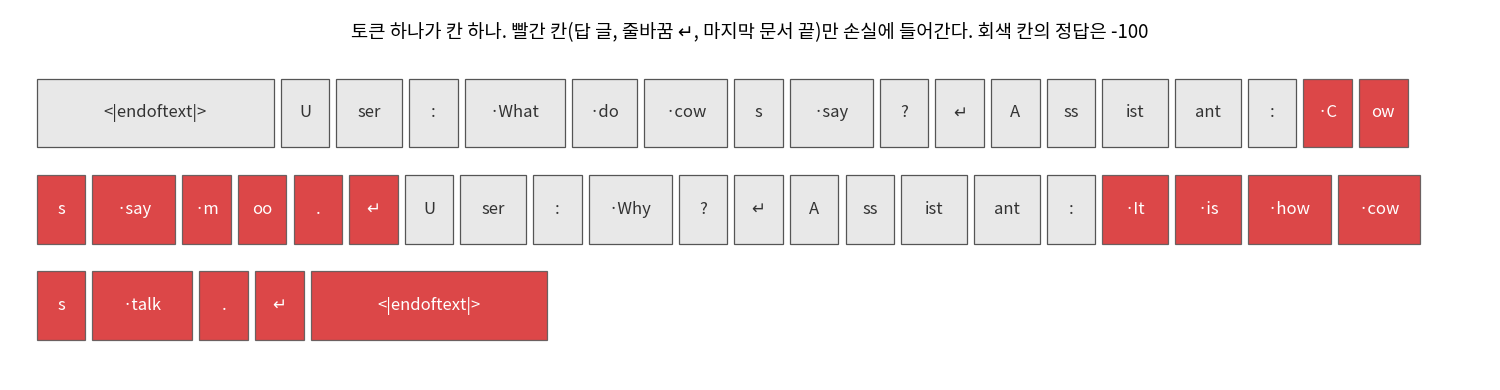
마지막 답 뒤의 <|endoftext|> 도 채점하는데, 답을 다 쓰면 문서를 끝내는 법까지 배워야 대화에서 루나가 답 하나를 쓰고 멈추기 때문이다.
문제 1. 받아쓰기 시험지는 어디를 채점하나
(가) 선생님이 불러 준 번호와 아이가 쓴 낱말이 함께 적힌 받아쓰기 시험지에서, 선생님은 어느 칸에 동그라미를 칠까? (나) 위 그림의 대화는 토큰 44 개이고 채점하는 칸은 17 개다. 한 스텝에서 이 대화가 손실에 보태는 칸은 몇 퍼센트인가? 같은 길이의 동화 조각이라면 몇 퍼센트인가? (다) 마지막
<|endoftext|>를 채점에서 빼면 루나는 대화에서 무엇을 못 하게 될까?

(가)는 낱말 칸이지. 번호는 선생님이 불러 준 거니까 채점할 게 없어.

(나)는 17 ÷ 44 니까 39% 쯤. 동화 조각은 모든 칸을 채점하니까 100% 고.

그래요. 같은 토큰 수를 넣어도 대화는 손실에 들어가는 칸이 적어요. (다)는요?

아, 끝내는 법을 못 배워. 답을 쓰고 나서 「User:」를 혼자 써 버리거나, 동화처럼 계속 이어 쓰겠다.
맞아요. 그래서 끝 토큰도 루나가 써야 할 글에 넣어 채점해요.