묻는 말에 대답하기: 이어 쓰는 모델에서 답하는 모델로
물음까지 채점하면: 어느 칸을 채점하느냐가 배우는 것을 정한다
대화만 읽힐 때와 동화를 섞을 때를 비교하고 나서 서연은 「답 칸만」이라는 말에 다시 줄을 그었다.

그런데 답 칸만 채점하는 게 꼭 지켜야 하는 규칙이에요? 물음 쪽에 새 사실이 적혀 있으면 물음 칸은 채점하지 않으니까 루나가 못 배울 것 같은데요.

꼭 그래야 하는 건 아니에요. axolotl 같은 파인튜닝 도구도 물음까지 채점할지를 설정(train_on_inputs)으로 남겨 둬요. 제가 만들어 둔 작은 연습 데이터로 두 방법을 나란히 돌려 봅시다.
연습 데이터는 선생님이 수업용으로 만든 것이라 차례 표시가 「User:/Assistant:」가 아니라 「Student:/Teacher:」인데, 물음 차례 다음에 답 차례가 오는 생김새는 같다. 지어낸 아이 Ilva 와 Lorcan 의 사실 열 개(반려동물, 좋아하는 음식, 사는 곳, 좋아하는 색, 좋아하는 일)로 만들었다. 두 이름은 타이니스토리즈에 한 번도 나오지 않는다. 답에 사실 데이터는 「Student: What is Ilva’s pet?」 다음 「Teacher: duck.」처럼 답이 사실을 말하고(60 줄), 물음에 사실 데이터는 「Student: Ilva’s pet is a duck. Is that nice?」 다음 「Teacher: yes.」처럼 사실이 물음에만 있다(480 줄). 채점은 답 칸만과, 물음 글과 차례 표시까지 넣는 모든 칸 두 가지다. 같은 동화 GPT 에서 학습률 0.0001, 1,000 스텝, 시드 다섯으로 돌리고, 학습 때와 같은 형태의 물음 시험과 처음 보는 문장 뒤의 값을 고르는 빈칸 시험(둘 다 보기 여덟, 아무렇게나 골라도 12.5%), 그리고 빈 시작에서 뽑은 글이 물음부터 쓰는 비율을 측정했다(sources/sft-mask/summary_practice.out, 시드 다섯의 평균 [가장 낮은 값, 가장 높은 값]).
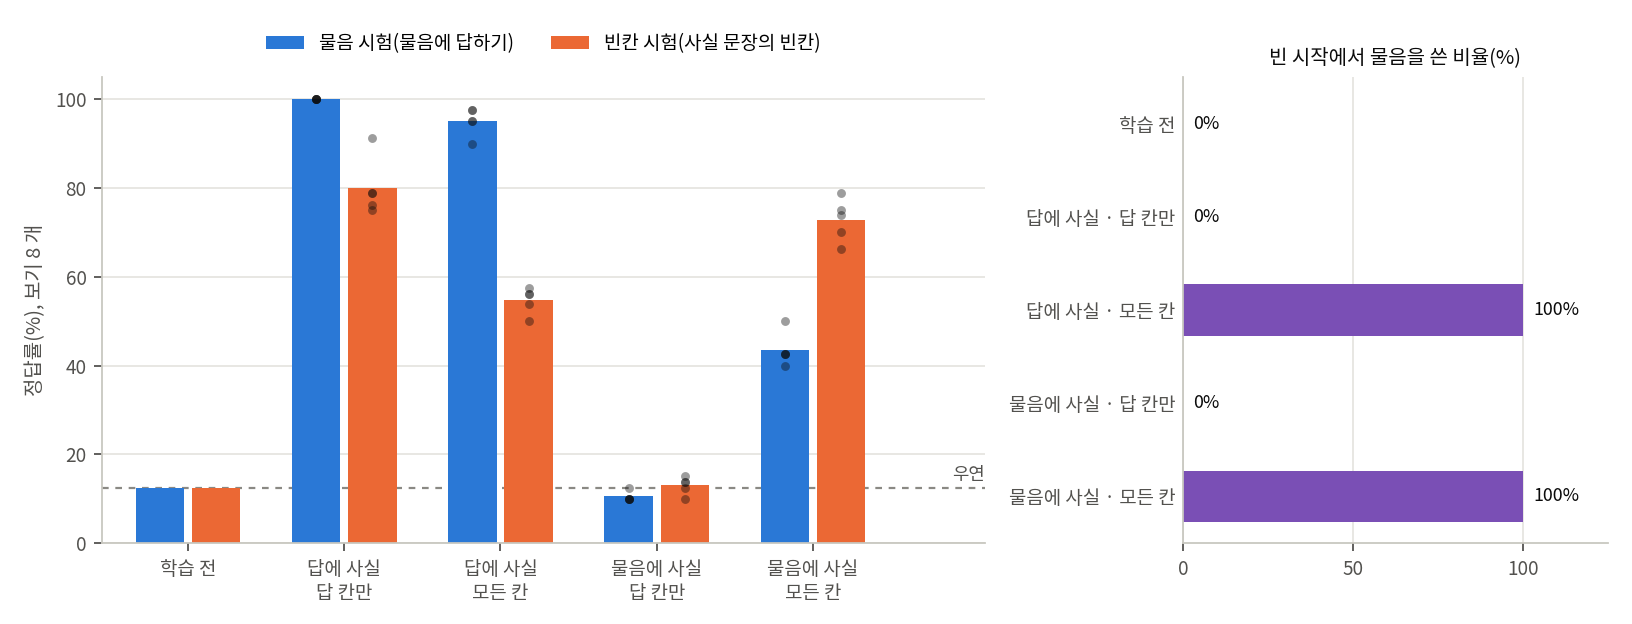
| 데이터 | 채점 | 물음 시험 | 빈칸 시험 | 빈 시작에서 물음을 쓴 비율 |
|---|---|---|---|---|
| (학습 전) | 12.5 | 12.5 | 0% | |
| 답에 사실 | 답 칸만 | 100.0 [100.0, 100.0] | 80.0 [75.0, 91.2] | 0% |
| 답에 사실 | 모든 칸 | 95.0 [90.0, 97.5] | 54.8 [50.0, 57.5] | 100% |
| 물음에 사실 | 답 칸만 | 10.5 [10.0, 12.5] | 13.0 [10.0, 15.0] | 0% |
| 물음에 사실 | 모든 칸 | 43.5 [40.0, 50.0] | 72.8 [66.2, 78.8] | 100% |
빈 시작에서 뽑은 글은 이렇다(sources/sft-mask/samples_practice.out, 시드 0, 온도 0.8, 문서 끝 토큰은 보이지 않아 글이 이어 붙어 있다).
P_A_answer_s0  빈 시작 → 'Once upon a time, there was a little girl.Once upon a time, there was a green bug.Once upon a time, there'
P_A_full_s0    빈 시작 → 'Student: What color does Lorcan pick?\nTeacher: orange.Student: What is'

물음에만 적힌 사실은 답 칸만 채점하면 하나도 안 들어오네. 빈칸 시험 13.0% 면 학습 전 12.5% 랑 같아. 여덟 개에서 아무렇게나 고른 거랑 같고.

채점하지 않는 칸에서는 그래디언트가 나오지 않아요. 물음 칸의 사실은 모델이 읽기만 하고 맞히려고 애쓸 일이 없어요. 물음까지 채점하면 같은 사실이 72.8% 까지 들어와요.

그 대신 모든 칸을 채점한 쪽은 빈 데서 「Student:」 부터 써요. 아무도 안 물었는데 학생 차례를 혼자 지어내고 거기에 답까지 해요.
물음과 차례 표시도 맞혀야 할 글이 되었으니까요. 대화하는 루나라면 사람이 말할 차례에 루나가 물음을 대신 써 버려요. 그리고 사실이 답에 있을 때는 답 칸만 채점한 쪽이 처음 보는 문장의 빈칸 시험에서도 더 잘 맞혔어요. 80.0% 대 54.8% 로, 시드 다섯의 범위가 겹치지 않아요.

물음 쪽에 사실을 둔 데이터는 모든 칸을 채점해도 물음 시험이 43.5% 밖에 안 되네요.
그 데이터의 답은 늘 yes, no, 수였으니까요. 사실을 읽기는 했어도 그 사실을 답으로 말해 본 적이 없어요.

그럼 답 칸만 채점하는 건 계산을 아끼려고 하는 거예요?
이 데이터에서는 아니에요. 한 스텝이 답 칸만 7.98 ms, 모든 칸 8.07 ms 였고 세 번 측정한 범위가 겹쳐요(sources/sft-mask/timing_practice.out). 어느 칸을 채점하느냐가 모델이 무엇을 쓰는 법을 배우는지를 정해요. 그래서 루나가 알아야 할 사실은 대화 데이터를 만들 때 답 쪽에 적어요.